上线第一天用户白屏了你却最后一个知道:vibe 项目的错误监控与崩溃上报实战
每个 vibe 项目都会经历同一个黑色幽默时刻:网站白屏了,朋友比你的监控先告诉你。这篇实战为一人团队搭建完整错误监控体系:5 分钟 Sentry 最小闭环、错误边界、上报上下文设计、后端结构化日志、AI 调用专项防护、告警分级降噪,最后附上线检查清单。
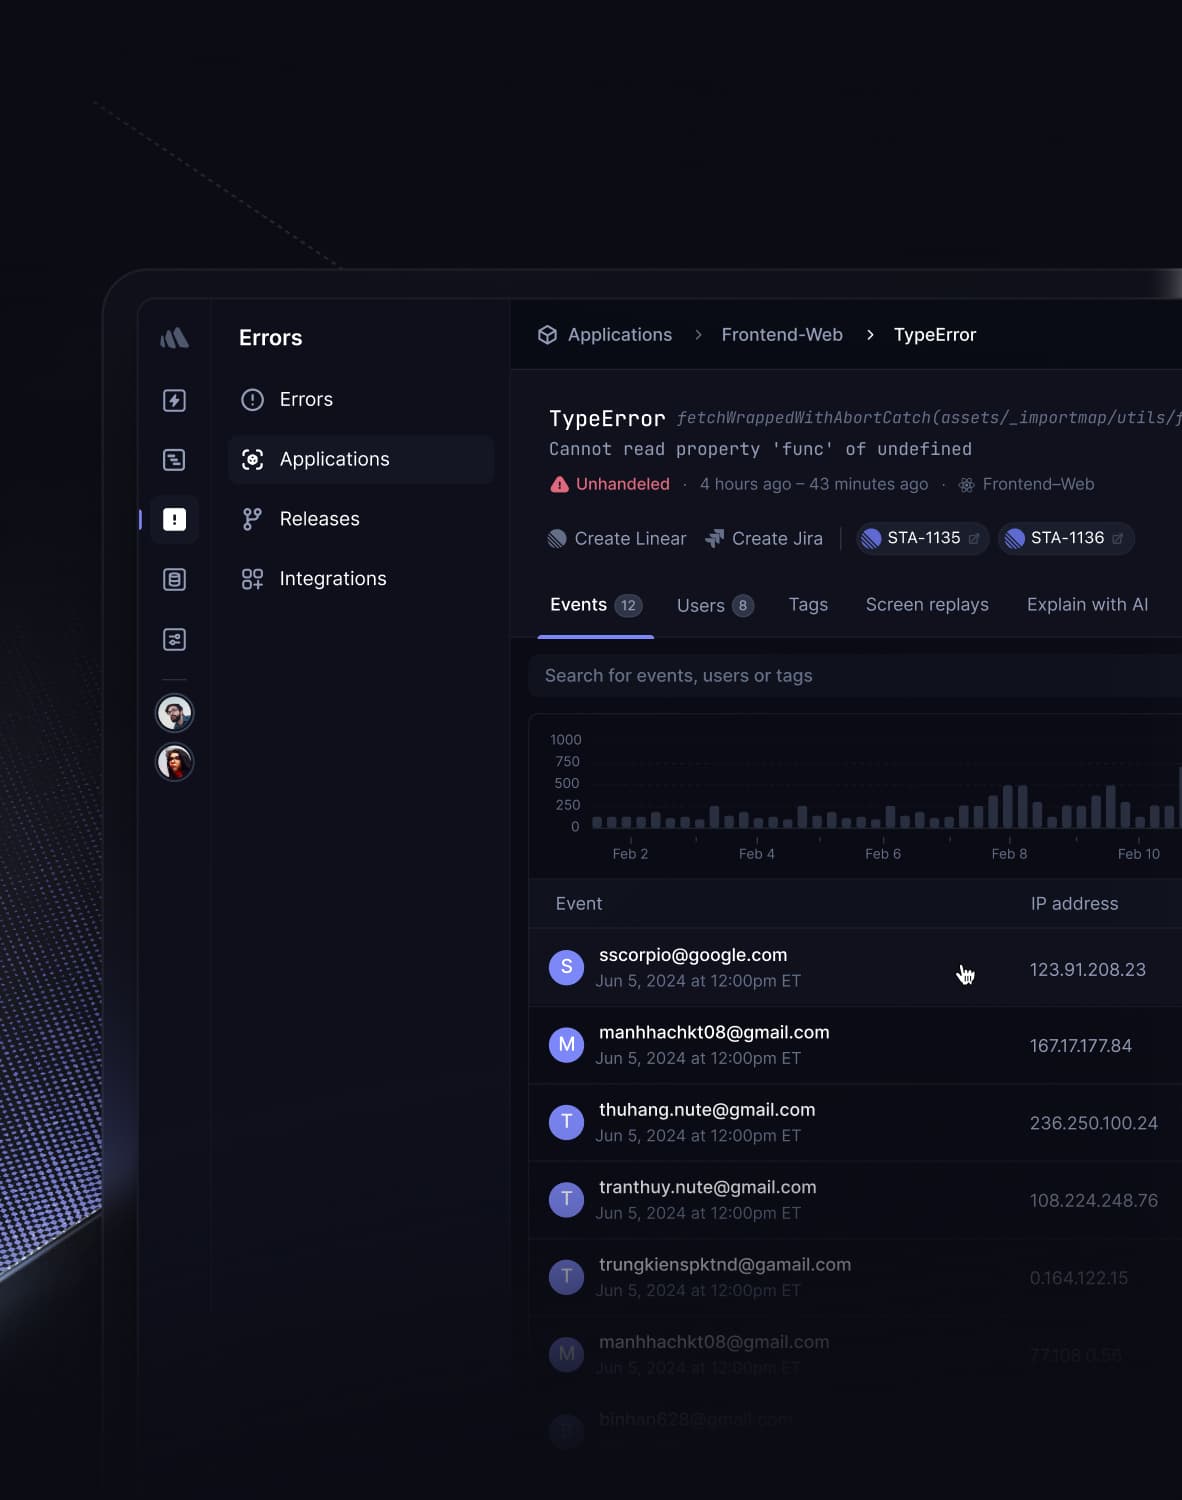
每个 vibe 项目都会经历同一个黑色幽默时刻:你兴高采烈地把链接发到朋友圈,半小时后朋友私信你——「你网站白屏了」。你打开一看,真白屏了。而你,项目的作者、全世界最关心这个网站的人,是最后一个知道的。
AI 帮你 10 分钟搭出了登录、支付、列表页,但它不会主动告诉你一件事:它默认没有给你装任何错误监控。console 里飘红的错误只存在于你自己的浏览器里,生产环境的用户遇到崩溃,只会默默关掉标签页——你连「有多少人遇到」都不知道,更别说「错在哪一行」。
错误监控是 vibe 项目从「玩具」到「产品」的分水岭。它不产生任何用户可见的功能,却决定了你能不能睡安稳觉。这篇实战的目标是:给你一套一人团队也能落地的错误监控体系——从 5 分钟最小闭环,到上报内容设计、告警分级、AI 调用专项防护,最后附一份上线检查清单。
先建立心智模型:错误监控是三层,不是装个 SDK
很多人以为错误监控 = 装 Sentry。其实完整的链路有三层,缺一层就断:
1. 捕获(Capture):错误发生时,有没有代码把它拦下来。前端是错误边界 + 全局监听,后端是未捕获异常处理器。没有这一层,错误直接消失,连上报的机会都没有。
2. 上报(Report):把错误发到一个你能查到的地方,附带足够的上下文(哪个版本、哪个用户、哪一步操作)。上报不是「把堆栈扔过去就行」——没有上下文的堆栈,只是一串看不懂的地址。
3. 响应(Respond):错误来了之后,谁看、多久看、什么算严重。没有响应机制的监控,等于把烟雾报警器装在没人住的房子里——响了也白响。
还有一个关键区分:错误监控 ≠ 日志。日志回答「系统在干什么」,错误监控回答「系统哪里坏了、影响了多少人」。日志是给开发排查时翻的,错误监控是主动推到你面前的。一个 vibe 项目可以日志很简陋,但不能没有错误监控——因为前者是你去找问题,后者是问题来找你。
第一步:5 分钟最小闭环,先让错误「看得见」
别一上来就设计完美体系。先花 5 分钟把最小闭环跑通:错误发生 → 自动上报 → 你收到通知。闭环跑通之后,再慢慢加料。
对 vibe 项目最省事的方案是 Sentry(免费额度每月 5000 个错误事件,个人项目基本够用)。Next.js 项目一行命令:
npx @sentry/wizard@latest -i nextjs向导会自动生成 sentry.client.config.ts、sentry.server.config.ts 和 sentry.edge.config.ts——分别管浏览器端、服务端和 Edge Runtime。注意检查它有没有给你开 source map 上传:没有 source map,你收到的堆栈全是 app-3f2a1c.js:1:23456 这种压缩后的行号,等于没报。向导默认会配,但 AI 生成的老项目里经常缺这一项,手动确认 next.config.ts 里有 withSentryConfig 包裹。
三个配置项,上线前必须设对:
1. DSN 走环境变量,别硬编码。 AI 生成的代码经常把 DSN 直接写进配置文件——DSN 虽然不是高危密钥(它是上报入口,不是读取密钥),但换项目、换环境时硬编码就是坑。SENTRY_DSN 放环境变量,不同环境用不同的 Sentry project 区分。
2. release 和 environment 必须打标。 每次部署带上 git commit sha 作为 release,环境区分 production/staging。不打标的后果:你收到一个错误,完全不知道是线上还是你本地调试时触发的——vibe coder 本地跑 dev 模式触发的错误污染线上数据,是最常见的乌龙。
3. 采样率先设 1.0,上线稳定后再降。 tracesSampleRate 是性能追踪的采样,错误事件本身(error events)不受采样影响、全量上报。很多教程一上来就教你设 0.1 采样——那是给日活百万的项目省钱的,你的项目先全量,看到真实错误量再说。
前端:错误边界是底线,全局监听是兜底
React/Next.js 项目里,AI 最爱犯的错是:一个组件抛错,整页白屏。用户看到的不是「某个卡片加载失败」,而是整个应用没了。修法是错误边界——React 官方推荐了十年的东西,AI 生成的代码里却经常缺席。
Next.js App Router 项目,在关键路由段放一个 error.tsx:
// app/dashboard/error.tsx
'use client';
export default function Error({ error, reset }: {
  error: Error & { digest?: string };
  reset: () => void;
}) {
  return (
    <div>
      <h2>这个模块开小差了</h2>
      <p>我们已经记录了这个问题,工程师正在处理。</p>
      <button onClick={reset}>再试一次</button>
    </div>
  );
}
注意 'use client' 是必须的——错误边界只能是客户端组件。放的位置有讲究:按「故障域」放,比如 dashboard 下放一个、settings 下放一个,而不是全站只放一个根 error.tsx。全站一个边界等于没隔离:侧边栏崩了,整个后台都白屏。
错误边界拦的是渲染错误,拦不住这些:异步回调里的错误、事件处理器里的错误、资源加载失败。所以还要两道全局兜底,写在应用入口:
window.addEventListener('error', (e) => {
  // 资源加载失败(图片/脚本 404)走这里,e.error 为空
  reportError({ type: 'resource', target: (e.target as HTMLElement)?.tagName, src: (e.target as HTMLImageElement)?.src });
});
window.addEventListener('unhandledrejection', (e) => {
  // 没 catch 的 Promise:AI 生成的 async 代码重灾区
  reportError({ type: 'unhandledrejection', reason: String(e.reason) });
});
unhandledrejection 值得单独强调:AI 生成的 async/await 代码,十个有九个漏了 catch。它不写 try/catch,你也不检查,Promise 静默失败,用户点了按钮没反应、页面没报错——这种「静默坏掉」比白屏更可怕,因为监控都抓不到(除非你有这道监听)。
上报什么:没有上下文的堆栈等于没报
最小闭环跑通后,下一个要解决的是上报质量。收到 100 条 TypeError: Cannot read properties of undefined 却不知道用户在干什么、哪个版本、复现路径——这种监控只是「心理安慰型监控」。
每条错误上报,至少要带这四样上下文:
1. 面包屑(Breadcrumb):错误发生前用户做了什么。 Sentry 会自动记录点击、导航、console 输出,但 AI 场景下的关键操作要手动埋:比如「用户点击了生成按钮」「第 3 次重试」。做法是在关键节点调 Sentry.addBreadcrumb。复现一个 bug 需要的不是堆栈,是「用户先点了 A,再输了 B,然后崩了」——面包屑就是干这个的。
2. 用户标识:脱敏的 ID,不要邮箱。 设 Sentry.setUser({ id: userId }) 就够了。千万别把邮箱、手机号、真实姓名塞进上报——错误监控平台是第三方 SaaS,你的用户数据会躺在别人的服务器上。vibe 项目最容易踩的坑:AI 生成的 setUser({ email, name, ...wholeUserObject }),把整个用户对象(包括 token)都发上去了。上线前全局搜一遍上报调用,确认没有 PII。
3. 版本与环境:release + environment。 前面说过,不再赘述。补充一点:发版后错误量突增,第一反应应该是「回滚」,不是「修 bug」——而你能做这个判断,前提是上报里能按 release 分组对比。
4. 业务标签:给错误打上「哪块业务」。 比如 Sentry.setTag('feature', 'checkout')。100 个错误里,支付链路的 1 个比营销页的 99 个都重要——没有业务标签,你只能按数量排序,永远在修不重要的 bug。
还有一个反直觉的建议:主动上报「业务异常」,别只报代码异常。比如「用户连续 3 次支付失败」「AI 生成超时 5 次」——这些不是 JS 错误,不会自动捕获,但对你更重要。用 Sentry.captureMessage('payment_failed_3x', 'warning') 主动埋点。vibe coder 的误区是只监控「程序崩没崩」,不监控「业务坏没坏」。
后端:结构化日志 + traceId 贯穿 + 进程别悄悄死
前端监控很多人会做,后端经常裸奔。AI 生成的 Node/Python 后端,错误处理通常是这个水平:console.log(err),或者干脆没有。生产环境出问题,你 ssh 上去翻日志,发现只有一句 Error: Request failed——哪个用户、哪个请求、哪一步,全不知道。
后端错误监控的三件套:
1. 结构化日志,JSON 格式。 别再 console.log('user login failed', err) 了,改成 logger.error({ event: 'login_failed', userId, reason: err.message })。纯文本日志在出问题时只能人肉 grep,JSON 日志可以直接按字段过滤。pino(Node)或 structlog(Python)都是零配置起步。
2. traceId 从网关贯穿到数据库。 一个请求进来就生成唯一 ID,透传给每个下游调用(包括 LLM API 调用),所有日志都带上它。用户报「刚才支付失败了」,你拿着 traceId 一搜,前端点击、后端校验、支付网关回调、数据库写入全串起来了。没有 traceId 的微服务日志,就是一盘散沙——哪怕你的「微服务」只是前后端分离。
3. 未捕获异常不能让进程悄悄死。 Node 服务必须有:
process.on('uncaughtException', (err) => {
  logger.fatal({ err }, 'uncaught exception, shutting down');
  // 先上报,再退出——别让进程带着未知状态继续跑
  setTimeout(() => process.exit(1), 1000).unref();
});
process.on('unhandledRejection', (reason) => {
  logger.fatal({ reason }, 'unhandled rejection, shutting down');
  setTimeout(() => process.exit(1), 1000).unref();
});关键点:上报完再退出,让进程管理器(PM2/Docker/K8s)重启一个干净的进程。最怕的是「异常被吞了,进程带着一半初始化的状态继续服务」——这种半死不活的服务,错误是间歇性的,查起来最痛苦。配合健康检查(/healthz),让编排器自动把坏实例摘掉。
AI 调用专项:vibe 项目独有的故障面
普通项目的错误监控指南到上面就结束了,但 vibe 项目有个独有的故障面:LLM 调用本身。它不像数据库——挂了就报错;LLM 的失败是「软失败」:超时、截断、幻觉、配额用完,每一种都需要专门处理。
1. 超时必须设,而且要分层。 LLM API 调用设 60-120 秒超时(流式输出用首 token 超时 15 秒 + 总超时)。AI 生成的代码经常不设超时——上游模型服务一抖,你的请求线程全被 hang 住,整个服务被拖死。更隐蔽的是:前端 fetch 也要设超时(AbortController),否则用户看到的一直是 loading 转圈。
2. 重试要有退避和上限,最多 3 次。 429(限流)和 5xx 才重试,4xx(除了 429)不重试——参数错了重试 100 次也没用。退避用指数退避 + 抖动(1s、2s、4s ± 随机),避免重试风暴把刚恢复的服务又打挂。每次重试都记一条 warning 日志,方便事后看「重试成功率」。
3. 降级策略:贵模型挂了,切便宜模型。 主力模型(比如最强的那个)超时/5xx 两次后,自动降级到便宜一档的模型继续服务,并在日志里打标 model_fallback: true。用户得到一个「稍弱但可用」的回答,总比转圈超时强。降级是产品决策不是技术细节:提前想好哪些场景允许降级(聊天续写可以,代码生成不行)。
4. 预算熔断:给 AI 调用设 spending 上限。 这是 vibe 项目的血泪教训:某个 bug 导致无限重试调用 LLM,一晚上烧掉几百美元。在网关层设每日/每用户 spending 上限,超了直接拒绝并告警。OpenAI/Anthropic 的 dashboard 都有预算告警,但那是事后通知——网关层的硬熔断才是事前防护。
告警:分级、降噪,不然你会关掉它
错误监控项目烂尾的最常见原因,不是没装,而是告警太多,被手动关掉了。一人团队的告警策略,核心就两个词:分级、降噪。
分级三档就够了:
P0(立刻看):支付失败率突增、登录全挂、5xx 超过阈值。触发条件要苛刻:比如「5 分钟内同类错误 > 50 次」才告警,单条错误不打扰。P0 走电话/短信(PagerDuty 免费版或直接用 Sentry 的电话告警),别只发邮件——邮件是 P1 的通道。
P1(当天看):某个页面错误率 > 1%、AI 生成失败率突增。走邮件 + 即时消息(Slack/Discord webhook),每天固定时间看一次就行。
P2(每周看):零星的边缘 case、第三方脚本报错(广告拦截器导致的、浏览器插件注入的)。每周花 20 分钟批量扫一眼,修值得修的,忽略噪音。
降噪三招:
1. 去重靠指纹,不是靠数数。 Sentry 默认按堆栈指纹分组 issue,但 AI 生成的代码经常在循环里抛错、堆栈每次都差一行,导致同一个 bug 裂成 50 个 issue。定期合并 issue,或者自定义 fingerprint 规则(按 error.type + 模块 分组)。
2. 忽略规则先行。 上线第一周就把这些加进 ignore:浏览器插件注入的错误(chrome-extension://)、广告拦截器导致的资源失败、老版本浏览器的已知报错(Object.hasOwn 在 Safari 14 不存在之类)。这些错误修不了、也不该你修,留着只会淹没真正的信号。
3. 错误预算:给「已知但不修」设上限。 比如「IE 系错误每周不超过 20 条,超了就升级为 P1」。没有预算机制,你会陷入两难:要么全修(修不完),要么全忽略(错过真问题)。
成本与选型:一人团队怎么花小钱办大事
Sentry 免费版(每月 5000 错误事件 + 1 万性能事务)覆盖 99% 的 vibe 项目。超了怎么办?先降采样(tracesSampleRate: 0.1),再开 beforeSend 过滤:
Sentry.init({
  beforeSend(event) {
    // 已知的第三方噪音直接丢掉,不占额度
    if (event.exception?.values?.[0]?.stacktrace?.frames?.some(
      f => f.filename?.includes('chrome-extension'))) return null;
    return event;
  },
});在意数据主权/隐私的,用 GlitchTip(Sentry API 兼容的开源替代,可自建,一台 2C4G 小鸡就能跑)。SDK 侧几乎零改动——把 DSN 换成自建地址就行。代价是你要自己管存储和备份,错误量大了磁盘会先扛不住。
已经在用 PostHog 做产品分析的,可以直接开它的错误追踪(Exception Autocapture),省一个 SaaS 账号。缺点是错误分析能力比 Sentry 弱一档(分组、source map、release 健康度都不如),适合「有个总比没有强」的阶段。
选型结论很简单:先用 Sentry 免费版跑起来,额度或隐私真成问题了再换。错误监控领域最贵的不是 SaaS 账单,是你因为嫌麻烦而没装的那几个月。
上线检查清单:发版前 10 分钟过一遍
1. Sentry(或替代品)三端 SDK 已装:client、server、edge,一个不能少。
2. source map 上传已验证:Sentry 里点开一条测试错误,堆栈是源码行号不是压缩行号。
3. release = git sha、environment = production/staging 已打标。
4. 关键路由段有 error.tsx(按故障域拆分,不是全站一个)。
5. window.onerror + unhandledrejection 全局兜底已加。
6. setUser 只传脱敏 ID,全局搜一遍上报调用无 PII(邮箱/手机号/token)。
7. 业务异常有主动埋点(支付失败、AI 超时),不只靠自动捕获。
8. 后端:结构化日志 + traceId 贯穿 + uncaughtException 上报后退出。
9. LLM 调用:超时分层、重试 ≤3 次带退避、降级策略、spending 熔断。
10. 告警分级已配:P0 走电话/短信且阈值苛刻,ignore 规则已加浏览器插件噪音。
一句话总结:错误监控的价值不在于「收集了多少错误」,而在于「最严重的那个错误,你是不是比用户先知道」。5 分钟把最小闭环跑通,剩下的都是在降噪和提质上慢慢加码。你的下一个深夜,不应该再被朋友的「你网站白屏了」叫醒。
相关文章

公网上的每个接口都会在某个深夜被超预期调用。这篇实战为一人团队搭建限流体系:算法选型(滑动窗口 vs 令牌桶)、四层防御、AI 接口烧钱专项防护、配额设计、429 响应规范、误伤排查,最后附上线检查清单。
每个 vibe 项目迟早需要定时任务:每日数据同步、过期订单清理、账单对账、定时报告。AI 给你的第一个版本通常是 setInterval——开发够用,生产必死。这篇实战给出四种跑法的选型地图(应用内/Vercel Cron/GitHub Actions/Cloudflare),cron 表达式速查与时区坑,幂等性、防重叠分布式锁、失败重试与告警、可观测性 run log,以及 cron 接口的鉴权,最后附上线清单。
每个 vibe 项目迟早会遇到同一个时刻:列表页一打开就要查十几次库,并发稍高数据库就被打满。这篇实战从缓存的三问心智模型讲起,逐层拆解 HTTP 缓存头、Next.js 数据缓存、Redis 应用缓存与 AI 结果缓存(语义缓存/prompt 缓存),给出缓存键设计、穿透击穿雪崩的三件套解法和失效策略,最后附一份上线检查清单。