一夜被脚本刷掉 300 美元:vibe 项目的 API 限流与配额实战
公网上的每个接口都会在某个深夜被超预期调用。这篇实战为一人团队搭建限流体系:算法选型(滑动窗口 vs 令牌桶)、四层防御、AI 接口烧钱专项防护、配额设计、429 响应规范、误伤排查,最后附上线检查清单。
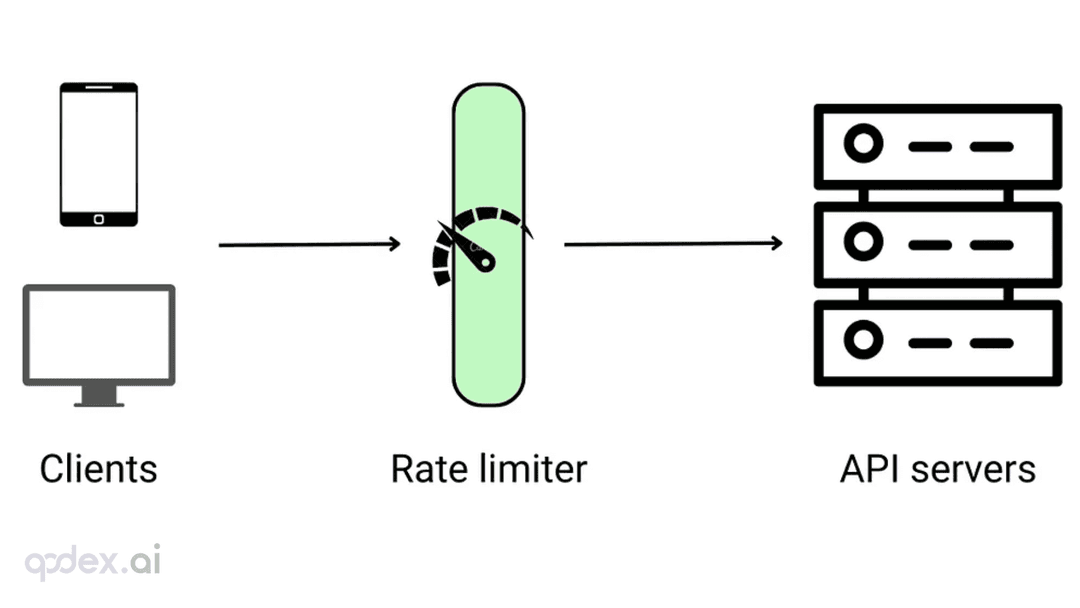
每个 vibe 项目都可能遇到这样一个凌晨:你被云账单短信吵醒,打开一看,一夜之间 API 费用多了 300 美元。查日志发现:某个接口被人用脚本每秒刷几十次——可能是爬虫,可能是恶意刷,也可能只是某个用户的 bug 导致无限重试。而你的服务,对这一切毫无防备:没有任何限流。
AI 生成的代码里,限流的缺席率接近 100%。它会给你写登录、写支付、写精美的 loading 动画,但不会主动问一句:「这个接口如果被每秒调 1000 次会怎样?」而现实是:所有暴露在公网的接口,都会被超预期地调用——这是互联网的基本定律,不是假设。
限流是 vibe 项目的「防弹衣」:不产生任何用户可见的功能,却决定了你的服务能不能活过第一个流量高峰、第一笔恶意账单。这篇实战的目标是:给你一套一人团队可落地的限流体系——从算法选型、分层策略、贵接口(AI 调用)专项,到配额设计、429 响应规范、误伤排查,最后附上线检查清单。
先建立心智模型:限流三问
动手前,先对每个要保护的接口连问三句:
1. 限谁? 按 IP 限(防爬虫、防 DDoS)、按用户 ID 限(防单个用户滥用)、按 API Key 限(多租户场景)、按端点限(贵接口单独收紧)。限错了维度等于没限:只按 IP 限,登录用户换个代理 IP 就绕过去了;只按用户限,未登录的爬虫随便刷。
2. 限什么? 不是所有接口都值得限。登录接口(防爆破)、AI 生成接口(烧钱)、短信/邮件发送接口(烧钱+骚扰)、导出接口(拖库)——这四个是必限的。而静态资源、公开文章页,限了只会影响正常用户和 SEO。
3. 超了怎么办? 直接拒绝(429)、排队等待、降级服务——三种策略对应不同的业务容忍度。支付回调超限?排队。AI 生成超限?拒绝+提示升级。选错策略比不限更伤:登录接口被刷时如果只是「排队」,攻击者的请求全堆在队列里,正常用户照样登不上。
还有一个关键区分:限流(Rate Limiting)≠ 配额(Quota)≠ 熔断(Circuit Breaking)。限流管「速度」(每秒几次),配额管「总量」(每月几次),熔断管「下游挂了时别跟着死」。三者是组合拳,不是三选一——这篇主讲前两个,熔断在错误监控那篇的 AI 专项里讲过 spending 熔断,思路相通。
算法选型:vibe 项目只用记住两种
限流算法有四种经典实现,但你只需要做一道选择题:
固定窗口(Fixed Window): 每分钟允许 N 次,到点清零。实现最简单(Redis 计数器 + 过期),缺点是窗口边界有「突刺」——23:59:59 用完 100 次,00:00:00 又能用 100 次,两秒 200 次。对防刷要求不高的内部接口够用。
滑动窗口(Sliding Window): 精确统计「过去 60 秒」内的次数,没有边界突刺。实现稍复杂(Redis sorted set 记时间戳),精度和成本的平衡点,推荐默认选这个。
令牌桶(Token Bucket): 桶里有 N 个令牌,每秒补充 M 个,请求消耗令牌。允许短时 burst(桶满时一次用完),适合「平时闲、偶尔 burst」的场景,比如 AI 生成接口——用户连点 3 次生成是正常行为,不该被限死。
漏桶(Leaky Bucket): 请求匀速流出,削峰填谷。适合保护脆弱的下游(比如你的数据库只能扛 50 QPS)。
选型结论:通用接口用滑动窗口,AI 生成类贵接口用令牌桶(允许小 burst)。但还有一句大实话:90% 的 vibe 项目不需要手写算法——直接用现成的:Upstash Ratelimit(三行代码,Serverless 友好)、Cloudflare Rate Limiting(边缘层,连源站都打不到)、Nginx limit_req。手写 Redis+Lua 只在你有特殊分桶逻辑时才值得。
Upstash 的最小实现长这样:
import { Ratelimit } from "@upstash/ratelimit";
import { Redis } from "@upstash/redis";

const ratelimit = new Ratelimit({
  redis: Redis.fromEnv(),
  limiter: Ratelimit.slidingWindow(10, "60 s"),  // 每 60 秒 10 次
});

const { success, reset } = await ratelimit.limit(`generate:${userId}`);
if (!success) {
  return Response.json({ error: "请求太频繁,请稍后再试" },
    { status: 429, headers: { "Retry-After": String(Math.ceil((reset - Date.now()) / 1000)) } });
}
注意 key 的设计:generate:${userId}——限流 key = 接口名 + 限流维度,和缓存键设计是同一个思想。key 设计错了,限流就串台:用 userId 做所有接口的 key,一个用户刷登录会把他的 AI 生成也连带限死。
分层限流:每一层挡掉 90%,剩下的才到应用层
限流要分层,不是一道墙。经典四层,每层挡掉 90% 的垃圾流量:
第 1 层:边缘(CDN/WAF)。 Cloudflare 的 Rate Limiting 规则、或 WAF 的托管规则。在这里限掉的是扫描器、爬虫、DDoS——它们连你的源站都碰不到。配置成本最低,效果最显著:先开这一层,再谈应用层。很多 vibe 项目直接裸奔源站,等于把家门钥匙挂在门口。
第 2 层:网关/中间件。 Nginx limit_req_zone、或 Next.js middleware 里的全局限流。挡的是「漏过边缘层的异常 IP」——比如某个 IP 每秒 50 次请求,先在这里拦,不消耗应用资源。
// middleware.ts:全局兜底,未登录 IP 每分钟 60 次
export async function middleware(req: NextRequest) {
  const ip = req.headers.get("x-forwarded-for")?.split(",")[0] ?? "unknown";
  const { success } = await ratelimit.limit(`global:${ip}`);
  if (!success) return new Response("Too Many Requests", { status: 429 });
}
第 3 层:应用/业务级。 前面 Upstash 示例就是这一层——按业务语义限:登录接口每 IP 每分钟 5 次、AI 生成每用户每天 50 次、短信接口每手机号每天 3 条。这一层的限流值是产品决策:免费用户每天 20 次生成、付费用户 500 次——限流值直接写进定价页。
第 4 层:下游保护。 你调的 LLM API、支付网关、短信服务商,自己都有 QPS 上限。你的应用层要算总账:1000 个用户 × 每人每秒 1 次 = 1000 QPS,而你的 OpenAI key 上限是 500 QPS——你的限流总和不能超过下游最弱的一环,否则下游先挂,挂的还是你的服务。
贵接口专项:AI 生成接口的限流是「钱」的艺术
对 vibe 项目来说,最需要精心设计的限流是 AI 生成接口——因为它直接连着你的钱包。一次 GPT 级别的生成调用,成本可能是普通数据库查询的 1000 倍。限流值设错了,要么烧钱,要么赶走付费用户。
1. 按用户分级,不是一刀切。 匿名用户:每天 3 次(只够尝味道);免费注册用户:每天 20 次;付费用户:每天 500 次 + 可超额(超额部分按量计费)。分级值要和你的成本模型反推:假设单次生成成本 0.05 美元,免费用户每天 20 次 = 1 美元/天/人——你的获客成本和转化率能不能覆盖?算不过来账的免费额度,就是在做慈善。
2. 排队,而不是直接拒绝——对付费用户。 付费用户超限时,直接 429 是赶客。更好的做法:进队列排队,返回 202 Accepted + 排队位置,前端轮询或 WebSocket 推送结果。实现不复杂(Redis list 做队列),体验天差地别。免费用户超限才直接 429,并在错误信息里带升级链接——这是转化漏斗的一部分。
3. 并发限流 + 速率限流双保险。 速率限流管「每分钟几次」,并发限流管「同时几个」。AI 生成是长耗时任务(10-60 秒),用户开 10 个标签页同时点生成——速率没超,并发爆了。用信号量(Redis SETNX 计数)限制单用户同时 2 个生成任务,超出的排队。
4. prompt 长度也要限。 最隐蔽的烧钱方式:用户贴 10 万字的 prompt 进来,一次调用烧掉你几美元。在网关层按 token 数预估(text.length / 4 粗估),超长的直接拒绝或截断。AI 生成的代码永远不会帮你做这层检查——它甚至不知道 token 是要花钱的。
配额设计:把「用量」变成产品的一部分
限流管速度,配额管总量。配额是 SaaS 商业模式的地基,设计不好,定价页就是空话。
1. 配额维度三选一:按次、按量、按席位。 AI 生成类按「次」(简单好懂);API 类产品按「调用量」(1 万次/月);团队协作类按「席位」。不要混用——「每月 1000 次生成或 50 万 token 先到先停」这种规则,用户算不明白,客服会被问爆。
2. 超额处理四种策略,按业务选:
- 硬停(403): 免费版超额直接停。简单,但体验断崖。
- 按量付费(推荐): 超额部分自动按量计费,用户无感续用。这是 Stripe Billing 的 metered billing 干的事,vibe 项目用 Stripe 的 usage-based pricing 几行配置就能上。
- 降级: 超额后切到便宜模型/降低频率。适合 AI 功能:免费额度用完,生成速度变慢但不断。
- 人工介入: 企业版超额走销售。早期别做,手动处理就行。
3. 用量查询接口必须有。 GET /api/usage 返回剩余额度、重置时间。前端在显眼位置展示("本月已用 320/500 次")。没有用量展示的配额,等于没有配额——用户在超额前没有任何预期,超额时的愤怒值翻倍。这是 vibe 项目最容易漏的产品细节:AI 会写配额检查,但不会主动给你做用量展示 UI。
4. 配额重置的时区坑。 「每月」是从哪天算?自然月还是注册日?自然月简单,但 1 号 0 点所有用户同时重置——你的系统会在那一刻迎来一波小高峰。用注册日滚动 30 天,分散压力。时区用 UTC,别用服务器本地时间——前面 i18n 那篇讲过,时区是万恶之源。
429 响应规范:被限流时的体验也是产品
用户触发限流时看到什么,决定了他是「理解」还是「骂街」。规范三件套:
1. 状态码用 429,不要用 403。 语义完全不同:403 是「你没权限」,429 是「你太快了」。前端要根据状态码做不同处理——429 触发退避重试,403 跳登录。用错状态码,客户端的重试逻辑全乱。
2. Retry-After 头必须带。 告诉客户端几秒后重试,单位是秒。Retry-After: 60。好的客户端(和你自己的前端)会读这个头做指数退避,而不是无脑狂刷——不带 Retry-After 的 429,会诱发客户端更凶猛的重试,雪上加霜。
3. 错误体要人话 + 行动指引。
{
  "error": "rate_limited",
  "message": "生成次数太频繁了,请 60 秒后再试",
  "retryAfter": 60,
  "upgradeUrl": "/pricing"   // 免费用户超限时带上,这是转化点
}反面教材:{"error": "Too Many Requests"}——用户看不懂,客服解释不清,转化机会也没了。错误信息是产品文案,不是给开发者看的日志。
误伤排查:好用户被限了怎么办
限流上线后一定会遇到误伤:公司内网出口一个 IP 几百人、用户开了 VPN、某个大客户的批量导入脚本。处理机制要提前准备:
1. 限流命中 dashboard。 每天看一眼:哪个接口、哪个 key 触发最多。如果某个正常用户的 key 频繁触发,说明限流值设得太紧——限流值不是拍脑袋定的,是看数据调的。上线第一周把值设宽松(比如预估的 2 倍),看一周数据再收紧。
2. Allowlist 机制。 给大客户、内部服务、你自己的监控探针加白名单。但白名单要有过期时间——allowlist:{key} EX 30天,到期自动失效重新评估。永久白名单是最危险的技术债:三年后没人记得为什么这个 key 不限流,而它正在被滥用。
3. 区分「攻击」和「误伤」的信号。 攻击的特征:单 IP、无登录态、请求模式机械(固定间隔)、User-Agent 异常。误伤的特征:有登录态、有正常历史行为、触发后立刻降频。把这两个的判断逻辑写进你的 on-call 手册——凌晨 3 点被告警叫醒时,你没脑子做推理。
4. 一键降级开关。 万一限流规则写错(比如把支付回调也限了),要有个环境变量开关能 10 秒内关掉应用层限流:RATELIMIT_ENABLED=false。这是救命绳,平时用不上,用上一次就值回票价。
上线检查清单:发版前 10 分钟过一遍
1. 四个必限接口已覆盖:登录(防爆破)、AI 生成(烧钱)、短信/邮件发送(烧钱+骚扰)、导出(拖库)。
2. 边缘层(Cloudflare/WAF)限流已开,源站不裸奔。
3. 限流 key 设计:接口名 + 限流维度(IP/用户ID/API Key),无串台。
4. 贵接口用令牌桶(允许小 burst),通用接口用滑动窗口。
5. AI 生成接口:用户分级限流值已按成本模型反推;prompt 长度有检查;并发限流已加。
6. 429 响应:状态码正确、Retry-After 头必带、错误体有人话+行动指引。
7. 用量查询接口已上线,前端有剩余额度展示。
8. 配额维度单一(按次/按量/按席位三选一),超额策略已定。
9. Allowlist 有过期时间;一键降级开关 RATELIMIT_ENABLED 已备好。
10. 限流命中 dashboard 已建,上线第一周限流值设宽松(预估 2 倍),看数据再收紧。
一句话总结:限流不是「防君子」的摆设,而是「防小人、防 bug、防自己」的底线。公网上的每一个接口,都会在某个凌晨被超预期地调用——区别只在于,你是提前穿好了防弹衣,还是在账单短信里惊醒。AI 不会主动给你穿这件衣服,穿不穿,你自己说了算。
相关文章

每个 vibe 项目都会经历同一个黑色幽默时刻:网站白屏了,朋友比你的监控先告诉你。这篇实战为一人团队搭建完整错误监控体系:5 分钟 Sentry 最小闭环、错误边界、上报上下文设计、后端结构化日志、AI 调用专项防护、告警分级降噪,最后附上线检查清单。
2026 年 9 月 30 日,Bitdefender 宣布 AI Guardian 进入公开 beta:给自主 AI Agent 加的安检门,每一次工具调用、文件访问、密钥使用都要先拿到 allowed / flagged / blocked 裁决。首批 macOS 独占、beta 期免费,支持 Claude Code 与 OpenClaw。为什么这道「Agent 行为防火墙」来得正是时候。
每个 vibe 项目迟早需要定时任务:每日数据同步、过期订单清理、账单对账、定时报告。AI 给你的第一个版本通常是 setInterval——开发够用,生产必死。这篇实战给出四种跑法的选型地图(应用内/Vercel Cron/GitHub Actions/Cloudflare),cron 表达式速查与时区坑,幂等性、防重叠分布式锁、失败重试与告警、可观测性 run log,以及 cron 接口的鉴权,最后附上线清单。