vibe 项目的表单构建器实战:Schema、渲染引擎与拖拽搭建
问卷、报名表、申请表……当你的 vibe 项目长出第三个表单,手写维护就开始失控。这篇实战指南带你从零搭一个表单构建器:JSON Schema 做数据契约、UI Schema 管布局、类型到组件的注册表做渲染分发、规则引擎做条件逻辑,再到拖拽搭建器与 schema 版本化——附 AJV/zod 选型判断与上线 checklist。
1. 为什么 vibe 项目需要表单构建器
几乎每个 vibe 项目都会长出表单:用户反馈、活动报名、入驻申请、后台配置页。第一个表单你手写,半小时搞定;第二个复制粘贴改一改;到第三个,事情开始不对劲了——同一个"手机号校验"散落在三个文件里,产品说"把报名表的公司名称改成必填",你改完发现申请表里还有一处漏了;设计师换了一套输入框样式,你要摸遍所有表单一个个换。
这就是手写表单的维护地狱:表单逻辑和业务代码缠在一起,改一处、漏三处。表单构建器解决的不是"画表单更快"这个表面问题,而是一个架构决策——把表单从"代码"变成"数据"。表单长什么样、有哪些校验、字段之间怎么联动,全部由一份 JSON Schema 描述;渲染器只负责把这份数据变成界面。从此加字段是改数据,不是改代码;换样式是换主题,不是重写表单。
但先泼一盆冷水:3 个以内、字段固定的表单,直接手写,别折腾构建器。构建器本身是一个产品:schema 设计、渲染引擎、拖拽搭建器、版本管理,每一块都是成本。值得做的信号很明确:表单数量持续增长(问卷、报名、申请、配置页这类场景);字段需要运营或客户自己配置,而不是每次都找你改代码;同一份数据要在多端或多套主题下渲染。三个条件中一条,就值得认真考虑;三条全中,不做构建器你早晚会被表单淹没。
2. Schema 设计:先定数据契约,再谈界面
表单构建器的地基是 Schema,而且必须是两层 Schema:数据 Schema 管"存什么",UI Schema 管"怎么摆"。这个分离是整个设计里最重要、也最容易被做错的一步。
数据 Schema 建议直接用 JSON Schema 做数据契约:字段名、类型、是否必填、枚举值、嵌套对象、数组,一套标准全表达。它的好处是"说一次、到处用":前端渲染看它,后端校验看它,API 文档可以从它生成,数据库的 JSON 字段约束也能对齐它。一个最小可用的报名表单数据 Schema 长这样:
{
  "type": "object",
  "required": ["name", "phone"],
  "properties": {
    "name": { "type": "string", "title": "姓名", "minLength": 2 },
    "phone": { "type": "string", "title": "手机号", "pattern": "^1[3-9]\\d{9}$" },
    "company": { "type": "string", "title": "公司" },
    "members": {
      "type": "array", "title": "同行人",
      "items": { "type": "object", "properties": {
        "name": { "type": "string", "title": "姓名" }
      }}
    }
  }
}字段类型体系按"数据形状"划分最耐用:输入类(文本、数字、日期)、选择类(下拉、单选、多选)、文件类(上传)、嵌套类(object)、数组类(array,比如"添加一位家庭成员"这种动态增删)。注意这是数据层面的分类,不是控件层面的——"日期"在数据层是带格式的字符串,在界面层才映射成日期选择器。
那 UI Schema 为什么必须另起一套?因为数据 Schema 是"真理",UI Schema 是"表达"。字段顺序、分组标题、某个字段用下拉还是单选、占位文案、样式类,这些全是表达层的东西。一旦把它们塞进数据 Schema,灾难接踵而至:换一套主题要动数据契约;小程序端想换一种布局,被迫复用 Web 的排序;后端做数据校验时,还得先剥掉一堆前端布局字段。正确姿势:数据 Schema 只回答"数据长什么样、合不合法",UI Schema 只回答"界面怎么摆",两者用字段 key 关联,互不污染。

3. 渲染引擎:类型到组件的注册表
有了 Schema,渲染引擎要解决的问题就一句话:看到 schema 里声明的类型,找到对应的组件渲染出来。最干净的实现是注册表模式:
const widgetRegistry = {
  text: TextInput,
  date: DatePicker,
  select: SelectInput,
  mapPin: MapPicker,      // 自定义 widget
  richText: RichEditor,   // 自定义 widget
};
function renderField(fieldSchema, uiSchema) {
  const Widget = widgetRegistry[fieldSchema.widget || fieldSchema.type];
  return <Widget schema={fieldSchema} ui={uiSchema} />;
}这个模式的最大好处是加字段类型不需要改渲染主流程:新增一个"地图选点"字段,就是往注册表里注册一个组件。渲染器本身只处理三件事:遍历 schema、查表分发、管理整份表单的状态。什么该放进渲染核、什么该扔出去,是检验设计水平的分水岭。
自定义 widget 插槽是必须预留的。富文本编辑器、地图选点、文件上传、签名板这类"重型"字段,不可能也不应该塞进渲染核心。做法是定一个最小的插槽协议:widget 只需要接收 value / onChange / disabled / error 四个 props,内部爱用哪个第三方库用哪个。协议越薄,生态越容易长出来——哪天你要把富文本从 Quill 换成 TipTap,只换 widget 实现,schema 和渲染核纹丝不动。
渲染核必须主题无关。状态管理、校验触发时机、提交数据组装,这些逻辑和"输入框长什么样"没有半毛钱关系。把主题做成可替换的一层:默认主题、暗黑主题、客户品牌主题,换的只是注册表里组件的具体实现。很多自研构建器死就死在这里——第一版把样式写死在渲染逻辑里,第二版要换皮肤时发现得重写一半。
选型上,社区已经有成熟的路可以抄作业(具体 API 以各库文档为准,不建议背版本):RJSF(react-jsonschema-form)是老牌方案,schema + uiSchema + validator 三件套,生态最全,适合"先跑起来";uniforms的思路更抽象,用 schema bridge 把 zod 等多种 schema 统一桥接进来,AutoForm 能一行代码出表单;JSON Forms把 data schema 与 UI schema 的分离做到了骨子里,渲染器框架无关;问卷类场景可以直接看 SurveyJS,它的 survey-core 是平台无关的核。自研还是选库,判断标准只有一个:你的字段类型和交互有没有超出这些库的表达能力——没有就别重复造轮子。

4. 条件逻辑:规则引擎是构建器的灵魂
没有条件逻辑的表单构建器,只能叫"表单生成器"。真实世界的表单处处是"如果……那么……":国家选了"中国"才显示"身份证号";选择"企业用户"才要求填"统一信用代码";选了省份,城市下拉的选项跟着变。这三类——显隐、必填联动、选项联动——覆盖了九成需求,规则引擎就是为它们服务的。
规则有两种写法,选错一次、返工半年。表达式写法(比如 JSON Logic 风格的 {"if": [{"==": [{"var": "country"}, "CN"]}, ...]})适合开发者维护的固定逻辑:写在代码里、走版本控制、Code Review 能看、单元测试能测。可视化规则配置("当【国家】等于【中国】时,显示【身份证号】")适合运营或客户自助配置,但代价是你要完整实现一套规则 DSL:解析、求值、错误提示、审计日志,一个都不能少,成本高一个量级。
取舍的标准很现实:看规则谁来改、多久改一次。一年变两次、改的人是你,用表达式;一周变三次、改的人是运营,咬牙上可视化。最常见的坑是"现在用表达式先顶着,以后转可视化"——两种规则的存储格式和求值路径完全不同,"以后转"等于重写,立项时就要想清楚。
还有一条容易被忽略:规则必须和 schema 版本绑定。规则引用的是字段 key,字段一改名,旧规则就指空了。所以规则快照要随表单版本一起存,回放历史提交数据时,用的是当时的规则、不是现在的。前端求值只做体验优化(及时隐藏、即时提示),真正的校验在提交时由后端重做——这条安全铁律在第 6 节展开。

5. 拖拽搭建器:三栏布局与"写读同源"
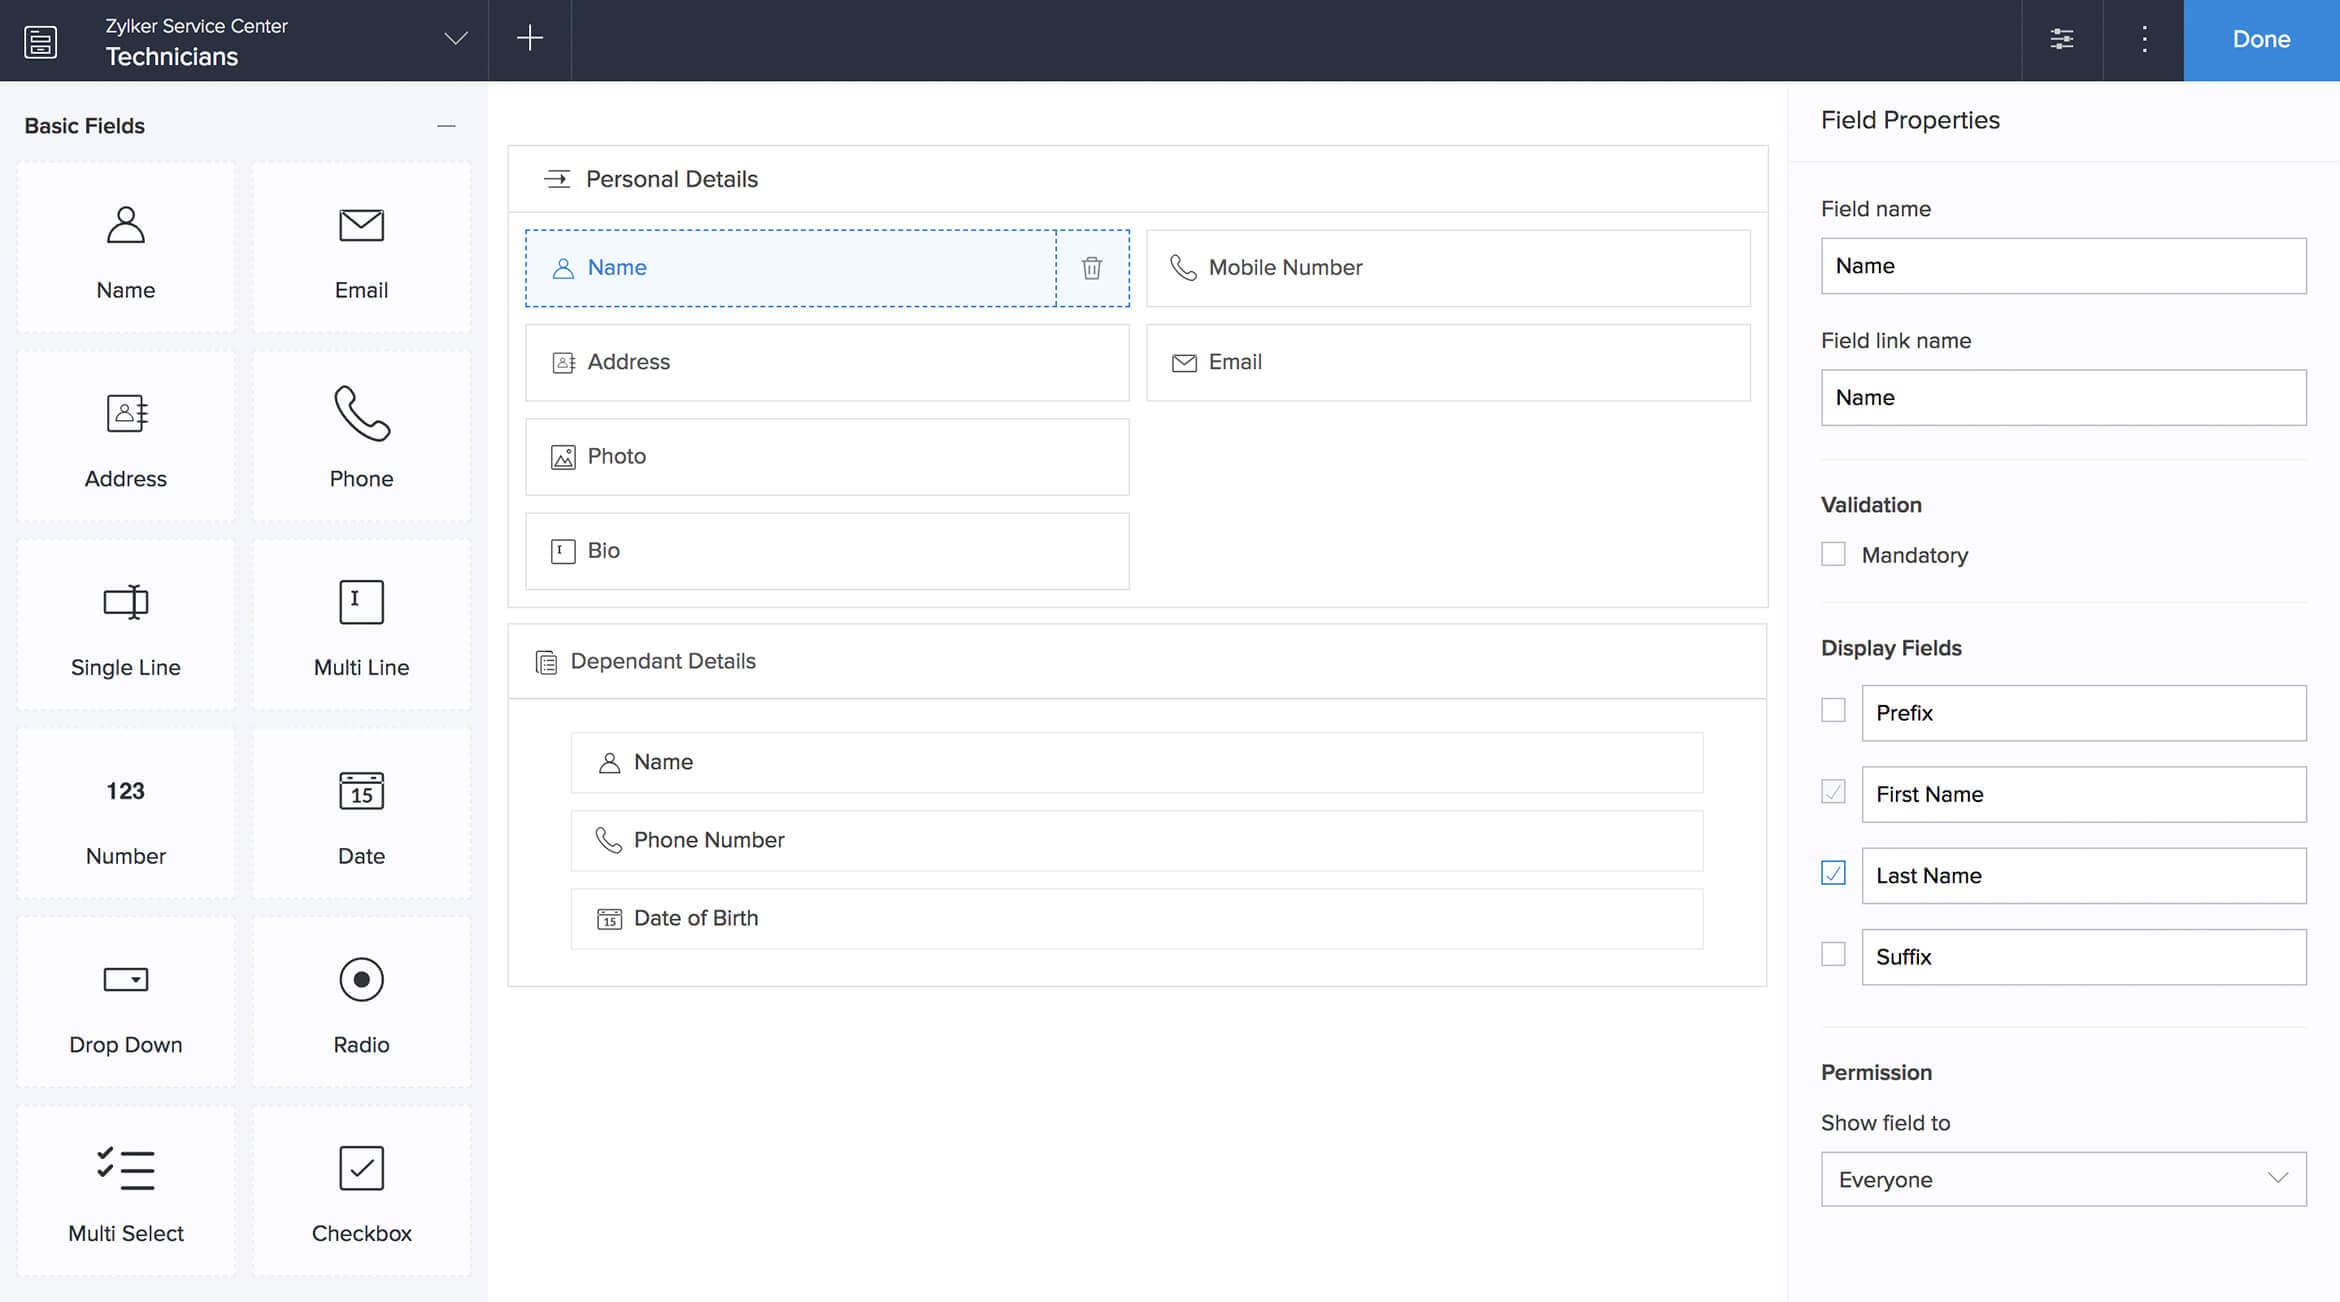
如果说渲染器是"读端",拖拽搭建器就是"写端"——让不懂代码的人也能产出 schema。界面形态高度趋同:左:组件面板(字段类型列表:单行文本、日期、下拉……)、中:画布(所见即所得的表单预览)、右:属性面板(选中字段的 schema 编辑:标题、必填、选项)。这个三栏布局不是审美选择,而是 schema 三层结构的直接映射:组件面板对应"类型体系",画布对应"渲染结果",属性面板对应"schema 编辑"。
搭建器有两个关键设计。第一,字段拖入画布时,自动生成一段默认 schema:拖入"日期",画布上多一个字段,底层 schema 多一段 {"type": "string", "format": "date", "title": "日期"};属性面板里改标题、设必填,改的是同一份 schema,画布实时重渲染。用户感知到的是"拖控件",实际发生的是"写 schema"。
第二,搭建器和渲染器必须共用同一套 schema、同一个渲染器。画布里的预览不要自己再写一套渲染逻辑,直接调用第 3 节的渲染引擎。这保证了"所见即所得"不是两套实现各说各话——搭建器里看到什么样,用户最终填的就是什么样。凡是搭建器预览和真实表单"长得差不多但细节对不上"的项目,根因几乎都是写端和读端分叉了。
拖拽交互层推荐用 dnd-kit:无样式、可组合、无障碍支持做得好,适合自研搭建器(具体用法以其文档为准)。另外两个实战坑提前说:拖拽排序后,字段顺序要写回 schema(JSON Schema 的 properties 本身无序,需要用 uiSchema 的顺序数组或 propertyOrder 单独维护);嵌套字段的定位用 JSON Pointer 风格的路径表达(members/0/name),属性面板和校验报错都靠它定位,别自己发明一套。
6. 校验与提交:AJV 还是 zod,以及那条安全铁律
校验选型是 AJV 和 zod 二选一,选错不至于死,但换起来很疼。AJV 是 JSON Schema 的官方校验器,优势是"标准互通":同一份 schema,前端用 AJV 验,后端用 AJV 验,甚至其他语言也有 JSON Schema 校验器,跨团队、跨语言协作无障碍。zod 是 TypeScript 优先的方案,优势是"前后端同构":同一份 zod schema,前端表单校验和后端接口校验共用,类型还能自动推导,TS 全栈团队的体感极好。判断标准:团队是 TS 全栈、追求类型体感,选 zod;schema 需要跨语言、跨团队作为契约流转,选 JSON Schema + AJV。两者也可以并存:JSON Schema 落库做标准,运行时用 zod(uniforms 的 ZodBridge 就是这个思路的现成实现)。
然后是安全铁律:前端校验只为体验,后端必须用同一份 schema 重验。前端校验再完善,攻击者一个 curl 就能绕过——它优化的是正常用户的体验,不是系统的安全边界。正确做法:提交到达后端后,用同一份 schema(注意是同一份,不是后端工程师"照着前端逻辑再写一遍")在服务端跑一遍校验。条件逻辑里的"隐藏字段不提交"尤其不能当安全边界:前端隐藏了"折扣码"字段,攻击者照样可以在请求体里塞一个,后端必须按 schema 的类型、必填、枚举重验,该拒绝拒绝。文件字段走"先上传拿 URL、URL 再进提交体"的两步流程,上传接口本身也要做类型和大小校验,别把信任建立在前端 accept 属性上。
7. 版本化与历史数据兼容:构建器和"一堆写死表单"的本质区别
写死的表单没有版本问题——代码发版即全量替换。但构建器的表单是数据:用户上个月提交的报名表,这个月 schema 改了,历史数据还读不读得出来?版本化就是表单构建器和"一堆写死表单"最本质的区别,前者把表单当数据资产管,后者当代码管。
落地就三条纪律。第一,schema 存版本号:每个表单的每次发布,全量快照 schema(含 UI schema 和规则快照)并打版本号,提交数据里记录"本次提交用的 schema 版本"。回放、导出、审计,全部按版本号取快照,永远不要用"当前最新版"去解读历史数据。
第二,字段重命名要有映射:phone 改成 mobile,老数据里的 phone 怎么办?方案 A 是维护 rename map,读取时迁移;方案 B 更狠——字段 key 一旦发布永不改名,只改 title(显示名)。小团队直接选 B,省掉一整类 bug。
第三,只增不删的演进纪律:字段不要删,标记 deprecated 即可——前端不再渲染它,后端仍接受老数据里的它。删字段的代价是:老数据读不出、新提交对不上、报表里凭空少一列。迁移策略上,小项目用"读时迁移"(读到老版本数据时按映射转成新版)就够了,别一上来就做全量数据迁移任务。
8. 上线 checklist:性能、可访问性与分享安全
构建器跑通只是半程,上线前还有三道坎。第一道是性能:100+ 字段的大表单,全量受控组件一次重渲染就能把低端机卡死。思路按顺序用:先分组/分步渲染(一次只渲染一组,天然符合长表单的用户心智);再做字段级订阅(一个字段变化只重渲染自己);虚拟化是最后手段——表单不是列表,虚拟化带来的焦点管理和校验复杂度,不到万不得已别碰。
第二道是可访问性基线:构建器生成的表单,a11y 下限由你定。label 必须和输入框正确关联、所有交互键盘可达、错误信息用 role="alert" 让读屏软件能读到、颜色对比度达标。这些在渲染核里做一次,所有表单终身受益;在每个手写表单里各做一次,等于永远做不完——这也是构建器架构的红利之一。
第三道是分享与嵌入的安全:构建器让"发布一个表单"变得极容易,安全水位必须跟上。iframe 嵌入要想好 allow 属性和 CSP/X-Frame-Options 的取舍;分享链接的 token 要有有效期和撤销能力;公开表单要防刷(验证码、频率限制、同一 IP 提交配额)。最危险的心态是"表单只是收集信息,能出什么事"——能,垃圾数据灌库、钓鱼表单冒用你的域名,每一件都够喝一壶。
最后给个落地顺序建议:先让 3 个真实表单跑通"schema → 渲染 → 校验 → 提交 → 版本化"全链路,再补拖拽搭建器,顺序别反。搭建器是写端的效率工具,全链路才是构建器的命。链路不通的搭建器,拖出来的只是漂亮的截图;链路通了,搭建器晚两个月上,天塌不下来。
评论 (0)
相关文章
私信不是发个消息那么简单。本文带你走完 vibe 项目私信系统的完整实战:三种会话形态取舍、三表数据模型与陌生人消息请求状态机、WebSocket 投递与幂等去重、已读水位线、反骚扰四件套、附件签名 URL、推送静默聚合、删除语义辨析,以及 12 条上线必测用例。
公开路线图把“什么时候做 X”从客服噩梦变成信任引擎。本文讲透:五状态请求状态机、投票墙规则(一人一票 vs 权重、防刷、冷启动)、请求去重与合并、看板 vs 时间轴布局、双周/月度更新节奏与 changelog 联动、三种优雅拒绝话术、三张表的 Prisma 数据模型,以及把路线图变成“承诺清单”的四个大坑。
赏金计划烧掉的是预算,省下的是事故。本文讲清什么时候该开、怎么定价、范围怎么写、安全渠道怎么搭、平台怎么选、漏洞怎么分级去重、AI slop 报告怎么过滤、猎人怎么沟通、修复 SLA 怎么定——一套 vibe 项目可直接落地的赏金运营全流程。