服务明明活着,用户却进不去:vibe 项目的健康检查与就绪探针实战
部署成功不等于服务可用:存活、就绪、启动三组探针怎么分工,每个依赖查到什么程度,平台参数怎么设,以及探针本身怎么别变成新的故障源。
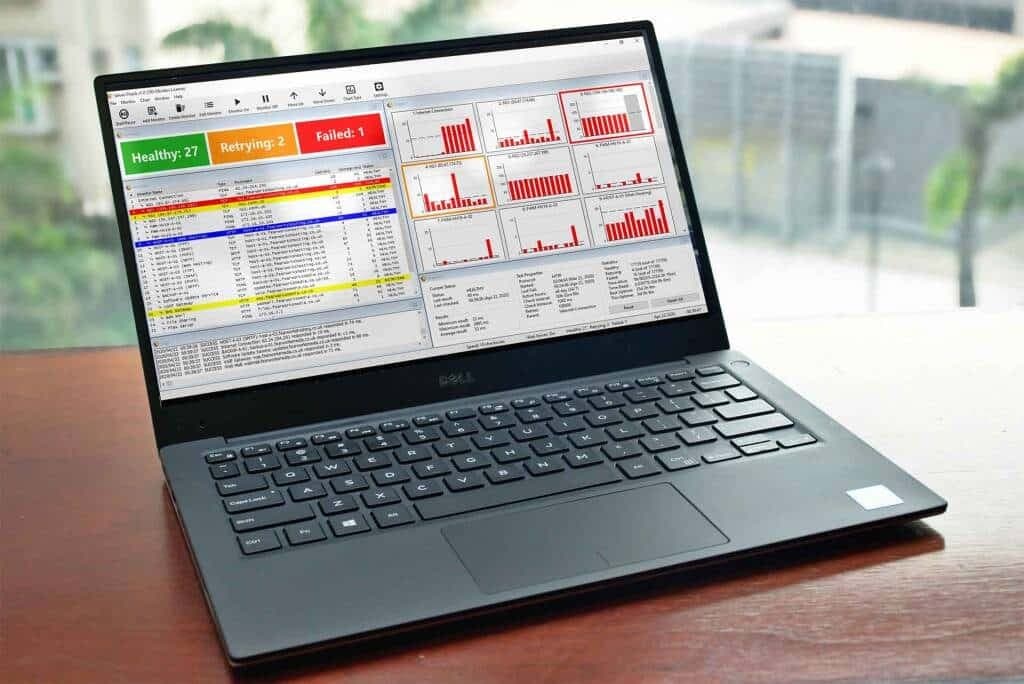
部署成功了,用户却进不去:先说一个真实感很强的教训
先讲一个虚构的教学例子。小团队“云笔记”是个一人维护的在线笔记应用,某天晚上发了个新版:流水线一路绿灯,部署成功的提示也弹出来了,负责人在群里发了句“已上线”。十分钟后用户开始反馈:打不开,页面一直转圈。负责人去看服务器:进程在,端口在监听,CPU 也正常——服务“活着”。再查一层才发现,新版本启动时要连数据库做一次迁移,迁移卡住了,服务其实还没准备好接请求。但负载均衡不知道这一点,照样把用户流量往上送,送一个挂一个。等负责人手动把这台机器从负载均衡里摘掉,服务才恢复。部署成功和服务可用,中间差了一个没人检查的环节。
这就是健康检查要解决的问题:一个服务是不是“活着”,和它能不能“干活”,是两件不同的事。进程在不代表能连数据库,能连数据库不代表缓存和队列都就绪,全部就绪也不代表它还撑得住下一波流量。健康检查就是给服务装上三组仪表:活着吗、能干活吗、还撑得住吗;每一组仪表对应一个动作:活着的留着、没准备好的先别接流量、撑不住的赶紧报警。本文讲的就是怎么给 vibe 项目设计这三组检查:存活探针、就绪探针和启动探针怎么分工,每个依赖查到什么程度,平台参数怎么设,以及探针本身怎么别变成新的故障源。以下示例均为虚构的教学示例,应用名与数字均为为讲解而构造的简化版本。

一、先分清三个问题:活着、能干活、撑得住
动手之前先把三个问题分开,它们对应三种不同的检查,混在一起是大多数健康检查事故的根源。存活检查(liveness)只回答一个问题:这个进程是不是还活着,有没有死锁、死循环、内存耗尽到动弹不得。如果答案是否,正确的动作是重启它。存活检查要轻、要快、要只看进程自己:返回 200 就行,绝不能依赖数据库、缓存或者任何外部服务。一个服务数据库挂了,但进程本身好好的,这时候重启它没有任何意义,只会让它在启动时再卡一次。
就绪检查(readiness)回答的是另一个问题:这个服务现在能不能接流量。它要查的是服务干活所需要的东西:数据库能不能连上、缓存通不通、关键的配置有没有加载完、启动时要做的迁移跑完了没有。如果答案是否,正确的动作是“先别把流量发给它”,而不是重启。服务正在热身、依赖正在恢复的时候,最不需要的就是一次重启。很多团队只做存活检查不做就绪检查,结果就是新版本刚启动、迁移还没跑完,负载均衡已经把用户送进来了。
第三个是启动检查(startup),回答的是“启动这件事本身进行到哪一步了”。有些服务启动很慢:要加载大模型、要预热缓存、要跑几分钟的迁移。启动检查的作用,是在启动期间放宽存活检查的耐心:告诉平台“它还在启动,别因为一时没响应就把它杀了”。没有启动检查,慢启动的服务会在每次发布时被平台反复杀掉重启,永远也起不来。这三个检查的分工,一句话就是:启动检查管“起得来”,就绪检查管“接得了”,存活检查管“死没死”。
| 检查 | 回答的问题 | 失败时的动作 | 能依赖外部服务吗 |
|---|---|---|---|
| 存活 liveness | 进程还活着吗 | 重启进程 | 不能,只看自己 |
| 就绪 readiness | 现在能接流量吗 | 暂停分流,等恢复 | 能,查关键依赖 |
| 启动 startup | 启动进行到哪了 | 继续等,别急着杀 | 能,查启动步骤 |

二、就绪检查查什么:每个依赖单独列出来
就绪检查最容易写错的地方,是把它写成一个笼统的“都好吗”。正确的做法是:把服务依赖的东西一个一个列出来,每个依赖单独检查、单独给结果。数据库、缓存、对象存储、消息队列、第三方接口,哪个不行,就绪检查就报告哪个不行,并且把失败的原因写进日志。这样做的好处是,出问题的时候不用猜:日志里写着“数据库连接超时 3 秒”,而不是一句含糊的“服务不健康”。
每个依赖的检查要轻。查数据库用 SELECT 1 或者等价的轻量查询,不要 SELECT COUNT(*) 全表扫一遍;查缓存用一次 PING 或者读写一个探针专用的小键,不要为了检查去读业务数据;查对象存储用一次 HEAD 请求看桶在不在,不要下载文件。检查本身应该在几十毫秒内完成,超时时间设短一点,比如 2 到 3 秒:一个依赖如果 3 秒都没响应,它在真实请求面前也一样会超时,继续等下去没有意义。
还要想清楚:哪些依赖挂了就该下线,哪些挂了可以降级。支付服务挂了,订单服务多半真的没法接单,下线是对的;但推荐接口挂了,商品列表页完全可以先不显示推荐、照常卖货,这时候就绪检查就不该因为推荐接口而失败。做法是把依赖分两档:硬依赖(没有它就没法干活)进就绪检查,软依赖(没有它也能降级提供服务)不进就绪检查,只进监控告警。分档的标准不是技术上的“连不连得上”,而是业务上的“用户还能不能完成核心操作”。
// 就绪检查:每个硬依赖单独检查,失败时说明是哪一个
// GET /readyz
async function readiness(req, res) {
  const checks = {};
  checks.db = await checkDb();       // SELECT 1,超时 2 秒
  checks.cache = await checkCache(); // PING,超时 1 秒
  // 推荐接口是软依赖:只记监控,不影响就绪结果
  const ok = checks.db.ok && checks.cache.ok;
  res.status(ok ? 200 : 503).json({ status: ok ? "ready" : "not-ready", checks });
}
三、探针参数:耐心要给够,但不能无限给
探针不是装上去就完事,四个参数决定了它在真实故障里表现如何:多久查一次(period)、一次等多久(timeout)、失败几次才判死刑(failureThreshold)、启动后等多久再开始查(initialDelay)。这四个数要按服务的真实启动时间来设,而不是照抄网上的默认值。一个要 40 秒才能起来的服务,initialDelay 设 5 秒,等于告诉平台“启动 5 秒还没好就杀了它”,每次发布都会被误杀。
给一组一人团队可以直接抄的起点值,再按实测调。存活检查:每 10 秒一次,超时 3 秒,失败 3 次重启,启动后等 15 秒再开始查。慢启动的服务再加一个启动检查:每 5 秒一次,超时 3 秒,最多等 120 秒,启动检查通过之前,存活检查先别动手。就绪检查:每 5 秒一次,超时 2 秒,失败 2 次就摘流,恢复 1 次就重新接流。摘流要比接流更果断:失败两次就摘,恢复一次就接回来——流量回来得慢一点没关系,流量被送进一个半死不活的服务,损失要大得多。
参数还要和部署方式配起来。用 Docker 的 HEALTHCHECK 时,注意健康检查跑在容器里面,依赖的命令(比如 curl)必须装在镜像里,否则检查永远失败。用 Kubernetes 的时候,livenessProbe 和 readinessProbe 是两个独立的配置,不要把同一个接口同时挂在两个探针上:就绪接口查数据库,存活接口只返回 200,两个接口分开写。反向代理前面也有一层健康检查:Nginx 或者负载均衡的健康检查间隔一般比 K8s 的长,摘流会慢一拍,这是正常的,不要为了让它变快而把间隔设到 1 秒——1 秒一次的检查乘以几十台机器,就是对服务的一次小规模压测。
# Kubernetes:存活只看自己,就绪查硬依赖,启动给足耐心
livenessProbe:
  httpGet: { path: /healthz, port: 3000 }
  initialDelaySeconds: 15
  periodSeconds: 10
  timeoutSeconds: 3
  failureThreshold: 3
readinessProbe:
  httpGet: { path: /readyz, port: 3000 }
  initialDelaySeconds: 5
  periodSeconds: 5
  timeoutSeconds: 2
  failureThreshold: 2
startupProbe:
  httpGet: { path: /healthz, port: 3000 }
  periodSeconds: 5
  failureThreshold: 24  # 最多等 120 秒启动
四、探针自己别成故障源:检查要轻、要缓存、要限流
健康检查最讽刺的事故,是检查本身把服务打垮了。真实发生过的情况:就绪检查每次都去数据库做一次全表查询,负载均衡每 5 秒查一次,十台机器加起来等于每秒钟多了几十次重查询;或者探针接口没有限流,被扫描器发现后每秒几百次地刷,服务光应付探针就耗尽了连接池。探针是服务最频繁的访客,它必须比任何业务请求都轻。
三条规矩可以防住这类事故。第一,检查结果要缓存:依赖的状态每 2 到 3 秒才真正查一次,中间的探针请求直接返回缓存的结果。负载均衡和 K8s 的探针本来就是每隔几秒才来一次,缓存 2 秒不会让它们看到过期太久的信息,却能把数据库的压力从“每次探针一次查询”降到“每 2 秒一次查询”。第二,探针接口只做读、不做写:不要在探针里写日志到数据库、不要触发迁移、不要发消息。第三,探针接口要限流和隔离:探针走独立的轻量路由,不经过鉴权中间件和业务日志中间件;如果担心被外部扫描到,就把探针端口只暴露给内网,或者只允许负载均衡和 K8s 的 IP 访问。
还有一个容易被忽略的点:探针的返回内容。返回一个简单的 JSON 就够了:状态、每个依赖的结果、检查花了多长时间。不要在探针响应里返回版本号、内网 IP、数据库连接串、错误堆栈这些敏感信息——探针接口常常不设鉴权,返回的东西等于公开的。版本号可以放在另一个需要鉴权的接口里,或者只在响应头里给一个简短的版本标识。
五、失败之后怎么办:分级、降级与演练
探针的价值不在“平时都是绿的”,而在“出事的时候动作是对的”。先说分级:就绪检查失败,动作是摘流,这件事应该自动发生,不需要人半夜起来点按钮;存活检查失败,动作是重启,也应该自动发生。需要人介入的,是“反复失败”:同一个服务一小时内重启三次,或者就绪失败超过十分钟还不恢复,这时候再发告警给人。告警也要分级:可以等天亮再看的发到群里,必须立刻处理的才打电话。把所有失败都打成电话告警,结果就是三个月后没人再接电话。
再说降级。就绪检查摘流之后,服务自己也应该知道“我现在是降级状态”。比如推荐接口挂了,商品页不显示推荐;图片服务慢了,先返回占位图、后台慢慢重试;写操作依赖的队列满了,先把请求接下来存到本地、等队列恢复再补发。降级不是“随便糊弄过去”,而是事先设计好的第二条路:每个软依赖都要有一句对应的降级文案和兜底行为,写在代码里而不是记在某个人脑子里。没有设计过的降级,等于没有降级。
最后是演练。健康检查写完之后,要主动把它弄坏一次,看看整个链条是不是真的会动。演练不用复杂: staging 环境里手动停掉数据库 30 秒,看就绪检查是不是在 10 秒内变红、负载均衡是不是把流量摘走了、恢复之后流量是不是自己回来了;再模拟一次进程死锁,看存活检查是不是按时重启了它。演练的时候把每一步的时间记下来:从故障发生到摘流花了几秒、到告警花了几秒、到恢复花了几秒。这三个数字就是这套健康检查的真实水平,比任何文档都诚实。
六、别把健康检查和状态页、监控混成一团
健康检查、状态页和监控是三件不同的工具,经常被混在一起写,最后哪件都没写好。健康检查是给平台看的:负载均衡和 K8s 靠它决定“流量发给谁、进程杀不杀”,它要快、要轻、要只回答“行还是不行”。状态页是给用户看的:服务挂了,用户去状态页看“现在是什么情况、预计什么时候恢复”,它要写人话、要及时更新、不要暴露内部细节。监控是给团队看的:CPU、内存、错误率、延迟这些指标的曲线,出了问题靠它定位根因。
三者的边界划清楚,工作量反而变小。探针接口只返回 200 或 503,不用在里面塞一堆指标;状态页的更新走人工或者值班流程,不用探针去驱动;监控的采集走专门的指标接口(比如 /metrics),采样频率和探针的检查频率分开设。一个常见的反模式是:把监控指标全塞进就绪检查的响应里,探针一次返回几十 KB,负载均衡每 5 秒拉一次,带宽和解析时间全浪费在不需要的信息上。另一件反模式是:用监控告警代替就绪检查——监控发现问题要几分钟,就绪检查发现问题只要几秒,等监控报警的时候,用户已经掉了几分钟的请求。
七、给 vibe 项目的落地顺序:先有再优
一人团队不用一上来就做全套。按这个顺序来,每一步都有明确的收益。第一步,先加两个接口:/healthz 只返回 200,/readyz 查数据库的 SELECT 1。十分钟的工作量,解决的是“部署成功但服务不可用”这个最痛的问题。第二步,把两个接口接到平台上:Docker 写 HEALTHCHECK,K8s 写 livenessProbe 和 readinessProbe,负载均衡配好健康检查路径。第三步,把软依赖和硬依赖分开档,该降级的写降级。第四步,加上启动探针,解决慢启动被误杀的问题。第五步,把检查结果缓存起来、把探针响应里的敏感信息清掉、把反复失败的告警接好。
每一步做完都验证一遍,不要攒到最后一起测:改完 /readyz 就手动停一次数据库,看它变不变红;接好 K8s 探针就发一次版,看新 Pod 是不是等就绪了才接流量;加好降级就断一次推荐接口,看页面是不是照常卖货。健康检查这件事,验证的成本很低,不验证的成本很高——平时看不出来,发布夜里才会发现。
八、上线前检查清单
最后是一张可以直接照着打勾的清单。第一,/healthz 和 /readyz 两个接口是不是分开的,存活接口是不是只看进程自己、不依赖任何外部服务。第二,就绪检查里的依赖是不是一个一个单独列出来的,失败时日志里能不能直接看到是哪个依赖不行。第三,硬依赖和软依赖分档了没有,软依赖挂了会不会错误地导致摘流。第四,四个探针参数是不是按服务的真实启动时间设的,慢启动的服务有没有配启动探针。第五,检查结果有没有缓存,探针接口有没有绕开鉴权和业务日志中间件。第六,探针响应里有没有版本号、内网 IP、连接串这些不该公开的信息。第七,反复失败的告警接好了没有,演练做过没有:停一次数据库、卡一次启动,整个链条是不是按预期动起来了。
如果清单里有一项答不上来,健康检查就先别算做完。服务健不健康,不是看它平时跑得多稳,而是看它出问题的时候,平台能不能在几秒内做出正确的决定:该摘流的摘流,该重启的重启,该报警的报警。把“活着、能干活、撑得住”这三个问题分开问、分开答,探针就从一句摆设,变成了服务真正的安全带。
评论 (0)
相关文章
一分钱对不上,账就没法结:浮点数为什么算不准钱、只存整数分的铁律、只在最后关口舍入一次、折扣税费分摊与多币种的坑,以及上线前必须跑的七个测试用例。

越用越慢、重启就好,十有八九是内存泄漏:三快照定位法找到引用链,七类藏身处对号入座修掉,再用同一套操作验证一遍,最后把内存预算和检查清单留下来防复发。
2GB 视频传到 99% 断了不该从头再传:分片协议怎么定、前端怎么切怎么传、服务端怎么合、秒传怎么做、三层失败处理怎么做,附上线前检查清单。