别把模型名写死:vibe 项目的模型切换与降级兜底实战
模型会下线、会限流、会涨价。别再把模型名写死:用能力档位做抽象、一张路由表管降级链、失败先分类再重试、付费档降级必须告诉用户。
先说结论:你的产品应该依赖“能力档位”,而不是某个模型的名字

几乎每个接了大模型 API 的 vibe 项目,都会在某一天撞上同一面墙:昨天还好好的模型,今天突然变慢、限流、涨价,甚至直接宣布下线。仅在 2026 年 10 月,GitHub 就预告过一批 Copilot 模型将于 11 月中旬下线——模型下线不是小概率事件,而是这个行业的常态。如果你把模型名字写死在代码各处、写死在提示词里、写死在用户可见的界面上,每一次变动都是一次全站返工。
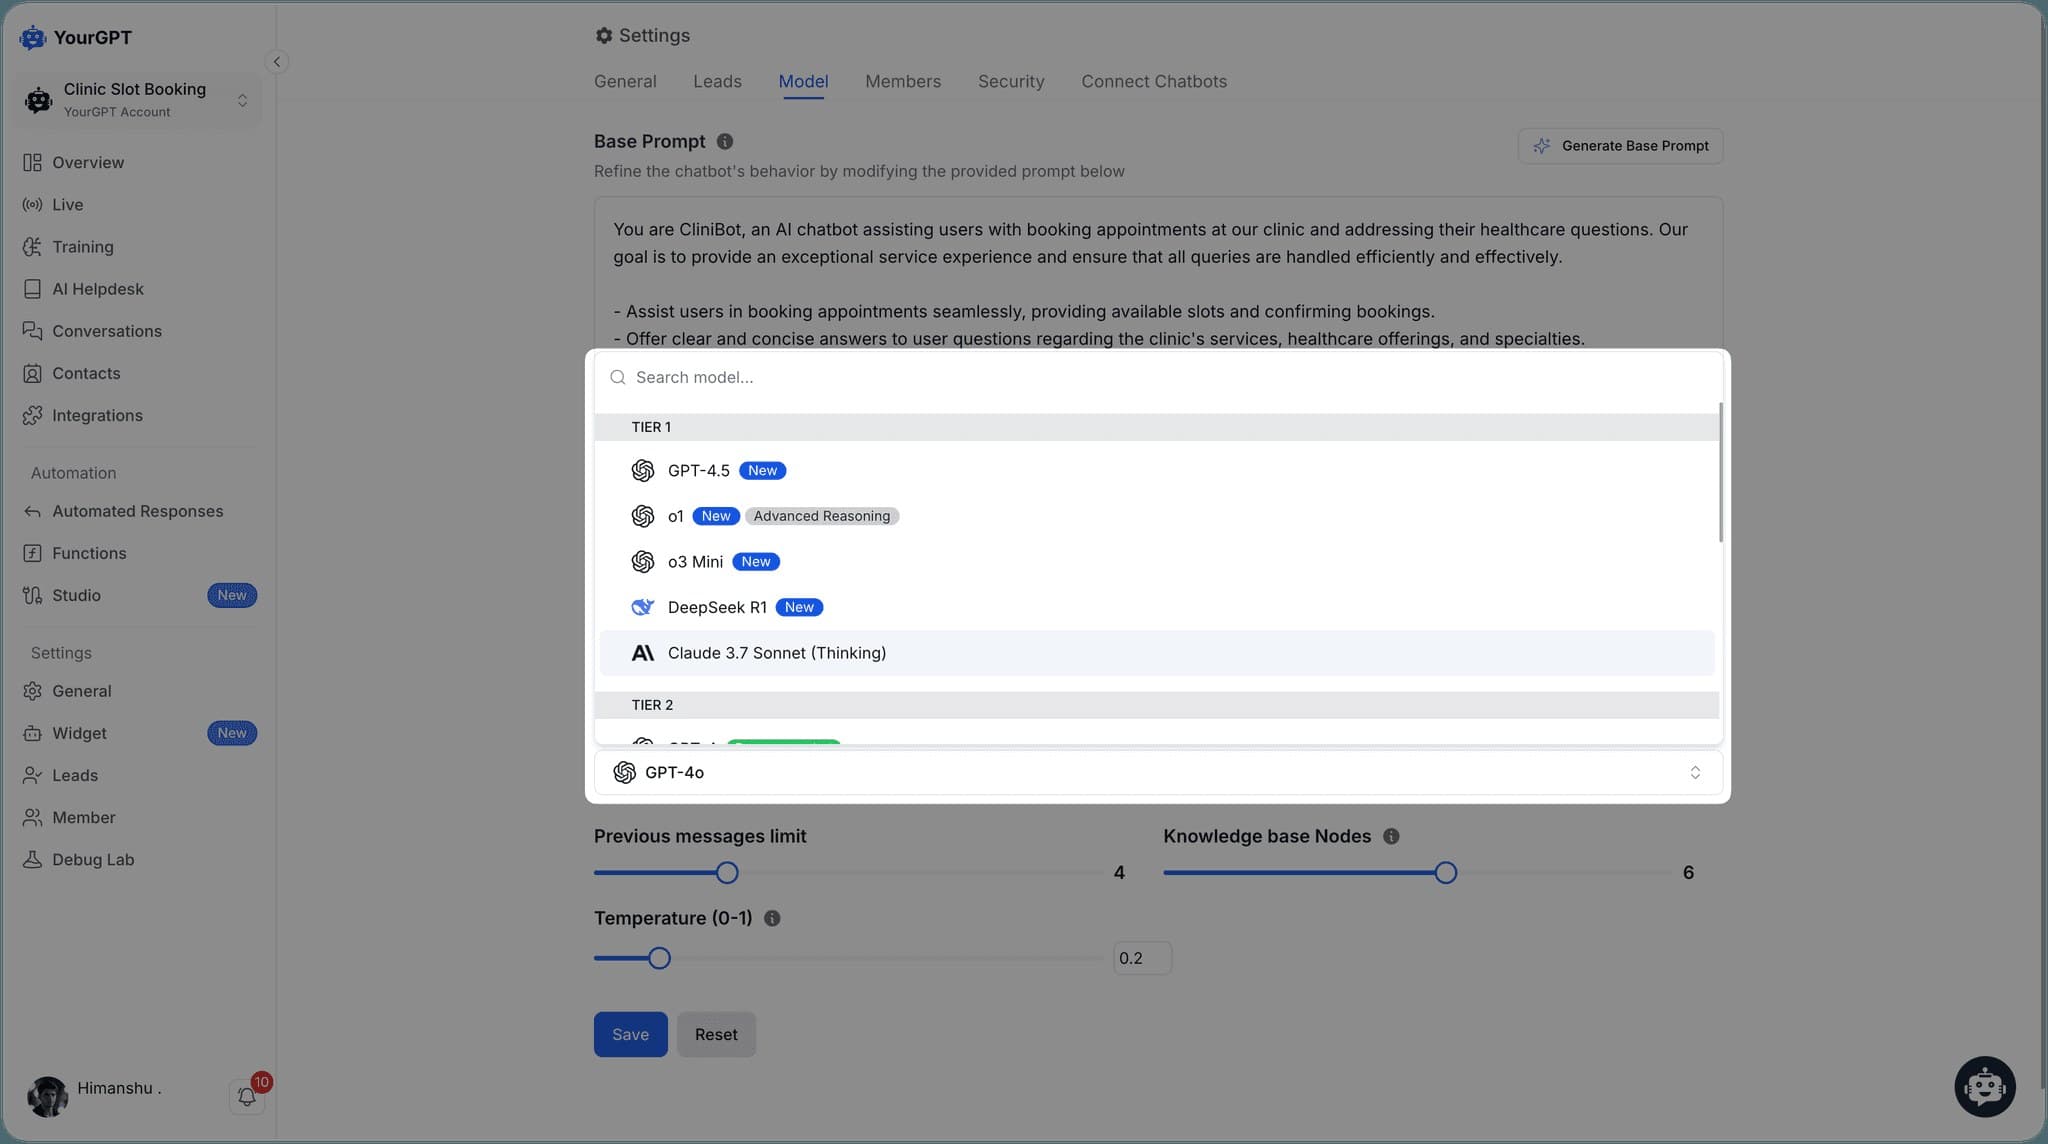
本指南给出的核心办法只有一句话:产品内部只认“能力档位”,模型名字只出现在配置文件的一张路由表里。档位比如“快而便宜”“均衡”“深度推理”三档;路由表决定每个档位当前用哪个模型、降级时 fallback 到谁、重试几次、超时多久。模型换了,改路由表一行;用户界面、业务代码、提示词模板都不用动。下面按落地顺序展开,文中的示例项目与配置均为虚构,仅用于说明做法。
第一步:定义三档能力,而不是罗列模型名
先别急着选模型,先定义你的产品到底需要哪几种能力。绝大多数 vibe 项目用三档就够了:快档负责分类、打标签、生成标题、写摘要这类“错了也能忍、要快”的任务;均衡档负责日常对话、改写、问答;推理档负责复杂计算、长文档分析、多步规划这类“错了很贵、值得等”的任务。每一档要写清楚三条硬指标:可接受的最大延迟、单次调用的成本上限、质量底线(比如推理档不允许出现格式错误)。
以虚构示例项目“清账小助手”(一款帮小店主整理发票与流水的应用)为例:发票分类走快档,3 秒内出结果、单次成本压到最低;月度经营问答走均衡档;月底对账与异常排查走推理档,允许等 30 秒,但数字必须可验算。档位一旦定下来,业务代码里就只出现档位名,比如 call_model(tier="fast", ...),永远不出现具体模型名。三个月后你想把快档从 A 模型换成 B 模型,业务代码零改动。
一个常见的反模式是“档位膨胀”:一开始设了八档,什么“创意档”“严谨档”“幽默档”,最后没人记得每档的区别,路由表也维护不动。档位是给系统看的契约,不是给用户看的营销词;三档起步,真的不够再加。
第二步:一张路由表,管住所有切换逻辑
路由表是这套设计的唯一事实来源,建议用一份独立的配置文件(或管理后台的一张表)承载,字段至少包括:档位、主模型、降级链(按顺序的备选模型)、单次超时、最大重试次数、每分钟预算。业务代码在调用前只问路由表一个问题:“快档现在该打给谁?”路由表回答,其余一概不管。
虚构示例:快档主模型为 M1,降级链为 M1 → M2 → M3;均衡档主模型为 M4,降级链为 M4 → M5;推理档主模型为 M6,降级链为 M6 → M4(降档但保证可用),且推理档降档时必须在界面上提示用户。注意推理档的降级链特意没有安排同级备选,因为“深度推理”这个能力本身稀缺,降档是诚实的选择,假装没降级才是欺骗。
路由表还要支持“按任务微调”:同一个档位,不同任务可以有不同的超时与重试。比如快档的发票分类允许重试 2 次,但快档的实时联想输入只允许 1 次——因为用户正在打字等联想,多一次重试就是多一份卡顿。把这些差异写进路由表,而不是散落在业务代码的 if 语句里,否则半年后没人敢动。
第三步:失败要分类,可重试的才重试
降级链不是“失败了就换下一个”这么简单。第一步是给失败分类:429 限流、5xx 服务端错误、超时,属于“换一个可能就好”的可重试失败;400 参数错误、认证失败、内容政策拒绝,属于“换谁都没用”的不可重试失败。对不可重试失败,正确动作是立刻返回清晰的错误,而不是把降级链从头跑到尾,白白烧掉三次成本、让用户多等三倍时间。
第二步是给重试加预算:单次用户请求的总重试次数封顶(建议 2–3 次),总耗时封顶(建议不超过该档延迟上限的 2 倍)。没有预算的重试会在上游故障时演变成重试风暴:你的每个请求变成三个请求,上游更慢,你的重试更多,最后整个服务一起被拖垮。预算写进路由表,调用层统一执行,业务代码不需要知道重试的存在。
第三步是幂等与去重:如果一次调用涉及写操作(如下单、记账、发消息),重试前必须确认前一次是否已生效,否则“重试”会变成“重复执行”。最简单的办法是给每次业务操作一个幂等键,服务端凭键去重。没有幂等保护的写操作,不应该进入自动重试链——宁可返回“请稍后手动重试”,也不要让用户收到两条扣款记录。
第四步:降级发生时,用户应该看得见
降级最大的用户体验错误,是静默降级。用户付费买的是推理档,系统悄悄用均衡档出了结果,用户只会觉得“这次回答怎么变笨了”,然后对产品失去信任——而你甚至不知道信任是在哪一次丢失的。正确的做法是分级透明:免费或低档任务降级,可以只在界面角落留一行小字;付费档或推理档降级,必须明确提示,比如“当前使用均衡模型完成,深度推理模型暂时不可用,本次不计入推理额度”。
透明还要配补偿规则,提前写好、不要临时编:推理档降级是否退额度、是否允许用户选择“等一等再用推理档跑一次”、降级结果是否标注“由备选模型生成”。这些规则应该出现在你的帮助文档里,而不是客服的口头解释里。用户能接受“暂时降级”,不能接受“被蒙在鼓里”。
虚构示例继续:清账小助手的月底对账如果从推理档降到均衡档,界面会同时做三件事:顶部提示降级原因、结果旁标注模型档位、本次不扣推理额度并提供“恢复后重算”按钮。三件事缺一不可,少了任何一件,用户都会觉得自己吃了哑巴亏。
第五步:提示词与工具调用,不能假设所有模型都一样
切换模型时最容易翻车的地方,不是路由表,而是提示词与工具格式的差异。不同模型对系统提示词的服从程度不同,对 JSON 输出的稳定性不同,对工具调用格式的支持也不同。一个在主模型上表现完美的提示词,换到备选模型上可能出现格式错误、字段缺失、甚至拒绝调用工具。
落地办法有三条。第一,提示词模板与模型解耦:模板里只写任务要求,不写“你是某某模型”这类与模型绑定的假设;模型特有的格式要求(比如 JSON 模式开关、思考预算参数)放在路由表的模型配置里。第二,给每个档位准备“格式校验 + 一次修复”机制:输出格式不对时,先用规则修复一次,修不好再降级,而不是直接把脏数据交给用户。第三,切换模型后必须跑回归:准备 20–50 条该档位的典型用例,记录主模型的输出作为基线,换模型后逐条对比,差异超过阈值就不要上线。
上下文长度是另一个隐形差异:主模型支持 200k 上下文,备选只支持 32k,切换后长文档任务会直接报错。路由表里应该为每个模型写明上下文上限,调用层在发送前检查输入长度,超限时提前截断或走摘要链路,而不是等到上游报错才处理。
第六步:成本与可观测性,没有记录的切换等于没做
每次调用必须记录四件事:请求来自哪个档位、实际打给了哪个模型、耗时多少、花了多少钱(或多少 token)。没有这四条记录,你就回答不了三个关键问题:上个月的账单为什么涨了、某次质量下滑是不是因为降级、某个备选模型到底替你扛了多少流量。记录要落到日志或数据表里,而不是只打在控制台里随风而去。
有了记录,就可以做三件高价值的事。第一,成本仪表:按档位、按模型、按任务出日报,成本异常波动当天就能发现,而不是月底看账单时才发现。第二,降级率告警:某档位的降级率超过阈值(比如 5%)就告警,说明主模型出了问题或路由配置需要调整。第三,定期复盘:每月看一次各档位的实际模型分布,问自己一个问题——备选模型是不是已经悄悄变成了实际主力?如果是,说明主模型选型有问题,该正式换主模型了,而不是永远靠降级链续命。
上线前演练清单:把故障先演一遍
这套设计上线前,建议做四场演练,每场都不需要真实故障。第一场,强制降级演练:把主模型在配置里临时指向一个必定失败的地址,确认降级链能走到备选、用户能看到提示、重试预算没有超支。第二场,超时演练:把超时设得很短,确认慢请求会被及时切断而不是无限挂起。第三场,长输入演练:用超长文档打备选模型,确认截断或摘要链路能兜底。第四场,账单演练:模拟一次高峰,确认成本仪表能实时反映调用量,而不是事后补算。
演练的意义不在于证明系统完美,而在于把“第一次真实故障”变成“第二次演练”。第一次真实故障发生在深夜、用户正在用、你正在睡觉的时候;演练发生在白天、你可以从容看日志的时候。两者成本差了十倍不止。
反模式清单:这六件事不要做
最后列六个反模式,写代码时逐条对照。第一,模型名散落在业务代码里,换模型等于全站搜索替换。第二,降级链无限重试,故障时自己把自己打垮。第三,对不可重试错误也走降级链,白白烧钱又拖时间。第四,付费档静默降级,用户发现后信任归零。第五,切换模型不跑回归,格式错误直接流到用户面前。第六,没有调用记录,账单涨了都不知道是谁花的。六条里只要中了一条,模型切换这件事就还没有真正落地;六条全避开,你的产品就具备了在这个模型快速更替的行业里长期生存的基础设施。
附:一张路由表的最小字段模板
把前面讲的字段收敛成一份可以直接抄的模板(虚构配置,仅作示例)。每个档位一条记录,字段包括:档位名、主模型、降级链、单次超时(毫秒)、最大重试次数、单请求总耗时上限、上下文上限、是否允许降级、降级时是否提示用户、单次成本上限。快档示例:主模型 M1,降级链 M1 → M2,超时 8 秒,重试 1 次,总耗时上限 15 秒,允许降级且不强制提示。推理档示例:主模型 M6,降级链 M6 → M4,超时 60 秒,重试 1 次,总耗时上限 120 秒,允许降级但必须提示用户并免除推理额度。
模板落地的关键是“只改表、不改代码”:新增备选模型、调整超时、更换主模型,都应该是改配置并重新加载,而不是重新部署业务代码。配置变更本身也要留痕——谁在什么时候把主模型从 M1 换成了 M2,出了问题才能回溯。很多团队的路由表一开始是配置文件,后来长成了管理后台,这都是正常的演进;不正常的是路由逻辑散落在三个地方,改一处漏两处。
什么时候不该做模型切换
模型切换不是所有产品的必答题,有三种情况可以先不做。第一,你的产品只有一个模型调用点、且该调用对质量极其敏感(比如法律文书生成),这时“换模型”本身就是一次需要评审的产品变更,不适合做成自动降级;正确做法是故障时明确报错并排队重试,而不是悄悄换一个质量未经验证的模型出结果。第二,实时性要求极高的场景(比如语音对话的逐字流式输出),降级链带来的额外延迟可能比失败本身更糟;这类场景应该优先保证快速失败与清晰提示。第三,受合规约束、必须固定模型版本的场景(比如医疗、金融的审计要求),切换模型可能违反版本锁定承诺,必须先确认合规边界再动手。
判断标准其实只有一条:降级的结果质量是否仍然在你的质量底线之上。如果答案是“不知道”,就先不要自动降级——把降级做成人工确认的选项,或者干脆只做手动切换。自动降级的前提,是你已经用回归用例验证过备选模型的质量;没有验证的自动降级,不是容灾,是赌博。
灰度、回滚与事后复盘:切换功能自己的生命周期
模型切换功能本身也需要一套上线流程,不能因为它是“兜底”就绕过常规发布纪律。建议先按用户比例灰度:第一批只放百分之五的流量走新路由表,观察一周的失败率、延迟分布和用户反馈,确认没有异常再逐步放大。灰度期间要单独看两个指标:一个是切换触发率,也就是有多少请求实际走了降级链;另一个是降级后的质量抽查结果,抽查不能只看自动评分,至少要人工抽看一部分真实输出,确认降级模型没有系统性地答非所问。两个指标有一个异常,就先停在当前比例,不要为了赶进度继续放大。
回滚方案要写在切换功能上线之前,而不是出事之后再想。回滚至少要覆盖三种情况:路由表配置写错导致大量请求走错模型、某个备选模型突然不可用或质量滑坡、以及降级提示本身引发用户投诉。每种情况都要有一个不需要改代码的止血动作,比如一键切回固定模型、一键关闭自动降级只保留手动切换。回滚动作还要演练过一次:演练时用测试流量真实触发一次,确认开关确实生效、监控确实能看到流量变化。没有演练过的回滚方案,和没有回滚方案区别不大,关键时刻没人敢按一个从没按过的按钮。
每次真实降级发生后,都值得做一次轻量复盘,复盘不用写成长篇报告,回答三个问题就够了:这次降级是不是必要的,也就是主模型的问题是否真实存在;降级后的质量是否达标,用户有没有感知到明显变差;以及下一次遇到同样情况,路由表要不要调整阈值或顺序。把这三个答案记在路由表的变更记录里,几个月下来,路由表就从“凭感觉写的配置”变成了“有依据调出来的配置”。模型切换做到这个程度,才算真正从一次性功能变成了产品能力,而不是上线那天好看、之后没人敢动的摆设。
评论 (0)
相关文章
不用走应用商店审核:HTTPS、Manifest 与 Service Worker 齐备,用户就能把你的网页应用装进主屏幕。本文讲清清单字段、缓存策略、提示时机、iOS 手动步骤与 30 分钟上线演练。
OpenAI 为单仓重写了 Git 后端 Pando:按分支独立协调、复用 pack 而不是给每个客户端现算。推送延迟中位数降近 5 倍、日交付近 1PB——但这些数字只能按一家公司的自述来读。本文拆解它放弃的两样东西与三条可迁移的启示。
GitHub Agentic Workflows 正式可用:用自然语言写 Markdown,编译成标准 Actions YAML,让编码 agent 在 Actions 里跑仓库杂活。本文拆解 GA 的五项增量、安全三层设计,以及现阶段不适合交给它的三类场景。