上线就有“为你推荐”:vibe 项目推荐系统的冷启动三阶实战
没算法团队也能做推荐:规则推荐第1天上线、协同过滤接几百条行为、向量召回等内容上量——三阶路线图,全部 SQL 与脚本可直接复制运行,附冷启动三难解法与 8 个踩坑。
上线第一周,用户打开你的 vibe 项目,首页只有冷冰冰的"最新发布"列表——这就是 90% 一人项目的现状。"推荐系统"听起来像是大厂才玩得起的东西:算法团队、实时特征工程、海量样本。但真相是:推荐系统是分层的。你可以在第 1 天用几十行 SQL 上线"为你推荐"的雏形,在攒下几百条行为数据后加上协同过滤,在内容上量之后再接向量召回——每一阶都有明确的进入条件、实现代码和退出标准。这篇指南给你的就是这套三阶路线图:所有 SQL 和脚本都可以直接复制进你的 Postgres + cron 项目里跑起来。
先划清四条边界:这篇不讲什么
VibeFix 站内已经有几篇"看起来很像"的指南,为避免你走错片场,先划界:《邀请裂变(referral-program)》讲的是营销侧的拉新——让用户把朋友带进来;本篇讲的是产品内的个性化推荐——用户进来之后看什么。一个管"进门",一个管"进门之后",互补不重叠。《上线首日(launch-day)》讲的是产品冷启动——第一批用户从哪来;本篇讲的是算法冷启动——数据稀疏时推荐怎么做,一个是获客问题,一个是数据问题。《全文搜索(search)》讲的是用户主动检索——"我想找";本篇讲的是系统主动分发——"你可能想看"。检索是拉,推荐是推。四者正交,各管一摊,缺一不可。
一、先别谈算法:推荐的三种真实形态与 ROI
独立开发者最常见的错误,是上来就问"我该用协同过滤还是深度学习"。错的问题。先回答业务问题:你要做的推荐长什么样? vibe 项目里推荐只有三种真实形态:
- 内容流"为你推荐":首页信息流,千人千面。典型:资讯站、社区、灵感库。技术要求最高,用户感知最强。
- 相关推荐:详情页底部的"相关内容 / 猜你喜欢"。典型:博客、工具站、作品集。实现成本最低,ROI 最高——用户已经表现出兴趣(点进了一篇),顺手再推三篇,转化率天然高。
- 个性化首页排序:首页还是那些模块,但顺序按人调整。典型:素材库、模板站。介于两者之间。
决策表——按你的项目类型选第一形态:
- 内容型 / 社区型(文章、帖子、灵感)→ 先做内容流,再补相关推荐。
- 工具型 / 作品集(单个工具页、项目展示)→ 只做相关推荐就够了,内容流是过度设计。
- 资源库型(模板、素材、API 目录)→ 先做相关推荐,数据上来后加个性化排序。
一句话总结:先选形态,再谈技术。本指南的三阶路线默认按"内容流"这个最难的形态讲——如果你只做相关推荐,直接用第一阶的标签匹配或第三阶的向量近邻,一节就够。
二、数据先行:推荐可用的最小埋点集
没有行为数据,一切算法都是空谈。但别被"大数据"吓住:推荐可用的最小埋点集只有四个事件,一张表起步:
- impression(曝光):内容出现在用户屏幕上。这是分母——没有曝光,你算不出 CTR,分不清"用户不喜欢"和"用户没看到"。
- click(点击):用户点了。这是最基础的正样本。
- dwell(停留):带
duration_ms。点进去 3 秒就关和读了 5 分钟,是两种完全不同的信号。 - favorite(收藏):强正样本,一条收藏顶十次点击。
每个事件必须带四个字段:user_id、item_id、服务端时间戳、曝光位置(position,后面做位置偏差校正要用)。表结构如下,Postgres 一张表起步:
CREATE TABLE reco_events (
  id          BIGSERIAL PRIMARY KEY,
  user_id     TEXT NOT NULL,
  item_id     TEXT NOT NULL,
  event       TEXT NOT NULL CHECK (event IN ('impression','click','dwell','favorite')),
  duration_ms INT,              -- 仅 dwell 事件有值
  position    INT,              -- 曝光时的列表位置(1 起始)
  surface     TEXT NOT NULL,    -- 'home_feed' | 'related' | 'search' 等
  created_at  TIMESTAMPTZ NOT NULL DEFAULT now()
);
CREATE INDEX idx_reco_events_user ON reco_events(user_id, created_at DESC);
CREATE INDEX idx_reco_events_item ON reco_events(item_id, event, created_at DESC);
CREATE INDEX idx_reco_events_time ON reco_events(created_at DESC);
三条埋点军规:① 事件名全局统一,大小写、单复数先定死;② user_id / item_id 永不为空——未登录用户用匿名 ID(如 localStorage 生成的 UUID),否则你的"新用户"永远进不了协同过滤;③ 时间戳用服务端时间,前端传的时间戳有时钟漂移,排序会乱。埋点先行、算法随后:这张表是第 1~3 阶共同的唯一数据源,后面三阶"只加字段、不改表"。
三、第一阶·规则推荐:0 用户也跑得起来
进入条件:无。上线第 1 天就能跑,不需要任何行为数据。规则推荐 = 编辑精选 + 热度榜 + 标签匹配的加权排序,纯 SQL 实现,每天凌晨 cron 跑一次,结果写进物化表,在线接口只读表。
加权公式(先记住它,后面两阶只是换了其中几项的计算方式):
score = w1 × 热度 + w2 × 新鲜度 + w3 × 标签匹配 + w4 × 编辑加权- 热度:过去 7 天点击数的对数归一化,
ln(1 + clicks_7d) / ln(1 + max_clicks_7d)。取对数是为了压住头部爆款,否则榜单前三永远不变。 - 新鲜度:
exp(-age_hours / 72),72 小时衰减到约 37%。新内容没有行为数据时,全靠这一项出头。 - 标签匹配:用户历史点击内容的标签集合,与候选内容标签的 Jaccard 相似度。新用户没有历史时这一项为 0,自动退化成"热度 + 新鲜度"。
- 编辑加权:人工精选的内容给固定加分(如 +0.3),这是你的"运营之手",冷启动期最重要的杠杆。
权重起点:w1=0.5, w2=0.3, w3=0.2, w4=0.3(加分项)。内容冷启动期(新内容多、老内容少)把 w2 调到 0.5;内容池稳定后调回。完整 SQL 如下,假设内容表叫 items(id, tags TEXT[], is_featured BOOL, published_at):
-- 每天凌晨跑一次,结果写入 reco_rule_scores(item_id, score)
WITH heat AS (
  SELECT item_id,
         ln(1 + COUNT(*) FILTER (WHERE event = 'click')) AS h
  FROM reco_events
  WHERE created_at > now() - INTERVAL '7 days'
  GROUP BY item_id
),
maxh AS (SELECT COALESCE(MAX(h), 1) AS m FROM heat),
user_tags AS (
  -- 目标用户最近 30 天点击内容的标签集合(新用户返回空集)
  SELECT array_agg(DISTINCT t) AS tags
  FROM reco_events e, items i, unnest(i.tags) t
  WHERE e.user_id = :uid AND e.event = 'click'
    AND e.created_at > now() - INTERVAL '30 days'
    AND e.item_id = i.id
)
INSERT INTO reco_rule_scores(item_id, score, computed_at)
SELECT i.id,
       0.5 * COALESCE(h.h / maxh.m, 0)
     + 0.3 * exp(-EXTRACT(EPOCH FROM (now() - i.published_at)) / 3600 / 72)
     + 0.2 * COALESCE(
           cardinality(i.tags & (SELECT tags FROM user_tags))::float
           / NULLIF(cardinality(i.tags | (SELECT tags FROM user_tags)), 0), 0)
     + CASE WHEN i.is_featured THEN 0.3 ELSE 0 END,
       now()
FROM items i
LEFT JOIN heat h ON h.item_id = i.id
CROSS JOIN maxh
WHERE i.published_at > now() - INTERVAL '90 days'  -- 只推 90 天内的内容
ON CONFLICT (item_id) DO UPDATE SET score = EXCLUDED.score, computed_at = now();在线接口就一行:SELECT item_id FROM reco_rule_scores ORDER BY score DESC LIMIT 20,P95 轻松 < 20ms。退出标准:当 reco_events 去重用户超过 100 且事件行数超过 500,进入第二阶——但规则榜永远保留,作为所有异常的兜底(见第九节)。
四、第二阶·协同过滤:有几百个行为后
进入条件:reco_events 事件行数 > 500 且去重用户 > 100。核心思想一句话:"喜欢 A 的人都喜欢 B,那你看了 A 就推 B"。对一人项目,用基于物品的协同过滤(Item-based CF):它比基于用户的稳定(物品相似度变化慢),且天然适合"相关推荐"形态。
第一步,把隐式反馈转成"评分"。没有打分?自己造:一次点击 = 1 分,停留超 30 秒 = 2 分,收藏 = 5 分。同一用户对同一物品取最高分,得到用户-物品矩阵。第二步,算物品两两之间的余弦相似度:两个物品的"喜欢它们的用户向量"夹角越小,越相似。第三步离线算好、回写数据库——千万别在线实时算,那是拖垮主库的捷径(见第十节坑③)。
下面是一个可直接跑的离线脚本(依赖只有 psycopg2 和 numpy),建议每天凌晨 cron 跑一次:
import numpy as np, psycopg2

conn = psycopg2.connect("dbname=yourdb")
cur = conn.cursor()
# 1. 拉 90 天内的隐式反馈:click=1, dwell>30s=2, favorite=5,取最大
cur.execute("""
  SELECT user_id, item_id,
         MAX(CASE WHEN event='favorite' THEN 5
                  WHEN event='dwell' AND duration_ms > 30000 THEN 2
                  WHEN event='click' THEN 1 ELSE 0 END) AS r
  FROM reco_events
  WHERE created_at > now() - INTERVAL '90 days'
  GROUP BY user_id, item_id HAVING MAX(...) > 0
""")
rows = cur.fetchall()
users = {u: i for i, u in enumerate({r[0] for r in rows})}
items = {t: j for j, t in enumerate({r[1] for r in rows})}
M = np.zeros((len(users), len(items)))
for u, t, r in rows:
    M[users[u], items[t]] = max(M[users[u], items[t]], r)

# 2. 物品-物品余弦相似度(列向量归一化后点乘)
col = M.T
norm = np.linalg.norm(col, axis=1, keepdims=True) + 1e-9
sim = (col / norm) @ (col / norm).T

# 3. 每个物品保留 top-50 相似,回写 reco_item_sim(item_a, item_b, score)
cur.execute("TRUNCATE reco_item_sim")
inv = {j: t for t, j in items.items()}
batch = []
for j in range(len(items)):
    top = np.argsort(-sim[j])[1:51]  # 跳过自己
    for k in top:
        if sim[j, k] > 0.05:  # 相似度阈值,过滤噪声
            batch.append((inv[j], inv[k], float(sim[j, k])))
cur.executemany(
    "INSERT INTO reco_item_sim(item_a, item_b, score) VALUES (%s,%s,%s)", batch)
conn.commit()
print(f"users={len(users)} items={len(items)} pairs={len(batch)}")
在线召回逻辑(伪代码,三行):取用户最近点击的 10 个物品 → 查 reco_item_sim 取每个物品的 top-20 相似 → 按 score × 用户对原物品的评分 加权合并、去重、取 topK。注意两个细节:① 只用 90 天数据,冷热行为混存是坑②;② 相似度低于 0.05 的直接丢掉,否则长尾噪声会把推荐带偏。退出标准:物品数超过 2000,或标签体系开始失控(新标签层出不穷、Jaccard 算不动了),进入第三阶。
五、第三阶·向量召回:内容多了以后
进入条件:物品数 > 2000,或协同过滤的物品相似度矩阵开始稀疏到没法看。向量召回解决的是语义鸿沟:用户看了一篇"用 AI 做播客封面",标签匹配只能找到同样打了"播客"标签的,而向量能找到"AI 生成专辑封面"——标签不同、意思相近。
最小链路只有四步,全部可以跑在你现有的 Postgres 里,不需要另起向量数据库:
- ① 生成 embedding:标题 + 摘要拼成文本,调 embedding 模型转成向量。新内容发布时触发一次,老内容每周全量补一次。
- ② 存 pgvector:Postgres 装
pgvector扩展,向量直接存在内容表的一列里。 - ③ 建 ANN 索引:HNSW 索引,近似最近邻检索,万级内容毫秒返回。
- ④ 在线检索:用户画像向量(他看过内容的向量平均)或单篇内容向量,一条 SQL 找出最相似的 50 篇。
-- 1. 装扩展、加列(一次操作)
CREATE EXTENSION IF NOT EXISTS vector;
ALTER TABLE items ADD COLUMN embedding vector(1024);
-- 2. HNSW 索引:m=16、ef_construction=64 是万级数据的甜点参数
CREATE INDEX idx_items_embedding
  ON items USING hnsw (embedding vector_cosine_ops)
  WITH (m = 16, ef_construction = 64);
-- 3. 在线检索:和"用户画像向量"最相似的 50 篇(<=> 是余弦距离)
SELECT id, title
FROM items
WHERE embedding IS NOT NULL
ORDER BY embedding <=> $1
LIMIT 50;
成本账(独立开发者最关心的部分):embedding 模型选 bge-m3(1024 维,开源可本地跑),边际成本为 0,一台 2 核云服务器每分钟能转几百篇;如果不想自己运,用 OpenAI text-embedding-3-small 约 $0.02 / 1M tokens——一篇 500 字文章约 700 tokens,1 万篇内容一次性向量化约 $0.14,之后每天增量几分钱。pgvector 就在你现有的 Postgres 里,0 新增基础设施。维度千万别贪:1024 维足够,4096 维存储 ×4、检索变慢,质量提升不到 1%(第十节坑①)。用户画像向量 = 该用户近 30 天点击内容向量的加权平均(收藏权重 5、长停留 2、点击 1),每周离线算一次存 reco_user_vec 表,在线只做一次向量检索。
三阶不是替代关系,是叠加关系:最终在线策略 = 向量召回 50 条 + 协同召回 30 条 + 规则榜 20 条 → 去重 → 按"规则公式"重排(复用第三阶的加权公式,只是候选集变大了)。图 1 是这套链路的全貌:

图 1:三阶推荐链路架构。同一张 reco_events 表喂三路离线计算,cron 定时算、结果回写 Redis / 物化表;在线服务只读缓存,P95 < 50ms,离线挂了由降级开关接管。
六、冷启动三难:解法对照表
推荐系统的冷启动不是一种,是三种,解法完全不同。新用户(没有行为历史)、新物品(零曝光零点击)、新系统(整站无数据)——每种各三招,组合使用:
- 新用户 × 招式一「热门兜底」:全站热度榜直接顶上,保证首屏不空。这是最low但最有效的一招:没人会因为"推荐不够个性化"流失,但会因为"首页是空的"流失。
- 新用户 × 招式二「兴趣问卷」:首访让用户选 3 个感兴趣的标签,一次点击即画像。别做 20 道题的问卷,3 个标签 + 可跳过,转化率才保得住。
- 新用户 × 招式三「种子触发」:用户看完第 1 篇内容,立刻用"这篇的相似内容"(协同/向量)跟进。从第 2 次曝光起,推荐就已经是个性化的了。
- 新物品 × 招式一「内容画像」:标题 + 标签转 embedding,发布即有向量。零行为也能被向量召回捞到,这是向量阶对冷启动最大的结构性贡献。
- 新物品 × 招式二「新手保护期」:发布 24–72 小时内曝光加权 ×2 起步再衰减。实现:在规则公式里给
age_hours < 72的内容加+0.2 × (1 - age_hours/72)。没有保护期,新内容永远打不过老爆款。 - 新物品 × 招式三「编辑精选位」:人工位强制曝光。冷启动期你的"运营之手"比任何算法都管用。
- 新系统 × 招式一「规则先行」:第 1 天只上规则推荐,0 数据照样跑。这是本指南第一阶存在的全部理由。
- 新系统 × 招式二「日志回灌」:如果你之前有访问日志(Nginx 日志、旧版埋点),离线解析回填
reco_events,白捡一批行为数据。 - 新系统 × 招式三「运营兜底」:冷启动期用人工编辑精选流代替算法流,先让首页好看,再让首页聪明。

图 2:冷启动三难解法矩阵。三难可叠加——新系统上线的新用户看新物品,组合就是"规则榜 + 兴趣问卷 + 新手保护期"。
七、评测:离线 hit-rate@K 与在线 CTR/停留双指标
推荐系统不上评测,等于闭眼开车。你需要两套指标,一套离线(调参用)、一套在线(看业务用),缺一不可。
离线指标:hit-rate@K。做法叫"留一法":对每个用户,藏起他最后一次点击的内容,用他之前的历史做推荐,看 topK 里有没有命中藏起来的那篇。命中率 = 命中用户数 / 总用户数。K 取你首页一屏的数量(如 10)。每周跑一次,脚本 20 行:
-- hit-rate@10 留一法评测(Postgres 版,离线跑)
WITH last_click AS (
  SELECT DISTINCT ON (user_id) user_id, item_id AS held_out
  FROM reco_events WHERE event = 'click'
  ORDER BY user_id, created_at DESC
),
hist AS (  -- 藏起最后一次点击之前的历史
  SELECT e.user_id, e.item_id
  FROM reco_events e JOIN last_click l
    ON e.user_id = l.user_id AND e.event = 'click'
   AND e.created_at < (SELECT MAX(created_at) FROM reco_events
                         WHERE user_id = l.user_id AND item_id = l.held_out)
),
-- 用"历史点击物品的相似物品"做 top10 推荐(复用 reco_item_sim)
rec AS (
  SELECT h.user_id, s.item_b AS item_id,
         ROW_NUMBER() OVER (PARTITION BY h.user_id ORDER BY s.score DESC) AS rn
  FROM hist h JOIN reco_item_sim s ON s.item_a = h.item_id
)
SELECT COUNT(*) FILTER (WHERE r.item_id = l.held_out)::float / COUNT(*)
       AS hit_rate_at_10
FROM last_click l LEFT JOIN rec r
  ON r.user_id = l.user_id AND r.rn <= 10;
在线指标:CTR + 人均停留时长,双指标缺一不可。CTR = 点击 / 曝光,只看 CTR 会养出标题党(用户点了就关);只看停留,会养出又臭又长的裹脚布。两个一起涨,才是真优化。注意 CTR 必须用曝光归因:点击发生时,回查该内容最近一次曝光的 position 和 surface,否则你分不清"推荐得好"和"位置好"。
A/B 分流的最小实现:按 user_id 哈希分桶,一行代码,实验组走新策略、对照组走老策略。分流原理和显著性判断,站内已发的 《A/B 测试(ab-testing-experiment)》指南讲得很透,这里不重复——只给最小可用代码:
import hashlib
def bucket(user_id: str, n: int = 100) -> int:
    return int(hashlib.md5(user_id.encode()).hexdigest(), 16) % n

# bucket < 50 → 对照组(规则推荐);bucket >= 50 → 实验组(新策略)
# 评测时按 surface + bucket 分组对比 CTR,跑满 7 天再看结论
上线新策略的流程固定为:离线 hit-rate@K 先涨 → 灰度 10% 用户跑 7 天 → 在线 CTR/停留双指标确认 → 全量。跳过任何一步,都是在赌。
八、反作弊与多样性:别让推荐变成复读机
推荐系统上线后第一个月,你会遇到两类敌人:刷榜的人,和"越推越窄"的算法自己。
反作弊三招:① 同一 user_id 10 分钟内点击同一作者超过 5 次,降权该作者内容 50%(SQL 里加个惩罚系数就行);② 注册 24 小时内的新账号行为不计入热度榜,只计入个人推荐——羊毛党刷的是榜,不是你;③ 曝光-点击时间间隔 < 1 秒的视为误触,不计正样本。这三招能挡住 95% 的小作坊刷榜。真遇到专业黑产,那是站内已发的《反作弊(fraud-prevention)》指南的领地,设备指纹那套这里不展开。
多样性三招:① 新颖性惩罚:同一内容对同一用户曝光 3 次未点击,7 天内不再推。实现:查 reco_events 里该用户对该内容的 impression 计数。② 标签配额:top20 里同一标签不超过 40%,强制留出口子给长尾。③ 作者去重:top20 里同一作者最多 3 篇。记住一句话:推荐的目标不是"猜得最准",是"让用户明天还想打开"。一个全是同类爆款的首页,CTR 可能短期涨 10%,但 30 日留存会掉——多样性是留存的保险。
九、降级开关:推荐服务挂了,首页不能挂
推荐是"锦上添花"型功能,它的故障等级永远不能高于首页本身。三条防线,代码量很小,缺一不可:
防线一:超时熔断。推荐接口超时阈值设 300ms,超时直接走规则榜。用户看到"稍微不那么个性化"的首页,总比看到转圈圈好。
防线二:空结果兜底。任何一路召回返回空(新用户、向量表没建好、cron 挂了),自动降级到规则榜。规则榜是全站最后的底线——它只依赖 reco_rule_scores 表,而这张表第 1 天就有。
防线三:手动总开关。一个环境变量 / 配置项,一键切回纯规则推荐。半夜 cron 把数据写坏了,你不需要改代码上线,直接翻开关等天亮。
import os, time

RECO_TIMEOUT_MS = 300
# 防线三:手动总开关,RECO_MODE=rule 时全站只走规则榜
FORCE_RULE = os.getenv("RECO_MODE", "smart") == "rule"

def get_home_feed(user_id: str, limit: int = 20):
    if not FORCE_RULE:
        try:
            start = time.time()
            recs = smart_recall(user_id, limit)  # 向量+协同+规则三路合并
            cost_ms = (time.time() - start) * 1000
            # 防线一:超时熔断;防线二:空结果兜底
            if recs and cost_ms < RECO_TIMEOUT_MS:
                return recs
        except Exception as e:
            log_error("reco_failed", e)  # 记日志、触发告警,但不抛给用户
    # 兜底:永远有内容的规则榜
    return rule_rank(user_id, limit)

# 连续 5 次 smart_recall 失败 → 自动把 RECO_MODE 翻成 rule 并告警,
# 由 cron 健康检查做,代码略(查 reco_health 表的失败计数即可)记住这个顺序:先写降级,再写推荐。降级开关是推荐系统第 0 行代码。
十、8 个踩坑:前人交过的学费
- 坑① embedding 维度选错:一上来就用 4096 维的大模型向量,pgvector 存储 ×4、HNSW 检索变慢,质量提升不到 1%。万级内容 1024 维(bge-m3)是甜点,十万级再考虑 1536。
- 坑② 冷热数据混存:把 3 年前的点击和昨天的点击等权计算,用户兴趣早就变了。所有离线脚本统一加 90 天窗口,规则榜热度只看 7 天。
- 坑③ 实时更新拖垮主库:每次点击都触发一次相似度重算,主库 CPU 直接打满。离线算 + cron 回写是在线系统的铁律,实时最多做到"准实时"(5 分钟一批)。
- 坑④ 把推荐做成黑盒:每条推荐记
reason字段("因为你看了《X》"/"本周热门")。用户问"为什么推这个",你答不上来,信任就没了;调试时没有 reason,你也定位不了问题。 - 坑⑤ 忽略位置偏差:排第 1 的内容 CTR 天然是第 10 位的 3 倍——不是它更好,是位置更好。用曝光位置做归一(点击 / 该位置期望 CTR),否则你的"热度榜"只是在复读排版。
- 坑⑥ 只推热门:纯热度排序的首页,3 天后就变成榜单复读机。热度权重超过 0.7 就是危险信号,用新鲜度 + 多样性配额对冲。
- 坑⑦ 协同过滤的冷物品永无出头之日:零行为的物品相似度全是 0,永远进不了召回。必须配第六节的新手保护期 + 内容画像(向量),让新物品有第一批曝光。
- 坑⑧ 上线不评测:没有 hit-rate@K 基线就上线"优化版",涨跌全靠感觉。先跑两周基线数据,再谈优化——第七节的评测脚本就是干这个的。
最后送你一张行动清单,按顺序打勾:① 今天:建 reco_events 表,四事件埋点上线;② 本周:规则推荐 SQL + cron + 降级开关,首页出现"为你推荐";③ 有 500 条行为后:协同过滤脚本上线,A/B 跑 7 天;④ 内容破 2000:pgvector 向量召回接进来。推荐系统不是百米冲刺,是三阶接力——每一阶上线那天,你的用户都会觉得"这个站变聪明了"。
评论 (0)
相关文章
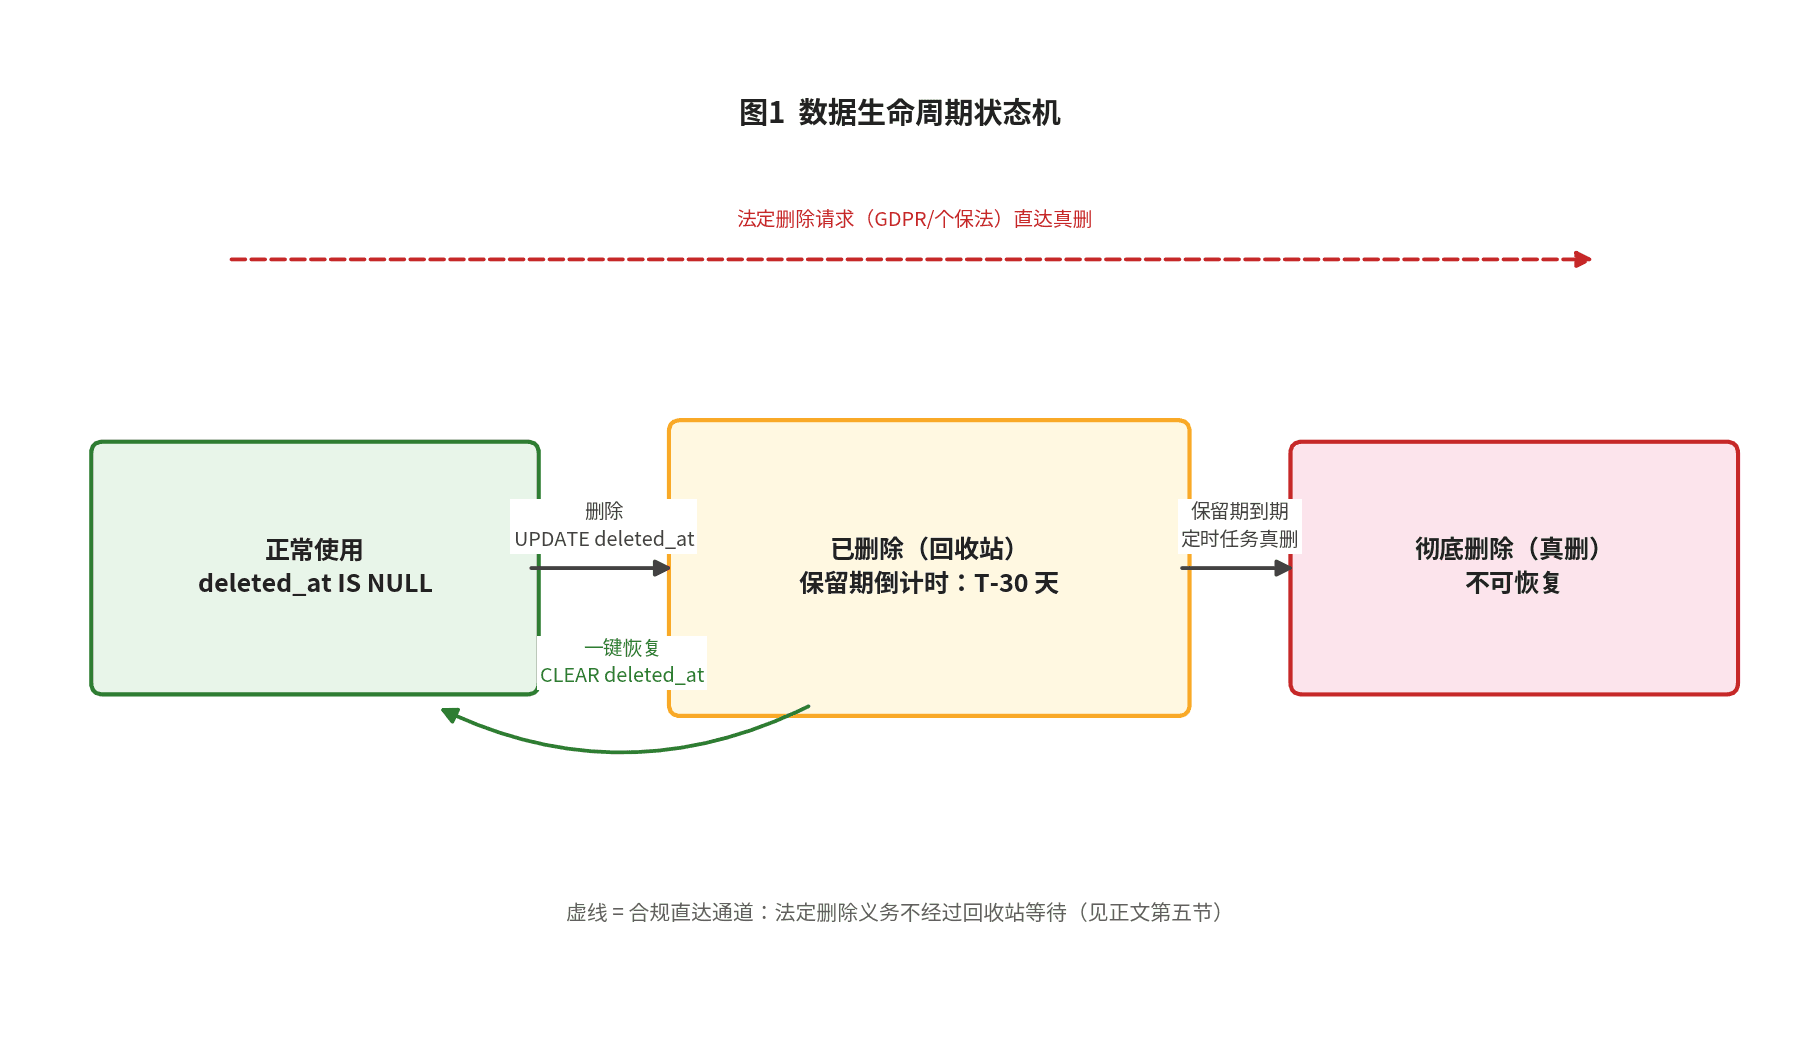
备份是最后的防线,回收站是第一道。这篇实战指南讲应用层的删除语义:三种删除语义决策表、deleted_at 数据模型、partial 唯一索引、Prisma 查询层防线、回收站保留期分级、GDPR 与个保法删除权对账,以及 8 项上线 checklist。
备份回答的是数据丢没丢,灾难恢复回答的是丢了之后多久能回来、回来多少。这篇实战指南覆盖 RPO/RTO 定级、五种故障场景矩阵、Postgres/Supabase/Neon/SQLite 四套可直接抄的 PITR 方案、每周自动恢复演练脚本、一页纸 runbook 模板与降级开关。
console.log 里躺着用户邮箱和登录 token?这篇指南给你一人团队一天能落地的日志脱敏全方案:PII 四级分级表、可直接复制的 TypeScript 脱敏三件套、console.log 到 pino 的最小迁移、请求日志中间件模板、Sentry beforeSend 配置、分级保留策略与成本账,外加 8 个真实踩坑。