别让删除成为单行道:vibe 项目的软删除与回收站实战
备份是最后的防线,回收站是第一道。这篇实战指南讲应用层的删除语义:三种删除语义决策表、deleted_at 数据模型、partial 唯一索引、Prisma 查询层防线、回收站保留期分级、GDPR 与个保法删除权对账,以及 8 项上线 checklist。
先划界:备份是最后的防线,回收站是第一道
站内那篇《没点过恢复按钮的备份都是纸:vibe 项目的数据库备份与灾难恢复实战》讲的是基础设施层:RPO/RTO 定级、PITR 时间点恢复、每周一次的恢复演练——回答的是"数据真丢了,怎么从备份里捞回来"。那是最后的防线。
本篇讲的是应用层:用户亲手点下"删除"按钮的那一刻,你的系统里应该发生什么。备份解决的是"硬盘坏了、库被 Agent 删了"这种灾难;回收站解决的是更常见、更恼人的一幕——用户自己删错了东西,然后给你发工单:"能帮我找回来吗?"备份是最后的防线,回收站是第一道。这篇讲第一道。
一、三种删除语义对照:先选对,再动手
独立开发者最容易犯的错误,不是没做删除功能,而是把所有删除都做成同一种。AI 生成代码尤其喜欢干脆利落的 DELETE FROM——它不知道"删错了"这个选项真实存在。先看清三种语义的差别:
| 维度 | 硬删除 | 软删除(deleted_at) | 回收站(软删除 + 保留期 + 一键恢复) |
|---|---|---|---|
| 实现 | DELETE FROM,行物理消失 | 打标记 deleted_at = now(),行还在 | 软删除 + 用户可见的恢复入口 + 到期自动清理 |
| 用户感知 | "删了" | "删了" | "删了,但 30 天内能找回来" |
| 恢复成本 | 只能翻备份,按小时计 | 一条 UPDATE,按秒计 | 用户自助,零客服成本 |
| 存储成本 | 零 | 保留已删数据 | 保留已删数据 + 回收站 UI |
| 适用 | 测试数据、法定必须真删的数据 | 核心业务数据默认选项 | 用户亲手创建的内容:文档、项目、笔记、文件 |
| 不适用 | 任何用户可能后悔的数据 | 需要向用户承诺"彻底删除"的场景 | 合规要求立即真删的删除权请求(见第五节) |
给独立开发者的默认答案很直接:业务数据默认软删除,用户内容再加一层回收站产品化,硬删除是需要审批的例外。删除语义是产品决策,不是数据库细节——它决定了你凌晨三点被工单叫醒时,手里有没有牌可打。
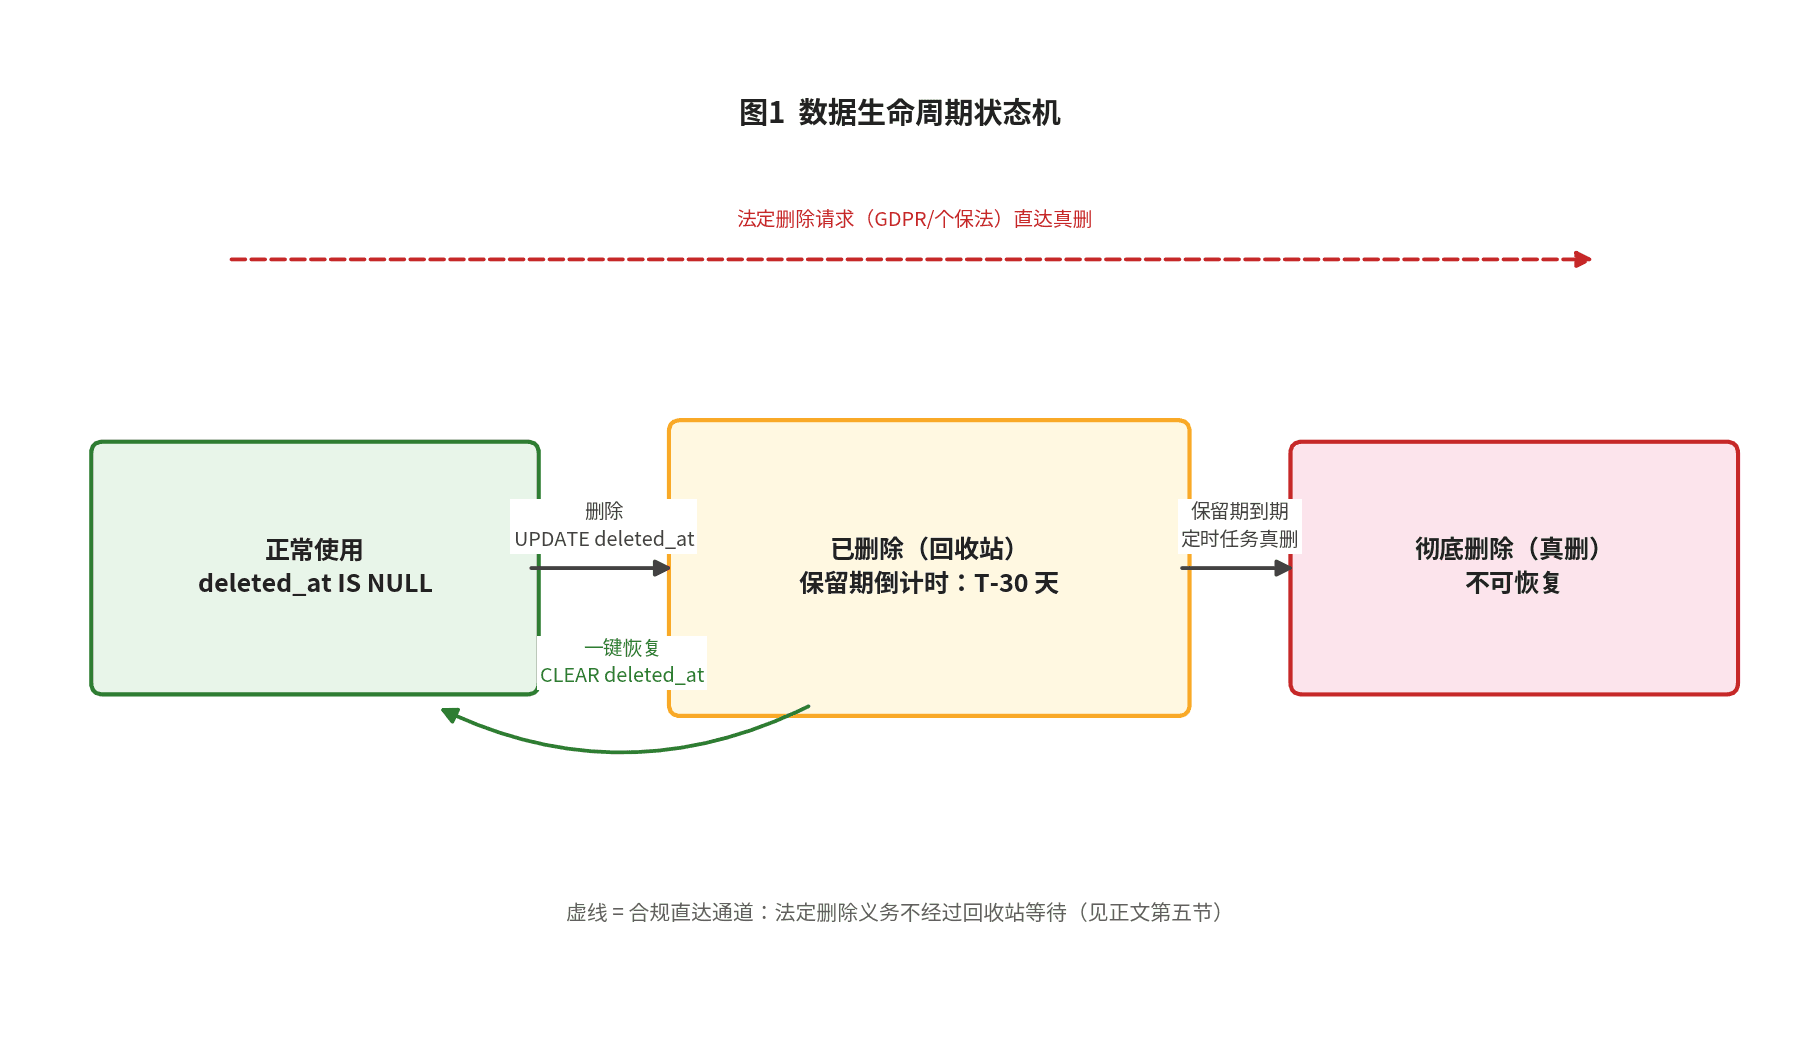
三种语义本质上是一个状态机,数据的完整生命周期如图 1。注意那个"保留期倒计时"分支:它是回收站和裸软删除的本质区别——软删除回答"删没删",回收站回答"还能不能回来、什么时候彻底没"。
" alt="数据生命周期状态机:正常使用→已删除(回收站)→恢复回到正常,或保留期到期后彻底删除;法定删除请求可直达彻底删除">图 1:数据生命周期状态机。关键分支有三条:正常删除进回收站开始倒计时;倒计时内用户可一键恢复;倒计时结束自动真删。法定删除请求(GDPR/个保法)走直达通道,不进回收站等待——这条线的存在是合规要求,第五节细讲。
二、数据模型:deleted_at 的三个工程决策
决策 1:deleted_at,不用 is_deleted
给每张业务表加一个可空的时间戳字段:
-- 迁移示例(Postgres)
ALTER TABLE projects ADD COLUMN deleted_at TIMESTAMPTZ NULL DEFAULT NULL;
CREATE INDEX idx_projects_deleted_at ON projects (deleted_at);
为什么不用布尔型的 is_deleted?三条理由都很实在:第一,删除时间本身是审计资产——"这条数据什么时候删的"决定了保留期倒计时从哪天开始算,布尔值给不了你这个;第二,布尔值方案迟早要加第二个字段(删于何时/何人),不如一步到位;第三,deleted_at IS NULL 就是"正常",语义干净,查询条件也好写。Prisma 里对应:
model Project {
  id        String    @id @default(cuid())
  title     String
  deletedAt DateTime? @map("deleted_at") // null = 正常,非 null = 已删除
  tasks     Task[]
}
决策 2:唯一键冲突——软删除最经典的坑
这是软删除做错比不做更糟的头号案例:用户注销账号,行还在(deleted_at 非空),他换个心情想用同一个邮箱重新注册——UNIQUE(email) 直接把他拦在门外,或者更糟,注册流程 500。AI 生成的 schema 几乎一定会踩这个坑,因为它只会写 @unique。
解法是 partial unique index(部分唯一索引):唯一性只对"活着"的行生效。
-- 只对未删除的行强制邮箱唯一
CREATE UNIQUE INDEX uniq_users_email_active
  ON users (email) WHERE deleted_at IS NULL;
注意 Prisma 的 @@unique 生成的是全表唯一索引,做不到 partial——这段必须写进 raw migration。以及别忘了配套策略:恢复时如果唯一键已被新人占用怎么办?提前定好二选一:A. 恢复时自动改名/加后缀并告知用户;B. 拒绝恢复并提示冲突,由用户手动处理。没有"到时候再说",到时候就是线上事故。
决策 3:级联软删除,别让子表变成孤儿
删一个项目,它的任务、文件、评论怎么办?硬删除时代答案是 ON DELETE CASCADE——数据库替你全扬了。软删除时代这行不通了:外键 CASCADE 只懂物理删除。级联软删除必须在应用层做:删父级时,在一个事务里把子表的 deleted_at 一起打上。
策略要按表定,两种模式对照:
| 模式 | 行为 | 适用 |
|---|---|---|
| 跟随删除 | 父删子全进回收站,恢复时一起回来 | 任务、附件、项目内的文档——离开父级就没有意义的数据 |
| 保留独立 | 父删了子还在,只是断掉关联展示 | 订单明细、评论、操作日志——有独立审计/业务价值的数据 |
恢复时的顺序是删除的逆序:先恢复子,再恢复父,中间任何一步的唯一键冲突都按决策 2 的策略处理。把"哪些表跟删、哪些保留"写成文档,这是上线 checklist 的第 3 项,别只记在脑子里。
三、查询层防线:默认过滤已删除,别靠记性
模型建好了,真正的战场在查询层。软删除的铁律是:业务查询默认看不到已删除的数据,这条必须做成机制,不能靠每个开发者(或每段 AI 生成的代码)记得加 where deletedAt: null。两种主流实现二选一:
方案 A:Prisma middleware 全局拦截
// 所有 findXxx / count / aggregate 自动追加 deletedAt: null
prisma.$use(async (params, next) => {
  const softDeleteModels = ['Project', 'Task', 'Document'];
  const readOps = ['findFirst', 'findMany', 'findUnique', 'count', 'aggregate'];
  if (softDeleteModels.includes(params.model) && readOps.includes(params.action)) {
    params.args = params.args || {};
    params.args.where = { ...(params.args.where || {}), deletedAt: null };
  }
  return next(params);
});
方案 B:SQL view 隔离(报表/只读场景)
CREATE VIEW active_projects AS
  SELECT * FROM projects WHERE deleted_at IS NULL;
-- 报表、BI、只读账号只给 view 的权限,物理表不对人开放
选哪个看你的栈:Prisma 全家桶就用 middleware,一处拦截、全员生效;有直连库的报表需求就加 view。关键是二选一必须落地一个,不能"我记得加 where"。
AI 生成代码最容易漏 filter 的 3 个检查点
就算 middleware 配好了,AI 生成的代码仍有三个绕过/漏网位置,做 code review 时逐条过:
检查点 1:原生 SQL($queryRaw)直接绕过 middleware。Prisma 的 $use 只拦截 ORM 方法,$queryRaw`SELECT * FROM projects` 走的是另一条路。凡是 raw SQL,必须手写 WHERE deleted_at IS NULL。让 AI 写 raw 查询时,在 prompt 里就把这条写死。
检查点 2:聚合统计(count / sum / 排行榜)。"就一个数字"最容易被忽略:首页显示"已有 12,000 个项目",把回收站里的 3,000 个也算进去了;收入统计把已删除订单的金额加了回去。聚合查询逐个 grep count(、sum(,确认过滤条件。
检查点 3:include / join 带出来的关联表。主表 Project 被 middleware 过滤了,但 include: { tasks: true } 捞出来的任务可能是已删除的——middleware 对嵌套 include 的行为要实测确认,不确定的就在 include 里显式加 where: { deletedAt: null }。
再加一个第 0 检查点:定时任务、seed 脚本、管理后台直连库——这些"看不见"的查询入口往往最早写、最少被 review,也是已删除数据泄露的高发区。最后,写一条集成测试把它钉死:删一条数据 → 跑一遍核心业务查询 → 断言它不可见。这条测试是软删除的"安全带"。
四、回收站产品设计:给用户一颗后悔药
把前三节串起来,从"用户点删除"到"数据恢复"的完整链路如图 2。注意图中两个标星节点——唯一键冲突处理和级联打标/恢复,正是第二节的两个决策在流程里的落点;如果流程图里找不到它们的位置,说明实现漏了。
" alt="删除恢复全链路流程图:用户删除→软删标记→回收站→恢复或保留期到期后定时清理真删,标注唯一键与级联处理节点">图 2:"用户点删除"到"数据恢复"全链路。软删标记释放唯一键(partial index 生效)、级联子表同步打标后数据进入回收站;恢复分支要过唯一键冲突检查并级联恢复子表;无人恢复则由定时任务在保留期到期后物理删除。
保留期分级:别一刀切 30 天
"保留 30 天"是最常见的偷懒答案。更合理的是按数据类型分级,分级依据就三个:恢复价值 × 存储成本 × 合规上限。
| 数据类型 | 建议保留期 | 理由 |
|---|---|---|
| 用户创作内容(文档、项目、笔记) | 30 天 | 误删高发区,恢复价值最高;30 天足够覆盖"我发现删错了"的周期 |
| 订单 / 交易记录 | 90 天 | 对账、退款纠纷需要;注意财务合规可能要求更久,见第五节 |
| 聊天记录、临时内容 | 7 天 | 恢复价值低,量大,留久了就是存储税 |
| 账号注销 | 走合规通道,不进回收站 | 注销即行使删除权,见第五节 |
恢复流程:三种粒度
单条恢复:回收站列表里的"恢复"按钮,一键清除 deleted_at。最常用的路径,必须一次点击完成,别让用户填表单。批量恢复:"误删了一整个文件夹"时用,多选 + 一次事务恢复,中间某条冲突不影响其他条,恢复完给汇总报告(成功 N 条、冲突 M 条)。关联恢复:恢复项目时,它的任务和附件默认一起回来;但如果某个子项在父级删除后被单独彻底删除了,恢复报告里要明确标出来——别静默丢东西。
到期清理:定时任务的四个要求
保留期到了,数据要真删,这个动作交给每天凌晨跑的定时任务:DELETE FROM projects WHERE deleted_at < now() - interval '30 days',按数据类型用各自的保留期。四个要求:幂等——按主键分批删,跑重了也不怕;可观测——每次删了多少行打日志,失败必须告警,一个悄悄停掉的清理任务会让回收站无限膨胀;归档选项——真删前把行快照一份到冷存储(S3 一行 JSON),成本忽略不计,关键时刻能救命;别在业务高峰跑——凌晨 4 点这种没人用的时间,独立开发者的服务器经不起锁表惊魂。
产品面细节
回收站入口放在设置或侧边栏底部,别藏太深也别太显眼;每条记录显示倒计时——"23 天后彻底删除"比"删除于 10 月 1 日"更能驱动用户行动;给不给"立即彻底删除"按钮?给,但要点两次确认。用户主动要求立即真删是他的权利(也是合规加分项),别替他做主。
五、合规交叉:软删除不等于法定删除
这一节是给有欧洲用户或国内用户的独立开发者看的,不符合的可以跳过,但先确认自己真的不符合。
GDPR 第 17 条(被遗忘权)和《个人信息保护法》第 47 条都给了用户删除权:用户要求删,法律要的是真删——数据物理消失,不是打个标记藏起来。软删除在这里不算数,这是必须钉死的认知。
reconciling 的方法("对账"思路):收到删除请求 → 先软删(用户体验:页面上立刻"没了")→ 法定期限内执行真删(合规:GDPR 要求一个月内响应)。三条硬性约束:第一,回收站保留期上限不得超过法定响应期限——别出现"用户行使删除权,数据还在回收站躺 90 天"的笑话;第二,真删要留审计记录:删了什么、何时删的、依据哪条用户请求——注意审计记录本身别再存个人数据,否则删了个寂寞;第三,备份里的副本不需要把每个备份翻出来抠掉,行业实践是随备份轮转自然过期(监管机构也认可技术上不可行时的轮转方案),但这条要写进你的 DSR 流程文档。
具体的 DSR 接单流程——身份核验、响应时限、跨系统(数据库/备份/第三方服务)删除清单——站内《数据主体请求(DSR)处理指南》有完整 SOP,本篇不复述。那篇讲"收到请求后怎么做",本篇讲"删除语义怎么设计才接得住请求"。
六、上线 checklist:8 项,逐项打勾
- 所有业务表都有 deleted_at,默认查询全部过滤。Prisma middleware 或 SQL view 二选一必须落地,staging 用一条"已删除数据不可见"的集成测试钉死。
- partial unique index 已建。在 staging 跑"删 A → 建同名 B → 恢复 A"的回归,确认不 500、不静默覆盖。
- 级联策略文档化。哪些表跟删、哪些保留、恢复顺序是什么,写成文档,别只记在脑子里。
- 回收站 UI 全链路可点。列表、倒计时展示、单条恢复、批量恢复、彻底删除按钮,从用户视角走一遍。
- 端到端演练:删了再恢复。造一条带关联、带附件、带计数器的真实数据,删 → 恢复 → 逐项校验完整性。这是上线前最重要的一次点击。
- 清理定时任务跑通过一轮。在 staging 把保留期调成 1 分钟,看它删、看它记日志、看它告警。生产环境配失败告警。
- 法定删除通道与软删除区分清楚。DSR/注销请求走真删路径,有审计记录;普通删除走回收站。两条路在代码里要是 if/else 分得开的,不能靠注释区分。
- 备份轮转策略写进 DSR 文档。备份里的数据副本随轮转过期,这条写清楚,监管问起来有据可查(与备份指南呼应)。
最后说句实在的:回收站是那种"用户永远不会为它付费,但一次'帮我找回误删数据'的工单就能让你觉得这 2 天没白干"的功能。删除语义是写给未来的自己的保险——希望你永远用不上,但真用上的那天,你会庆幸它不是一条单行道。
评论 (0)
相关文章
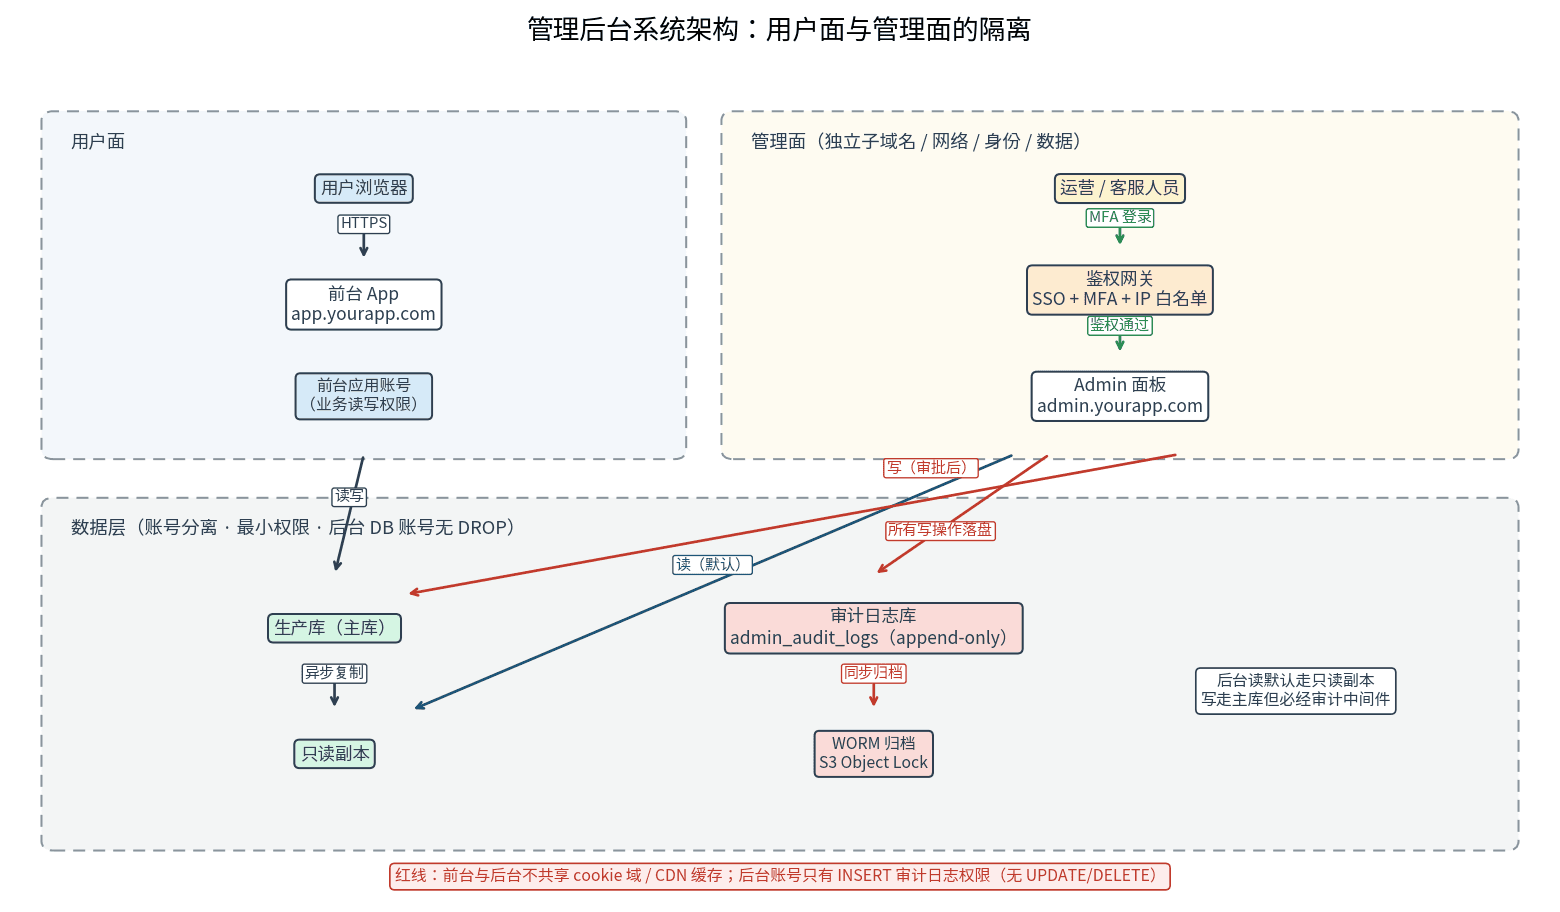
没有后台的上线项目,第一次运维请求就会把你逼回 ssh 手敲 SQL。这篇指南从“上线第 1 天”的功能 MVP 清单讲起:用户/订单/内容/配置四类实体的后台功能矩阵,super_admin/operator/support 三档权限与三层隔离,高危动作的人审二次确认,追加写不可篡改的审计日志,impersonate 的限时 token 安全链路,以及 Retool/自建低代码选型对照和 8 项上线 checklist。
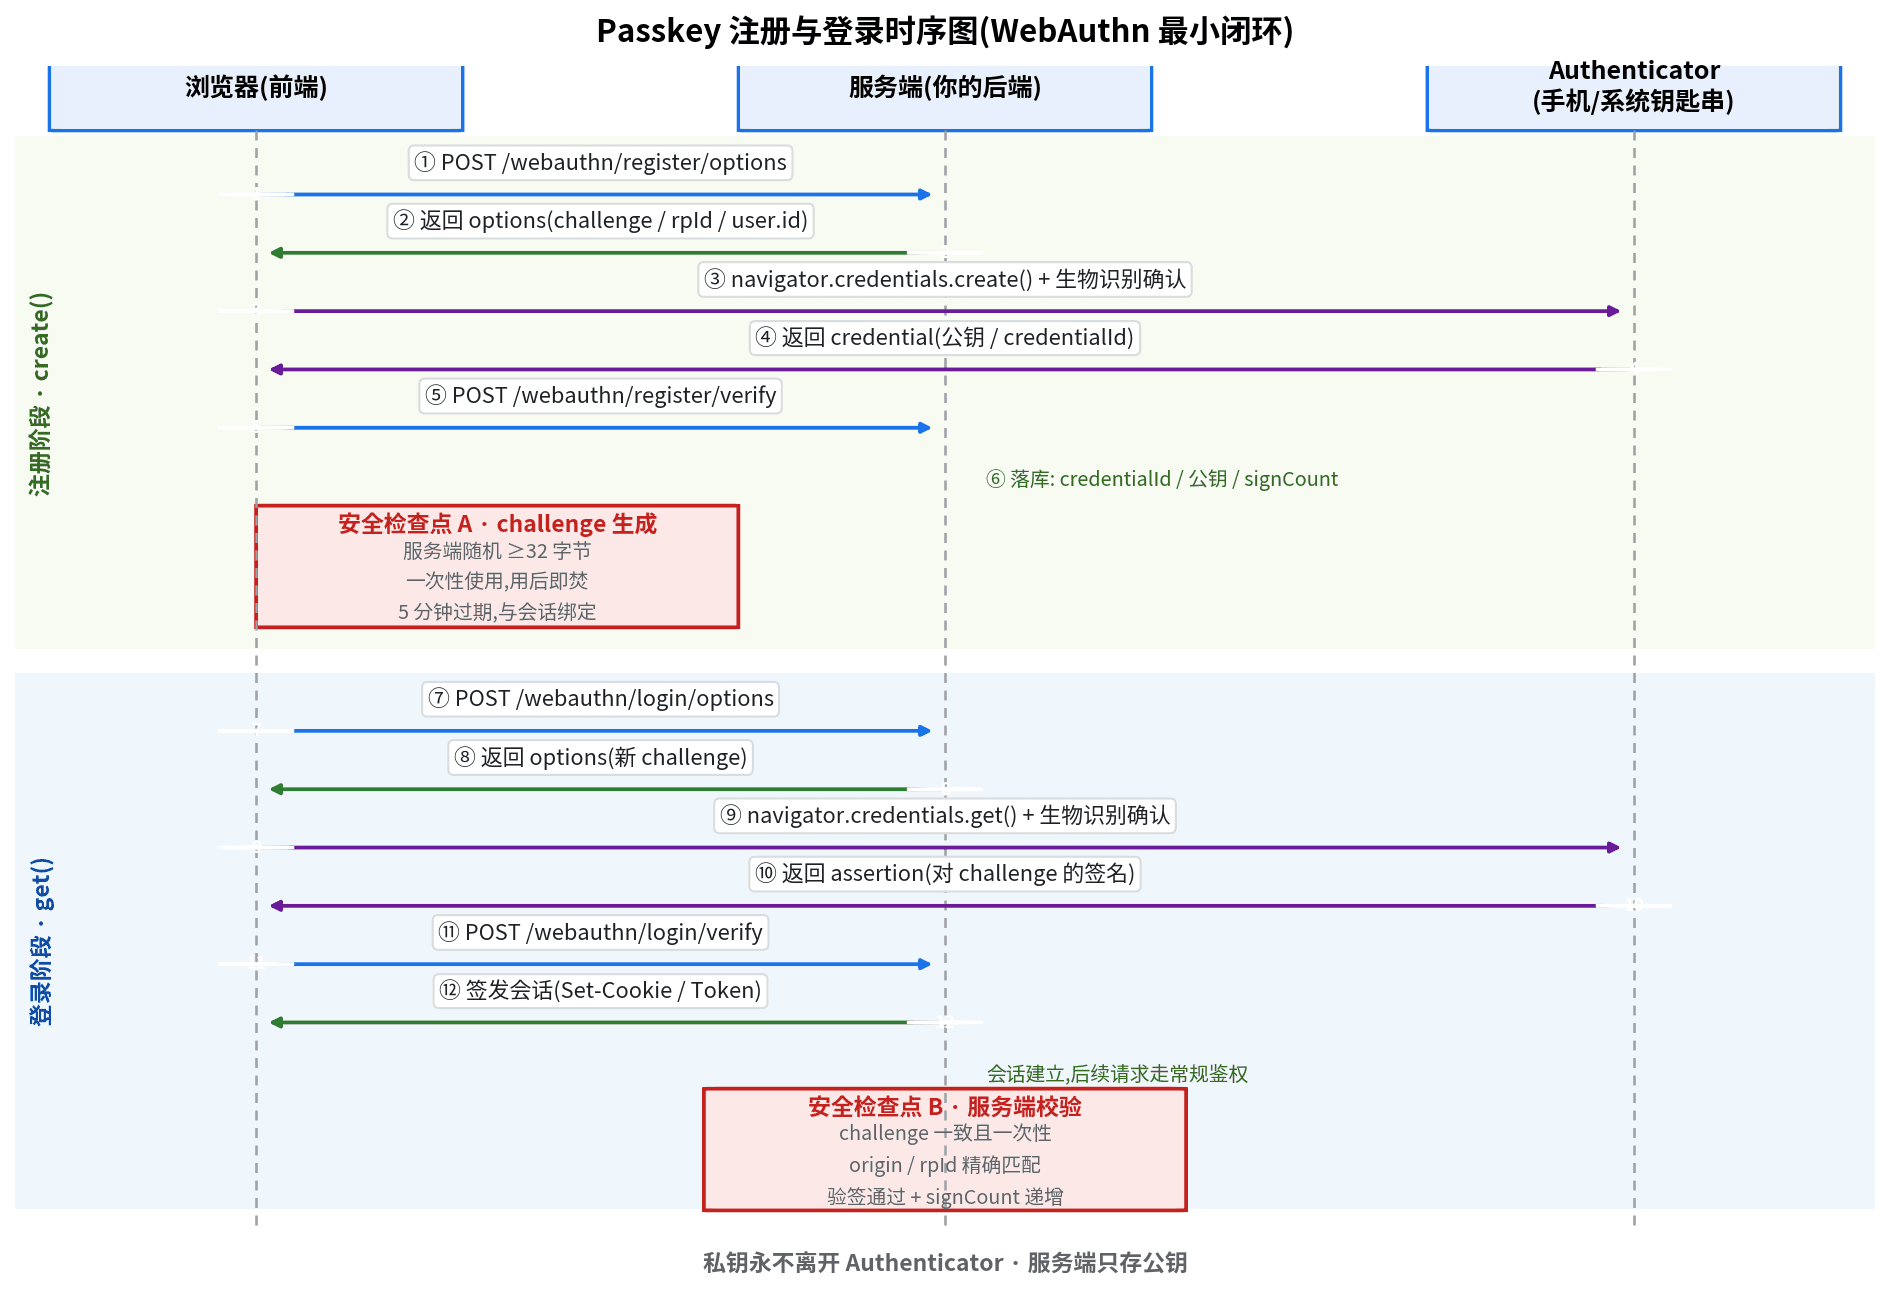
短信验证码按条烧钱、还防不住劫持。Passkey(WebAuthn)用设备端私钥签名替代短信:7 步跑通最小闭环,5 条安全红线一次讲透,外加多设备管理、丢失恢复链路与 8 项上线 checklist——把登录成本和整类攻击一起归零。
console.log 里躺着用户邮箱和登录 token?这篇指南给你一人团队一天能落地的日志脱敏全方案:PII 四级分级表、可直接复制的 TypeScript 脱敏三件套、console.log 到 pino 的最小迁移、请求日志中间件模板、Sentry beforeSend 配置、分级保留策略与成本账,外加 8 个真实踩坑。