Schema 变更别裸奔:vibe 项目数据库迁移的 5 条军规
在 vibe coding 里,数据库是翻车重灾区:Agent 改 schema 比改代码更不可逆,一条 DDL 下去数据可能就没了。这 5 条军规是血泪换来的——从 migration 流程、回滚演练到 expand-contract,每条都给具体做法和反例。
为什么数据库是 vibe coding 的翻车重灾区
用 AI 写代码,最大的幻觉是"错了可以改"。代码错了,git revert 就能回来;但数据库不一样——一条 DROP COLUMN 执行下去,数据就没了,没有回收站,没有 Ctrl+Z。更要命的是,Agent 特别爱直接连库改表:你让它"给用户表加个字段",它可能直接连上生产库执行 DDL,中间连个确认都不带。代码改错了是 bug,schema 改错了是事故。下面这 5 条军规,每一条背后都有人真实地丢过数据。
军规一:从第一天就用 migration,别手改生产库
为什么:migration 是数据库的版本控制。没有它,你的 schema 变更散落在聊天记录、Agent 的某次执行、某人某次手敲的 SQL 里——三个月后没人知道生产库为什么长成这样。有了 migration,每一次变更都是一份带时间戳的文件,可追溯、可重放、可审计。
怎么做:项目初始化那天就把 migration 流程搭好。用 Prisma 就 npx prisma migrate dev --name init 起手;用 Drizzle 就配好 drizzle-kit generate;Supabase 用户直接用它的 migration 目录。立一条铁律写进项目的 AGENTS.md:"任何 schema 变更必须走 migration 文件,禁止直连生产库执行 DDL。"Agent 会读这个文件,这是约束它最有效的方式。
反例:某独立开发者让 Agent"顺手把生产库的索引加上",Agent 连库执行成功,索引是加上了,但同一周他又让另一个 Agent 会话做同样的事,两个会话互相不知道,生产库被加上了重复索引,写入性能直接掉了一半。事后连是谁、什么时候加的都查不到——因为根本没有 migration 记录。
军规二:让 Agent 生成 migration 文件,而不是直接执行 DDL
为什么:SQL 落盘进版本控制,意味着变更要经过人的眼睛。Agent 生成 SQL 的能力很强,但它对"这张表在生产环境有 200 万行,加个非空字段要锁表多久"毫无概念。人审 migration 文件,就是在执行前最后一次踩刹车。
怎么做:给 Agent 的指令应该是"生成 migration 文件并解释每一步的影响",而不是"把表改了"。文件生成后,你至少要看三件事:有没有 DROP / TRUNCATE 这类破坏性语句;大表加字段/加索引有没有考虑锁表(Postgres 里加索引记得 CONCURRENTLY);默认值和非空约束会不会让已有数据写入失败。确认无误再执行,执行命令也别让 Agent 代劳——prisma migrate deploy 这种 production 命令,自己敲。
反例:有人让 Agent"清理一下无用字段",Agent 生成了 ALTER TABLE orders DROP COLUMN note 并直接执行。结果那个字段里存着客服手动补的备注,丢了就是丢了。事后复盘:如果 SQL 先落盘,人眼扫一眼就会发现 DROP COLUMN,悲剧根本不会发生。
军规三:每个 migration 必须可回滚,up/down 成对写
为什么:migration 的本质是"可逆的变更"。只写 up 不写 down,等于只买了单程票。上线后发现新字段导致查询变慢、或者数据迁移脚本有 bug,没有 down 迁移,你就只能手写 SQL 救火——而救火时手写的 SQL,正是军规一要消灭的东西。
怎么做:每个 migration 文件都配好回滚逻辑。Prisma 用户注意:prisma migrate 原生 down 迁移支持有限,做法是保留每次 migration 的逆向 SQL(建表对应删表、加字段对应删字段),存在 migrations/xxx/down.sql 里,形成团队约定。更重要的是把回滚演练纳入上线清单:在 staging 环境先 up 再 down,确认 down 真的能跑、数据真的能回来,再上生产。没演练过的回滚,等于没有回滚。
反例:某团队上线了一个把 status 从字符串改成枚举的 migration,上线 20 分钟后发现旧版客户端还在写旧的字符串值,大量写入报错。down 迁移?没写。最后花了 3 小时手写逆向 SQL,期间服务半残。如果 up/down 成对,回滚就是一条命令的事。
军规四:先在分支库 / 影子库跑一遍,跑通再上生产
为什么:migration 在空表上跑通,不等于在生产数据上跑通。数据量、脏数据、历史遗留的空值,都会让"理论上没问题"的 SQL 翻车。分支数据库就是干这个的:给你一个和生产结构一致、数据接近的环境,先炸它,别炸生产。
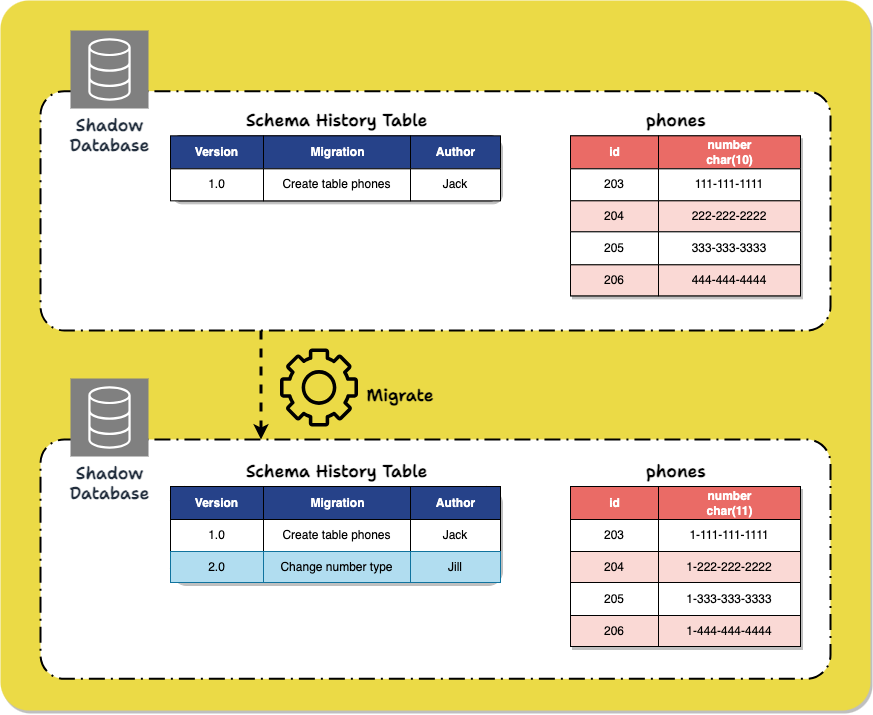
怎么做:Supabase 和 Neon 都支持一键开分支数据库(branch),流程是:从生产拉一个分支 → 在分支上跑 migration → 跑一遍核心查询确认没慢、没报错 → 合并/在生产执行。Prisma 用户可以用 prisma migrate diff 先看 SQL,再用影子库(shadow database)验证。把这一步写进发布流程:"migration 未在分支库验证通过,不得上生产"。
反例:开发者在本地空库测试通过的 migration,上生产跑到一半卡住——生产表里有几十万行历史数据,加非空约束时发现有 NULL 值,migration 中断,表被锁了 4 分钟。如果先在分支库(带生产数据快照)跑一遍,NULL 值问题 5 分钟就能发现。
军规五:数据迁移和代码部署解耦,用 expand-contract 三步走
为什么:最危险的变更,是"改表结构"和"改读写代码"在同一次部署里发生。新代码读新字段,但旧代码还在跑;或者反过来,表先改了,代码还没上,中间任何一步失败都是线上事故。expand-contract 把一次危险的变更拆成三次安全的变更,任何时候都能回退。
怎么做(以"把 name 字段拆成 first_name / last_name"为例):
- Expand(扩张):只加新字段,不删旧的。
ALTER TABLE users ADD COLUMN first_name TEXT, ADD COLUMN last_name TEXT;部署代码开始双写:新旧字段同时写。 - Migrate(迁移数据):写一次性脚本把旧字段数据拆分回填到新字段,跑完校验行数一致。
- Contract(收缩):确认所有读流量都走新字段后,再发一个 migration 删掉旧字段
DROP COLUMN name,代码里删掉双写逻辑。
三步分三次发布,每一步单独可回滚。记住顺序:加字段和删字段永远不在同一个 migration 里。
反例:有人一次 migration 里既加新字段又删旧字段,部署到一半发现新代码有个 bug 要回滚——代码回滚了,但表结构回不去,旧代码读不到已删除的字段,全站报错。expand-contract 下,回滚代码就行,表结构还兼容旧代码。
两条附加铁律
迁移前先备份,pg_dump 是一行命令的事。pg_dump -h <host> -U <user> -d <db> -F c -f backup_$(date +%F).dump,Supabase 控制台也有 point-in-time recovery。备份不是"以防万一",它是 migration 的前置步骤,没备份就别跑 migration。
小步快走,一个 migration 只做一件事。加字段、建索引、回填数据——拆成三个 migration 文件。单个 migration 越小,出问题时定位越快、回滚越干净。让 Agent"一次性把表结构改好"是最常见的翻车姿势,拆小才是正解。
上线前检查清单
- 所有 schema 变更都有 migration 文件,无直连生产库的手动 DDL
- 逐行读过 migration SQL,无
DROP/TRUNCATE等破坏性语句(或已确认备份) - 每个 migration 都有对应的 down 回滚 SQL,并在 staging 演练过
- 已在分支库/影子库(带真实数据量级)跑通 migration
- 加字段和删字段不在同一次发布;需要时用了 expand-contract 三步走
- 迁移前已备份(pg_dump 或 PITR),备份文件可恢复已验证
- production 的 migrate 命令由人执行,不交给 Agent
相关文章

10 月 3 日,工程师 Kevin Liao 发表檄文冲上 HN 前页:记忆插件是一场 RAG 片段抽奖,Agent 需要的是文档工作区。本文拆解他的诊断、开源的 Operator Memory 插件、两个最强的反方质疑,以及今晚就能开始的最小实践。

2026 年 10 月 7 日,Google Developers 发布 Developer Knowledge API 生态:Google Cloud、Firebase、Android 等官方文档变成程序化事实来源,配 gcloud CLI 入口、官方 Agent Skill(一行安装)、MCP server 和多语言客户端库。为什么「文档 API 化」能连根拔掉 vibe coding「模型记错 API」的经典翻车。
每个 vibe 项目迟早需要定时任务:每日数据同步、过期订单清理、账单对账、定时报告。AI 给你的第一个版本通常是 setInterval——开发够用,生产必死。这篇实战给出四种跑法的选型地图(应用内/Vercel Cron/GitHub Actions/Cloudflare),cron 表达式速查与时区坑,幂等性、防重叠分布式锁、失败重试与告警、可观测性 run log,以及 cron 接口的鉴权,最后附上线清单。