别让 AI 的假数据骗了你:vibe 项目的测试数据与种子库实战
AI 写的种子脚本总在第三天爆炸:外键悬空、时间塌缩、唯一索引撞车。这篇指南给出三套 profile 分治、确定性种子、工厂模式与 CI 集成的完整做法,让 pnpm db:seed 成为可靠的基础设施。
为什么 AI 写的种子脚本总在第三天爆炸
几乎每个 vibe 开发者都经历过这个循环:让 AI"顺手造点测试数据",第一天跑得很顺,第二天加了个新表开始报错,第三天整个种子脚本彻底跑不起来,你对着三百行 AI 生成的 INSERT 发呆,不知道哪一行先动的手。
AI 生成的种子数据有三种典型病,病病致命。第一种叫外键悬空:AI 先插了 200 条订单,再想起来用户表还没插,结果 userId 指向的全是空气。更气人的是它第一次运行碰巧成功了——因为那次你手动先建了两个用户,AI 把"环境里碰巧有数据"当成了"我的脚本没问题"。第二种叫时间戳塌缩:所有数据的 createdAt 都是同一天同一分钟,你打开后台的营收图表,看到的是一条笔直的横线,根本看不出趋势对不对。第三种最隐蔽:唯一索引撞车。AI 特别爱用 test1@test.com、test2@test.com 这种"聪明"的邮箱,前 100 条没事,第 101 条撞上唯一索引,整个事务回滚,而你花了半小时才定位到是邮箱的问题。
病根不在 AI 笨,而在于你给它的指令只有一句话:"造点测试数据"。种子数据不是一次性脚本,它是开发基础设施。基础设施就要按基础设施的标准来建:可重复、可版本化、有验收标准。这篇指南就讲怎么把 pnpm db:seed 从"碰运气"变成"每次都一样"。
我见过最惨的一次翻车:有人演示前夜让 AI"多加点数据显得热闹",AI 往订单表里灌了 5 万条,却忘了用户表只有 30 个人。第二天演示,打开"用户排行榜",第一名"test1"的订单数是第二名的 4000 倍,全场安静了三秒钟。问题从来不是数据量不够大,而是数据之间没有"关系"。种子数据的灵魂是关系——用户和订单的关系、时间和事件的关系。有关系的 200 条数据,比没关系的 5 万条有用得多。
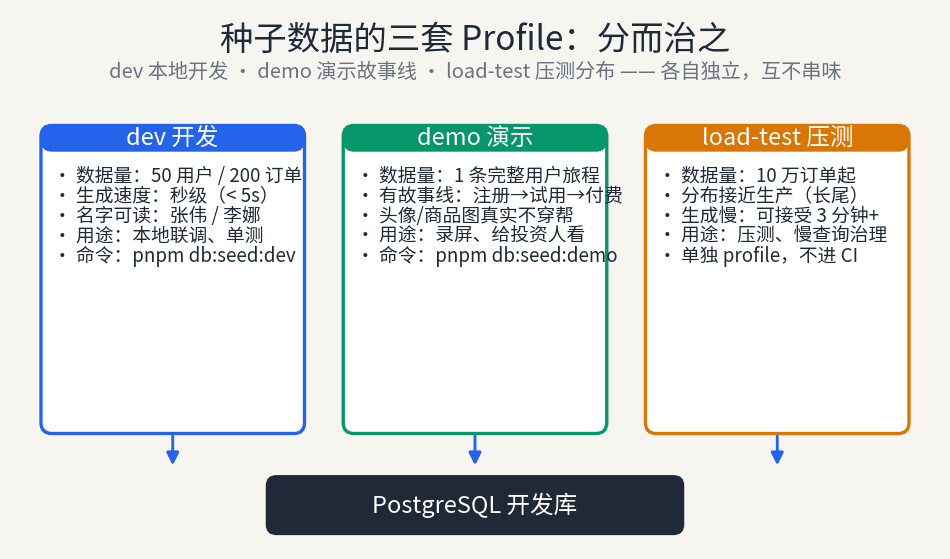
三类种子数据,分而治之
先立一个规矩:一套种子打天下,是万恶之源。本地开发要的、演示要的、压测要的,是三种完全不同的数据,硬塞进一个脚本,最后谁都用不爽。
dev:给本地开发用的。要求只有一个:快。50 个用户、200 条订单,pnpm db:seed:dev 必须在 5 秒内跑完。名字要可读——"张伟""李娜"而不是"user_8f3a",因为你每天要在后台、日志、调试器里看这些名字几十次,可读的名字能让你一眼看出数据流对不对。dev 数据不需要好看,需要"一眼能定位"。
demo:给演示用的。这是门面。数据量不大,但必须有故事线:同一个用户从注册、试用到付费的完整痕迹,头像和商品图不能是裂开的占位图。录屏前跑一遍 pnpm db:seed:demo,保证你演示时不会出现"test123"这种让投资人皱眉的东西。demo 数据值得花心思,因为它直接决定别人对你产品的第一印象。
load-test:给压测用的。10 万订单起步,分布要接近生产——真实世界的订单量是长尾分布,不是均匀分布。生成慢可以接受,3 分钟以上也没关系,因为它不进日常 CI,是单独跑的。这是三种 profile 里最容易被忽视的,也是上线后第一个暴露问题的:你在 dev 的 200 条数据上测得好好的慢查询,上线遇到 10 万条直接把数据库打挂。
三套 profile 各自独立:独立的脚本、独立的命令、独立的运行节奏。dev 每天跑几十次,demo 一周跑几次,load-test 一个月跑一次。混在一起的那天,就是你的种子脚本开始腐烂的那天。
落地时建议在 package.json 里把命令写死:db:seed:dev、db:seed:demo、db:seed:load,再加一个 db:reset 做一键重置。别用参数区分(比如 db:seed --profile=demo)——参数容易打错,独立命令一目了然。新人入职第一天,README 里写"跑 pnpm db:seed:dev",他 5 秒后就有了一个和你一模一样的开发环境。这种"环境一致性"是种子数据最被低估的价值:你们团队再也不用在群里问"你本地有几条订单数据"了。
确定性种子:让每次 db:seed 结果都一样
种子数据最重要的性质不是"像真的",而是可复现。同样的命令跑两次,数据库里应该出现逐行一致的数据。做不到这一点,你的 bug 复现、CI 测试、结对调试,全都建立在流沙上。
做法很简单:固定随机种子。faker 这类库都支持 faker.seed(42),42 换成你生日也行,关键是"固定"。然后给 AI 下指令时必须明确要求:所有随机必须走可设种子的 RNG,不准用 Math.random() 裸奔。AI 默认会混用两种随机源,这是种子不可复现最常见的技术原因,你得在 prompt 里把它堵死。
光固定种子还不够,要有验收方法。我的做法是:跑两次 db:seed,把数据库 dump 出来逐行 diff,必须零差异才算过关。把这个验收写进你的开发文档,新人(或者三个月后的你)改种子脚本时,跑一遍验收就知道有没有破坏确定性。听起来有点笨,但这是唯一可靠的方法——"我觉得应该是一样的"在种子数据这里一文不值。
给 AI 写种子脚本的 prompt,我建议固定用一个模板,省得每次重新描述需求:"用 faker 生成种子数据,要求:1)所有随机走 faker.seed(固定值),禁用 Math.random();2)先列出表的依赖关系和插入顺序,确认后再写代码;3)用 factory 函数组织,每个模型一个工厂;4)时间字段分布在过去 90 天,不要堆在同一天;5)邮箱用 user_{序号}@example.com 格式,避免撞唯一索引。"把这段存进你的 AI 指令文件,每次让 AI 写种子脚本时引用它。你会发现,加上这五条约束之后,AI 生成的种子脚本一次跑通的概率从"看运气"变成"大概率",而你付出的只是一段复制粘贴。

还有一个细节:时间。AI 生成的 createdAt 要么全是"现在",要么全是同一天。正确做法是让时间也有分布:订单散落在过去 90 天里,有工作日和周末的差异,有大促期间的峰值。你不需要精确模拟现实,只需要"不全挤在一天"。图表能看出趋势,分页能翻到第二页,搜索能搜出不同时间的结果——这三条过了,时间维度就算合格。
外键与关联:先有图,再有数据
种子脚本最大的技术坑是插入顺序。AI 写脚本是按"我想到的顺序"写,不是按"数据库要求的顺序"写。根治方法是:让 AI 先输出 ER 关系与插入顺序,再写脚本。prompt 里加一句"先列出所有表的依赖关系和插入顺序,确认后再写代码",能过滤掉一半的外键问题。这不是玄学——你强迫 AI 先做拓扑排序,它就不会再拍脑袋。
第二个方法是用工厂模式,而不是手写 SQL 堆。给每个模型写一个 factory 函数:createUser() 返回一个合法的用户对象,createOrder(user) 接受一个用户返回它的订单。工厂函数内部处理好默认值和关联,脚本主体就只剩"循环调用工厂"。这样做的好处是:加新字段时只改工厂一处,而不是在 50 个 INSERT 里逐个补。AI 特别擅长写工厂函数——这是它训练数据里最多的模式之一,你要做的只是要求它这么写。
Prisma 用户要特别注意一个坑:createMany 不支持嵌套 connect。AI 经常写出 prisma.order.createMany({ data: ordersWithUserConnect }) 这种一看就很对、但跑起来就报错的代码。正确姿势是先 createMany 插父表,再用查出来的 id 逐个或批量插子表。把这个坑写进你的项目 AI 指令文件(比如 AGENTS.md),一劳永逸。
自引用表是另一个经典翻车点:员工表里有"经理 id"指向自己。AI 的直觉是"先插经理再插员工",但经理自己也是员工。一遍插入搞不定,正确做法是两遍插入:第一遍插所有人、经理字段留空,第二遍再 update 把上下级关系连上。这个模式也适用于分类树、评论盖楼这类自引用结构。记住"两遍插入"这个词,下次让 AI 写种子脚本时直接告诉它用这个模式。
工厂函数长什么样?给你一个最小可用模板,AI 照着这个模式能举一反三:createUser(overrides) 里用 faker 生成姓名邮箱、密码固定填"password123"的哈希(别每次随机哈希,登录测试时你自己都登不进去);createOrder(user, overrides) 接受一个已创建的用户,只负责生成和这个用户关联的订单。注意一个细节:工厂函数默认生成的应该是"合法且普通"的数据,极端情况(超长昵称、负金额)单独写 createEdgeCaseUser() 这种命名明确的变体。混在一起的结果就是:你想测普通流程时,数据库里全是极端数据,分页第一页就把你吓一跳。
从生产库取样:脱敏是前置条件,不是可选项
有些数据用 faker 怎么造都不像:真实用户的行为序列、真实商品的长尾分布。这时候可以从生产库取样,但生产数据绝不能直接当种子——这不是"最好别",这是红线。你的开发机、CI 日志、录屏,都有可能把种子数据暴露出去。
取样的标准流程是三步:取样、脱敏、验证。取样时只取需要的列,不要 SELECT *;脱敏时邮箱、手机、姓名做假名化替换(保持格式和唯一性,比如把真实邮箱映射成 user_xxxx@example.com,而不是简单打码——打码后的数据在唯一索引和外键上会出各种幺蛾子);金额、年龄这类数值做区间抖动(上下浮动 10%,保持分布形状)。验证时跑一条硬规则:种子库里 SELECT 出任何能定位到真人的字段,这次取样就作废重来。
脱敏的分级思路可以参考本站已发布的《日志脱敏与 PII 治理》指南,那里讲了 PII 分级的完整框架,这里不重复。记住一句话就行:种子库里的每一条数据,都要经得起"不小心公开"的考验。如果某条数据公开了会让你睡不着,它就不该出现在种子库里。
多说一句假名化的方法:建一张映射表,真名→假名一一对应,同一真名每次映射到同一假名。这样做的好处是关联关系不丢——"张伟下的 5 个订单"脱敏后变成"陈静下的 5 个订单",订单归属关系还在,行为分析类的测试照样能做。简单打码("张*伟")会破坏这种关联,而关联恰恰是取样数据最值钱的部分。映射表本身是敏感资产,加密存、定期删,只在取样那几分钟存在。
种子脚本的版本化与 CI 集成
种子脚本和 migration 是连体婴:表结构变了,种子脚本必须跟着变。做法是把种子脚本放进 prisma/seeds/(或你 ORM 对应的目录),按编号管理,和 migration 一一对应。PR 里改了 schema 没改种子,CI 应该直接变红——这不是苛刻,这是让机器替你记住"连体婴"关系。
CI 流水线的固定顺序是:migrate → seed → test。这个顺序不能乱:先建表,再灌数据,再跑测试。测试依赖种子数据是天经地义的,但依赖关系必须是显式的——测试文件里不准自己插数据,所有前置数据都从种子来。这样你的测试挂了,第一反应是"种子是不是坏了",而不是在测试文件里大海捞针。
还有一条经验线:种子脚本超过 3 分钟,就要拆出 load-test profile。CI 每天跑几十次,每次多 3 分钟,一年下来就是几十个小时的等待。dev profile 必须保持秒级,这是硬指标。load-test 的慢是允许的,因为它一个月才跑一次——把"慢"隔离出去,别让它污染日常开发节奏。
GitHub Actions 里这套流水线大概长这样:一个 job 里依次跑 prisma migrate deploy、pnpm db:seed:dev、pnpm test,任何一步非零退出就标红。关键是把"种子变红"和"测试变红"区分开看:种子挂了,说明 schema 和种子脱节,先修种子;测试挂了,才是业务逻辑问题。混在一起看,你会浪费大量时间在错误的方向上。另外给 CI 的种子加一个超时保护:dev profile 超过 60 秒直接失败——这能第一时间抓住"有人把 load-test 的数据量写进 dev 脚本"这类事故。
演示环境的数据故事线
demo 数据和 dev 数据最大的区别,是 demo 数据要"演"。投资人、用户、评委看的不是数据,是故事。一个好的 demo 数据集,应该能讲出这样一个故事:用户"林小雨"三周前注册,第一周只看了看,第二周开始试用,昨天刚付了年费。她的仪表盘里有真实的曲线,她的订单列表翻得到第二页,她的设置页填得满满当当。
编故事线有个笨但有效的办法:先写剧本,再造数据。把你要演示的 5 分钟流程写成逐字稿——"我点开仪表盘,你们看这条曲线…",然后反推每个界面需要什么数据,再让 AI 按剧本造。反过来做的(先造一堆数据,再想怎么演示)永远讲不出流畅的故事,因为数据里没有"意图"。
录屏和截图前,固定做三件事:跑一遍 db:seed:demo、把系统时间调到"故事时间"(别让"3 年前注册"的用户显示"2 分钟前活跃")、检查一遍有没有"test""aaa"这种穿帮字符串。这三件事加起来 2 分钟,能避免 90% 的演示翻车。演示翻车和代码 bug 不一样:bug 可以修,投资人皱的那一下眉,修不回来。
检查清单:种子库健康度 9 项自查
最后是一张自查表。每个月花 10 分钟过一遍,种子库就不会悄悄腐烂:
1. 确定性:连续跑两次 db:seed,dump diff 零差异。
2. 外键零悬空:所有外键字段都能 join 到存在的父记录,跑一条 SQL 验证。
3. PII 为零:种子库里没有任何真实用户的邮箱、手机、姓名。
4. 三 profile 独立:dev / demo / load-test 各自有独立脚本和命令,互不引用。
5. CI 全绿:migrate → seed → test 顺序固定,schema 变更时种子同步更新。
6. 速度达标:dev profile 5 秒内跑完,超过 3 分钟的已拆出 load-test。
7. 文档写清:README 里有一行命令告诉新人怎么重跑种子,而不是口口相传。
8. demo 有故事线:演示数据能讲出完整的用户旅程,没有"test123"穿帮。
9. 一键重置:有 db:reset 这种一键命令,搞乱了能 10 秒内回到干净状态。
种子数据是 vibe 项目里最被低估的基础设施。AI 帮你写代码的速度越快,烂数据拖你后腿的效应就越明显——因为代码一天能重写,数据里的坏味道会跟着你整个开发周期。花一个下午把种子库建好,它会在之后每一天里,以"不用操心"的方式回报你。
最后说个判断标准:好的种子库是"无感"的。你一年里想起它的次数越少,它越成功。反过来,如果你每个月都要花半天修种子脚本,说明它已经从基础设施退化成了技术债——而技术债的利息,是用你每次调试时多花的 20 分钟来支付的。现在就去给你的项目加一套 dev/demo/load-test 的 profile,未来的你会感谢今天这一下午。
评论 (0)
相关文章
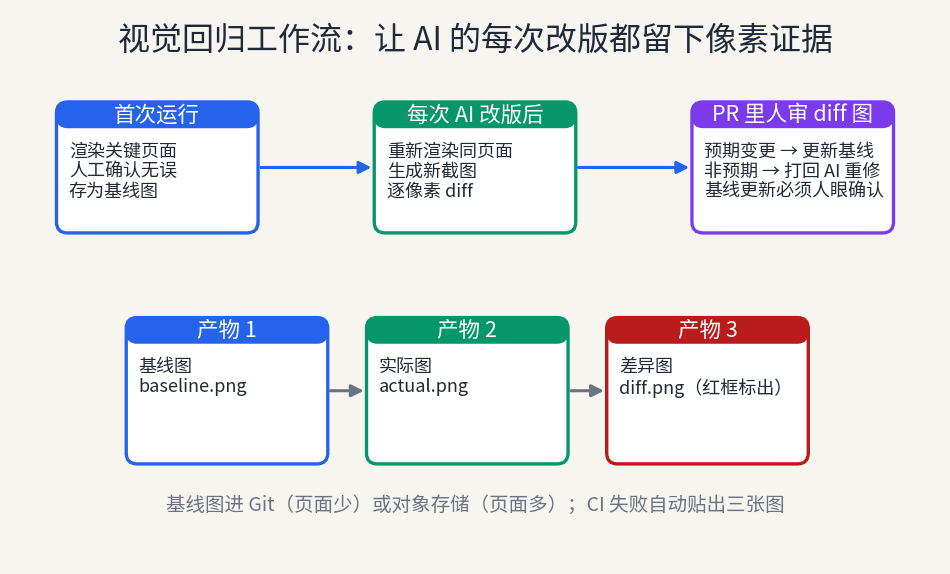
AI 每次重写页面都可能悄悄挪动布局:按钮位移 8px、深色模式白底白字、断点处卡片叠在一起,而 E2E 全绿。这篇指南给出一人团队半天能接好的 Playwright 截图断言方案与误报治理四招。
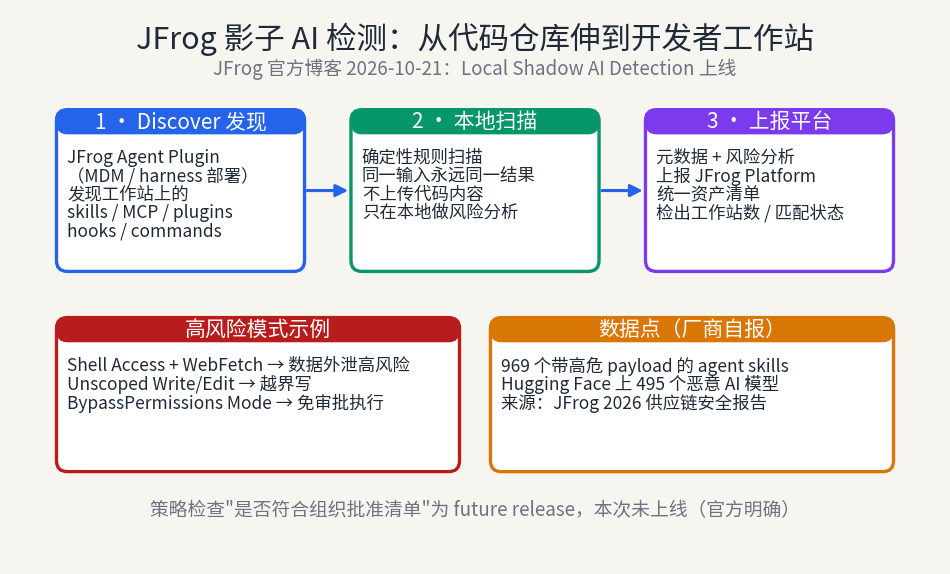
JFrog 把影子 AI 检测从仓库延伸到开发者工作站:Agent Plugin 发现笔记本上的 skills、MCP servers、hooks 等未注册 AI 资产,本地确定性扫描后上报统一清单。但“是否符合批准清单”的策略检查还在 future release——现在看得见,拦不住。个人开发者也该给自己做一份 skill 资产清单。
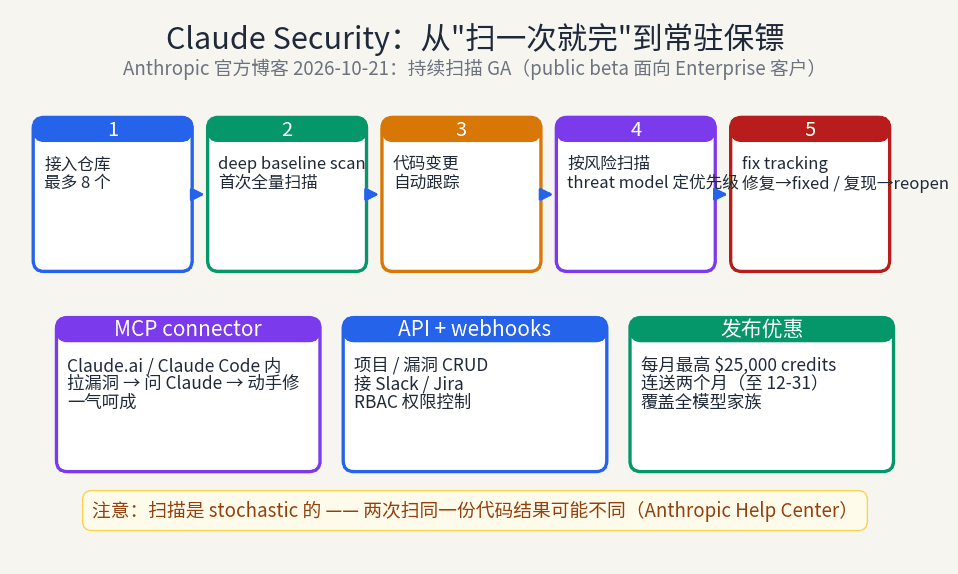
Anthropic 把 Claude Security 从手动触发的单次扫描升级为持续监控:先做深度基线扫描,之后自动跟踪每次代码变更;新增自动 fix tracking、按项目生成的 threat model,以及把漏洞处理搬进 Claude Code 会话的 API 与 MCP connector。对写代码飞快、却没人做安全 review 的 vibe coder 来说,这是缺失已久的"常驻"安全层——但它的非确定性扫描,也给"把扫描结果当门禁"的 CI 流程出了道新难题。