写代码不再是瓶颈,验证代码才是:Blacksmith 凭"CI 云"杀入独角兽
Blacksmith 宣布 6600 万美元 C 轮融资,Sequoia 领投,估值 10 亿美元。每周 CI 任务量 10 个月涨 18 倍——当 AI 接管"写代码","验证代码"成了新的瓶颈与新的独角兽赛道。
一句话:AI 写代码越快,验证代码的机器越值钱
2026 年 10 月 21 日,CI(持续集成)基础设施公司 Blacksmith 宣布完成 6600 万美元 C 轮融资,由 Sequoia(红杉)领投,投后估值 10 亿美元——正式跨入独角兽行列。参投方包括 Premji Invest,以及老股东 Peak XV Partners、GV 和 Y Combinator。算上本轮,Blacksmith 累计融资达到 1.25 亿美元。
这轮融资的节奏本身就说明问题:两个月前它刚完成 4500 万美元 B 轮(估值 5.5 亿美元),一年前 A 轮 1000 万美元时估值才 6000 万美元。12 个月,估值翻了 16 倍多。资本市场在为什么买单?答案是 Blacksmith 的 CEO Aditya Jayaprakash 在官方博客里写的那句话:"Writing code used to be the slow part of shipping software. It isn't anymore."(写代码曾经是交付软件中最慢的一环,现在不是了。)
当 AI 接管了"写","验证"就成了新的瓶颈——而验证,正是 Blacksmith 卖的东西。
Blacksmith 是做什么的:把 CI 当成一朵"云"来卖
CI 是持续集成的缩写:每次代码变更合并前,都要经过构建、测试、合并、校验这一整套自动化检查。对开发者来说,它是流水线上最 boring、也最不可或缺的一环。
Blacksmith 的模式很直接:公司把 CI 工作负载交给它,它在自己运营的算力上跑得比客户自己在通用云上跑更快,而且零运维。官方博客的原话是:"Companies bring us their CI workloads, and we run them faster than they could anywhere else, with zero operational overhead."
客户名单颇具说服力:Mercury、Granola、Handshake、LangChain——全是过去两年跑得最快的软件团队。Blacksmith 称,目前有超过 10000 家公司把"最关键的工作负载"托付给它。
为什么 CI 值得单独做成一朵云?Jayaprakash 给出的理由很实在:CI 是公司运行过的波动(spike)最剧烈的工作负载。单个客户的需求经常在"零"和"几万个 CPU"之间反复横跳。过去三年,Blacksmith 主要就是在修炼吸收这种脉冲式需求的内功——这恰恰是通用云不擅长、也不愿为你单独优化的事。
数字:每周 9000 万个 CI 任务,ARR 一年涨 17 倍
本轮披露的业务数字相当惊人:
- CI 任务量:今年 1 月每周 500 万个,现在每周超过 9000 万个——10 个月增长约 18 倍;
- ARR:增长 17 倍(公司未披露绝对值);
- 算力:目前在美欧数据中心管理着将近 10MW 的算力,计划 2027 年扩大 5 倍。

图:Blacksmith 每周 CI 任务量变化。数据来源:Blacksmith 官方博客《Building the CI cloud: our Series C》(2026-10-21)。
最有信息量的一句话藏在博客里:Anthropic 上个月透露,随着 Claude 接管了它大部分的代码产出,其 CI 任务量在 6 个月内增长了 25 倍。Anthropic 只是走得最远的那一个——Blacksmith 说,在它的客户群里,同样的趋势正在全面铺开,"expect many to reach that point soon"(预计很多客户很快也会到那个量级)。
Jayaprakash 的另一句原话值得逐字记住:"As agents write more of the world's software, the question that matters is whether it can be trusted."(当 agent 写下世界上越来越多的软件,真正重要的问题是:它值得信任吗?)CI,就是回答这个问题的机器。
判断:基础设施的投资逻辑,正在从"写代码"转向"验证代码"
过去三年,AI 编程赛道的钱基本都投向了"写代码"这一端:Copilot、Cursor、Windsurf,以及各家大模型本身。但 Blacksmith 这轮融资标志着一个转折——当代码产出接近免费,稀缺资源就变成了验证代码的能力:算力、测试流水线、沙箱、评审。
这个逻辑和我们在 cycle82 报道的 Daytona("agent 云",6000 万美元 B 轮杀入独角兽)是同一枚硬币的两面:Daytona 解决的是"agent 在哪里干活",Blacksmith 解决的是"agent 干完的活谁来验收"。两家公司在三个月内相继成为独角兽,说明资本市场已经形成了共识:agent 时代的基础设施,赌的是"执行"和"验证",而不是"生成"。
对独立开发者和 vibe coder 来说,这件事有三层现实意义:
第一,CI 排队正在成为小团队的隐形税。你用 Claude Code 一下午生成 40 个 commit,每个 commit 触发一次 GitHub Actions 全量测试——免费的分钟数烧完之后,要么排队等共享 runner,要么掏钱。AI 让"提交"变便宜了,但"验证每次提交"没有变便宜。Blacksmith 这类服务的存在,就是把验证能力零售化。
第二,"快"本身正在变成竞争力。Blacksmith 卖的不只是算力,是"比你自己跑更快"。在 agent 一天能推几十次代码的节奏下,CI 从 20 分钟压缩到 4 分钟,意味着 agent 的试错循环快 5 倍——这直接决定了你一天能迭代多少轮。对小团队,这可能是花小钱买到的最大杠杆之一。
第三,警惕新的成本黑洞。我们在《把 token 烧明白:vibe 项目的 LLM 推理成本工程》里算过模型账;现在要加上 CI 账。Agent 写出的代码量越大,CI 账单涨得越快。建议从第一天就给 CI 设预算告警——否则你会同时收到模型账单和算力账单的"惊喜"。
冷静一下:三个需要打折看的数字
按惯例,给官方口径打三个折:
- ARR 17 倍、任务量 18 倍:基数效应明显。1 月份每周 500 万任务时公司还很小,高增长有基数红利。但即便如此,10 个月做到每周 9000 万次真实 CI 执行,依然是硬核的工程能力证明——CI 可不是刷榜能刷出来的,每次执行都要真实消耗算力。
- "比任何地方都快":厂商自报,未经独立测试。GitHub 官方 runner、Buildkite、Depot、Namespace(后者刚拿了 4200 万美元 B 轮做 coding infra)都在抢同一块蛋糕,性能声明要等第三方实测。
- 10MW 算力:听起来不小,但和超大规模云厂商的体量比仍是九牛一毛。Blacksmith 的赌注是"专用 beat 通用"——CI 这种脉冲负载上,专用调度确实有结构性优势,但护城河有多深,要看 2027 年 5 倍扩容后利用率能不能跟上。
细读 Anthropic 的"25 倍":为什么 agent 让 CI 量超线性增长
Anthropic 披露的"6 个月 CI 任务量涨 25 倍"值得单独拆开看,因为它揭示了一个反直觉的规律:代码产出翻一倍,CI 量翻的不止一倍。
人类开发者的提交节奏是线性的:一天 3-5 个 commit,每个 commit 跑一次 CI。agent 的工作方式完全不同:
- 试错即提交:agent 写代码是"生成→跑测试→失败→修→再跑"的循环,一次需求可能触发几十次 CI 运行,而人类只会把"能跑通"的版本 push 上去;
- 并行 agent 乘数:一个人同时开 5 个 agent 干 5 个任务,CI 并发直接 ×5,还都是脉冲式的——这正是 Blacksmith 说的"从零到几万 CPU 反复横跳";
- 全量测试偏好:agent 不知道"这次改动只影响哪个模块",默认跑全量测试套件。人类会凭经验只跑相关测试,agent 的"谨慎"直接转化为 CI 分钟数。
这就是为什么 Blacksmith 的增长曲线如此陡峭:它吃的不是"开发者数量增长"的红利,而是"每个开发者的 CI 消耗量被 agent 放大一个数量级"的红利。1 月到 10 月每周任务从 500 万到 9000 万,背后是客户群里 agent 渗透率从"尝鲜"到"主力"的切换。
推论:CI 厂商的 TAM(市场规模)计算方式变了。以前按"开发者人数 × 人均 CI 消耗"算,现在要按"开发者人数 × agent 并发数 × 试错循环数"算。Sequoia 敢在 2 个月内连投两轮(B 轮到 C 轮只隔 60 天),赌的就是这个乘数还没到顶。
vibe coder 实操:先算清你的 CI 账
道理讲完,落到行动。如果你也在用 agent 高频提交,这 5 个动作今天就能做:
1. 看一次账单。打开 GitHub 仓库的 Actions 用量页(或你用的 CI 平台),看过去 30 天的分钟数/任务数,再看其中多少来自 agent 的提交。很多人第一次看会被吓到——"原来我的 agent 一个月烧掉了 3000 分钟"。
2. 给 agent 立 CI 规矩。在 AGENTS.md / CLAUDE.md 里加三条:本地先跑相关测试再 push;CI 配置变更必须经你确认;禁止为了"修 CI"而把测试注释掉(agent 干过这事,而且不止一次)。
3. 测试分层。把测试套件拆成"快速冒烟(<2 分钟)"和"全量(慢)"两层:PR 默认只跑冒烟,合并到主分支才跑全量。这一拆,CI 量通常能降 50% 以上。
4. 缓存依赖。agent 生成的项目常常没有依赖缓存配置——每次 CI 全新安装依赖,几分钟就这么没了。配好缓存是投入产出比最高的优化。
5. 评估要不要"租"验证能力。当你的 CI 排队开始拖慢 agent 的迭代循环(比如 agent 等 CI 结果一等 20 分钟),就到了算账的时候:更快的 runner 省下的 agent 等待时间,值不值那点钱。对全职 indie 来说,答案往往是值的——你的时间比 CI 分钟贵得多。
赛道图谱:CI 基础设施的四种玩家
Blacksmith 不是一个人在战斗。CI 基础设施赛道目前有四类玩家,选型时值得一张表看清:
| 类型 | 代表 | 模式 | 适合谁 |
|---|---|---|---|
| 代码托管平台自带 | GitHub Actions hosted runners、GitLab CI | 和代码仓库深度绑定,开箱即用 | 绝大多数小团队;排队和慢是主要痛点 |
| 专用 CI 云 | Blacksmith、Namespace(刚拿 4200 万美元 B 轮)、Depot | 专用算力 + 深度优化,"更快"是核心卖点 | CI 量大、迭代快的团队;agent 重度用户 |
| CI 编排/管理 | Buildkite(自带 agent 混合)、CircleCI | 灵活的 pipeline 编排,混合云部署 | 有合规要求、需要混合部署的中大型团队 |
| 自建 | Jenkins、TeamCity 自运维 | 完全可控 | 有专职 infra 团队的大公司;小团队别碰 |
判断:对 vibe coder,决策树很简单——先用代码托管平台自带的(零成本起步);当排队开始拖慢 agent 迭代循环时,试专用 CI 云的按量档;永远不要自建(你的时间应该花在产品上,不是 Jenkins 插件上)。Blacksmith 们赌的,就是第二步的转化率——而 agent 正在把越来越多的团队推过这条线。
还有一个值得玩味的信号:Namespace 也是今年拿了大额融资(4200 万美元 B 轮)的 coding infra 公司。两家公司在同一年被资本市场加注,说明"CI/编码基础设施"已经从" boring 的 DevOps 花边"变成了独立赛道。Boring 生意最大的特点是:一旦趋势成立,赢家通吃的就是执行力,而不是概念。
投资人视角:Sequoia 到底在买什么
B 轮到 C 轮只隔 60 天,这种节奏在 2026 年的融资环境里极为罕见。Sequoia 不是在"追高",而是在"抢筹码"——它买的不是 Blacksmith 现在的收入(ARR 未披露绝对值,大概率还不大),而是三个判断:
判断一:CI 是 agent 时代的"卖水"生意。淘金热里最赚钱的是卖水卖铲子。Agent 写代码的量越大,验证需求越大,而验证是刚性的——代码不跑测试不能上线,这是工程纪律,不是可选项。Blacksmith 的收入和"AI 写了多少代码"直接挂钩,相当于给整个 agent 浪潮买了一个看涨期权。
判断二:专用基础设施的窗口期。通用云(AWS/GCP/Azure)当然也能跑 CI,但它们的优化目标是"通用",而 CI 的脉冲特性需要专用调度。现在巨头还没认真下场做"CI 云"——GitHub 的 hosted runners 体验多年没大变化,这给了创业公司 2-3 年的窗口。Sequoia 赌的是 Blacksmith 能在窗口关闭前建立起规模壁垒(10MW→50MW 的算力、10000+ 客户的迁移成本)。
判断三:团队的执行力已被验证。每周 9000 万次真实 CI 执行、零重大事故(至少公开记录里没有),这是 infra 公司最难伪造的成绩单。infra 投资里,团队执行力的权重比商业模式还高——因为 infra 的护城河就是"不出事"。
反过来看风险:如果 GitHub 明年把 hosted runners 的性能提 5 倍还降价,Blacksmith 的"更快"卖点会被釜底抽薪。所以接下来 12 个月最值得看的不是 Blacksmith 融了多少钱,而是GitHub 会不会跟进。巨头不动,Blacksmith 就有时间把 10MW 变成 50MW;巨头一动,窗口就开始倒计时。
历史对照:上一次"验证瓶颈"是什么时候
这不是软件史上第一次"生产快于验证"。2010 年前后,敏捷开发让"写代码"变快,瓶颈变成了"手动测试跟不上"——于是 Selenium、Jenkins、CI 概念爆发,造就了一批测试基础设施公司。2020 年前后,微服务让"部署"变快,瓶颈变成了"可观测性"——Datadog、Honeycomb 吃到了红利。
每次的剧本都一样:生产环节的效率革命,会把瓶颈推到下一个环节,而瓶颈环节会诞生新的基础设施独角兽。2026 年的剧本是:AI 让"写代码"变快,瓶颈推到"验证代码"——Blacksmith 和 Daytona 就是这一轮的瓶颈收割者。
按这个剧本推演,下一个瓶颈在哪?可能是"需求验证"(AI 一天生成 10 个产品想法,哪个值得做?)、可能是"运营"(AI 生成的内容谁来审核?)。vibe coder 如果想吃下一波红利,别只盯着"写代码更快"的工具,去看"写代码变快之后,什么变成了新的慢"——答案往往藏在抱怨里,而不是发布会里。
给不同阶段团队的一句话
- 个人 side project:现在就去看一眼 Actions 用量——知道自己的 CI 烧到哪了,比任何优化都重要;
- 有收入的 solo 产品:给 CI 设预算告警(和模型账单告警放一起),agent 时代这是和服务器账单同等重要的成本项;
- 小团队 CTO:评估一次专用 CI 云的试用——如果它能把你的合并等待时间砍掉一半,团队每天多出来的有效迭代次数会让你惊讶;
- 投资人/观察者:盯住"每周 CI 任务量"这个指标,它是 AI 代码渗透率最诚实的代理变量,比任何 survey 都准。
快问快答
Q:Blacksmith 和 GitHub Actions 是什么关系?
A:它是 GitHub Actions runner 的替代品——你的 workflow 文件不用改,把 runs-on: ubuntu-latest 换成 Blacksmith 的 runner 标签,任务就跑到它的算力上了。迁移成本很低,这也是它扩张快的原因之一。
Q:个人开发者能用吗?多少钱?
A:目前主要面向团队客户,按用量计费。个人项目建议先看它有没有免费档/试用——没有的话,同类思路可以用 GitHub 的 larger runners 或 Depot 的按量 runner 先体验"更快的 CI"是什么感觉。
Q:10 亿美元估值是不是泡沫?
A:按传统 SaaS 的市销率看肯定贵,但市场买的是"AI 代码量增长"的期权。判断泡沫与否就看一个指标:未来 4 个季度,每周 CI 任务量能不能从 9000 万继续往上走。 infra 公司的估值最终锚定在用量上,数字不会说谎。
Q:这和我(vibe coder)有什么关系?
A:直接关系是 CI 账单,间接关系是趋势——"验证"正在变成显学。现在去学 CI 优化、测试分层、runner 选型,相当于 2015 年去学 Docker:早半年就是优势。
接下来看什么
Blacksmith 说,本轮资金将用于扩大团队和算力 footprint,2027 年把算力扩到现在的 5 倍。值得跟踪的三个信号:
- 会不会推出面向独立开发者的按量付费档——这决定了 vibe coder 能不能真正用上;
- Anthropic 之后,会不会有第二家大模型厂公开自己的"AI 代码 CI 倍数",验证这个趋势;
- GitHub 会不会跟进升级官方 runner——巨头一旦认真做"快 CI",创业公司的窗口会迅速收窄。
一句话总结:AI 让写代码变成了白菜价,于是"证明代码是对的"变成了奢侈品。Blacksmith 的 10 亿美元估值,买的就是这个判断。对每天让 agent 输出几十个 commit 的 vibe coder 来说,现在就该去看一眼自己的 CI 账单了——它很可能正在悄悄变成你第二大的 AI 开销。
最后补充一个视角:Blacksmith 的故事对"卖铲子"创业者是个模板——别去和 Copilot/Cursor 拼模型,去找"AI 变快之后新出现的瓶颈"。瓶颈每转移一次,就有一批基础设施公司吃到红利。下一个瓶颈在哪?看看你的 agent 每天抱怨最多的等待是什么,答案就在那里。把这句话存下来,半年后回来验证——如果那时又有一家"验证环节"的公司成为独角兽,别说我没提醒过。历史不会重复,但会押韵——下一次瓶颈转移时,希望你已经在场。
评论 (0)
原始来源
相关文章
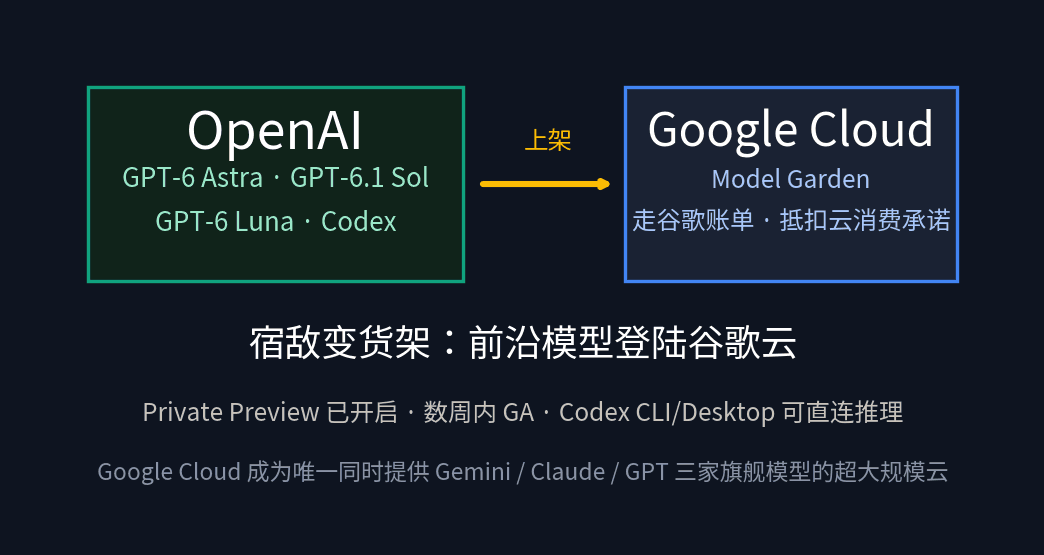
2026 年 10 月 21 日,Google Cloud 宣布 OpenAI 前沿模型(GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna)与 Codex 编程 agent 登陆 Model Garden:走 Marketplace 购买、可抵扣云消费承诺,Codex CLI 可直连 Gemini 平台做推理。
OpenAI 10 月 19 日发文,把 COBOL、Fortran、Visual Basic 这些"低资源语言"第一次变成可测量的能力:开源 MultiLangBench(只给文档、从零实现 SQLite 3.40.1,覆盖 20 种语言),外加一套要求字节级一致的 COBOL 迁移测试。GPT-6.1 Sol 迁移准确率从上一代的 5.4% 干到 97.9%。但所有数字都是 OpenAI 自报的——本文逐项打折,并给出三条给老系统维护者的实操建议。
Anthropic 让 Claude 扫描 25 个开源项目、500 万行代码,不找漏洞,而是系统性缩小攻击面:发现 493 个问题,OpenSSH 删掉约 1/5 认证前可达代码。防守的第三条路出现了。