别让 Claude Code 自己满仓库 grep:2B 本地小模型 ColGrep-Agent 接管代码搜索,token 省 34%、成本降 40%
LightOn 10 月 12 日在 Hugging Face 官方博客发布 ColGrep-Agent-2B:一个跑在本地的 20 亿参数代码搜索 agent。624 个 sessions 实测(Claude Code + Sonnet 5.5,52 题 × 13 个 2026 年新建仓库):把搜索下沉给本地小模型后,API token 省 34.3%、缓存感知成本降 40%,答对率无统计显著变化。这是第一篇用硬数字算清“小模型分工经济学”的文章。
先划一条界。本站"小模型"系列这个月已经发过三篇:ant-ling-3-1-flash 开源、JetBrains Mellum 2.1 开源代码 agent 模型、Agent37 的低成本 agent 沙箱,外加一篇 Groundcover 的 agent-to-agent 可观测性。那几篇讲的都是"模型本身"——参数、开源许可、跑分。本篇讲的不是模型,是"怎么把大模型的活拆给小模型":一个 2B 参数的本地小模型,专门替 Claude Code 干"满仓库翻代码"这件脏活,实测 API token 省掉三分之一,成本降四成。想补模型背景的,链在文末相关阅读;本篇只讲这一次分工实验。
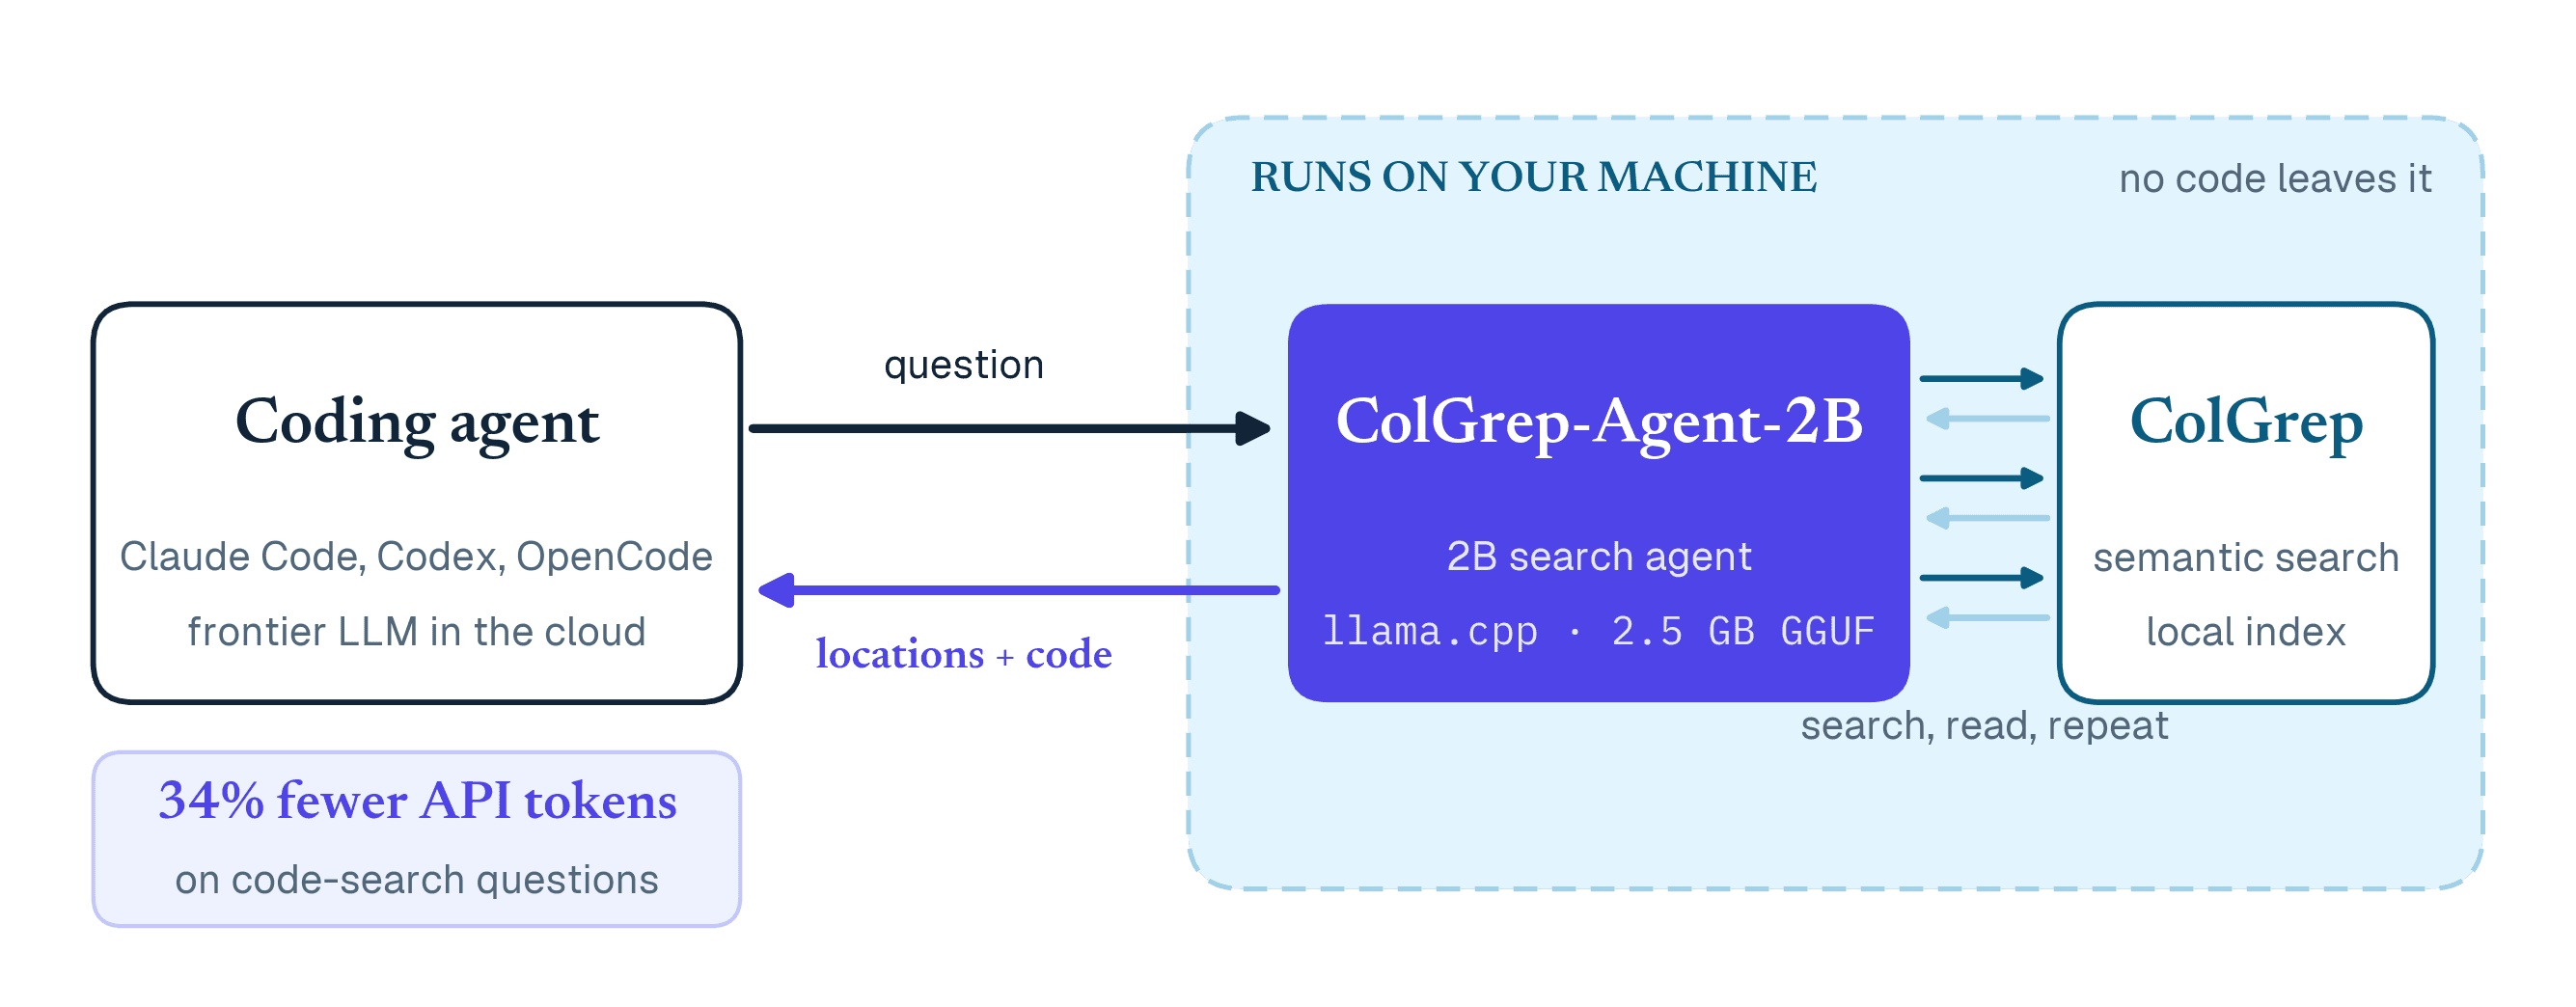
2026 年 10 月 12 日,法国 AI 公司 LightOn 在 Hugging Face 官方博客发布了 ColGrep-Agent-2B:一个 20 亿参数的开源代码搜索 agent,跑在本地,插在"你的 coding agent"和"代码仓库"之间。流程是:你给它一个自然语言问题,它用 ColGrep 做多向量语义搜索,读看起来有希望的文件,顺着引用链再搜几轮,最后交回文件路径、行号范围和代码片段——大模型拿到定位,直接推理,不用自己一轮轮试。
原文开篇特意做了一个概念区分,值得先立住,免得后面全乱:ColGrep 是多向量语义代码搜索引擎(底层是一个叫 LateOn-Code-edge 的 1700 万参数检索模型,一个函数不是一个向量,而是一个 token 一个向量,查"custom attributes"这种描述能命中代码里叫 fieldDefinition 的东西);ColGrep-Agent-2B 是模型本身(从 MiniCPM5-2B 起步,先 SFT 冷启动再用 GRPO 强化学习训出来的);colgrep --agent 是运行这个模型的命令。搜索引擎、模型、命令,三件不同的事。
本文的读法:先看评测设计(这是数字可信度的来源),再看数字和省钱的机制,然后是上手命令,接着是"小模型分工经济学"的观点,最后是判断区和没说的部分。直接想抄作业的,可以直接跳到"上手"一节,两条命令就能跑。
评测是怎么设计的:这篇的可信度从哪来
先说结论:这是厂商自测,但设计得相当老实,老实到把"可能作弊"的地方自己先堵上了。评测用的是 Claude Code 跑 Sonnet 5.5,一共 52 道代码搜索题,分布在 13 个仓库里,每道题跑 3 次,4 种配置,总共 624 个 sessions。
防"刷题"的设计有两层。第一,13 个仓库全部是 2026 年新建的公开仓库,覆盖 Rust、Go、TypeScript、Python,规模从 1.7 万行到 180 万行——选新建仓库是为了降低模型在训练时见过它们的概率。第二,作者做了一个 sanity check:让 Sonnet 5.5 在不给仓库访问权限的情况下,说出每个仓库的 10 个源文件名,结果一个都说不出来。原文自己也承认,这不能证明仓库没进过训练数据,但至少说明模型对这些仓库没有可用的记忆。这是一个"诚实但有限"的声明,比很多论文里"我们选了新数据所以没问题"的一句话带过要可信。
52 道题分两种:39 道"跨文件夹题",做法是先找一条真实的引用链(一个符号在一处定义、在另外一两处使用),再让 Claude Opus 5.5 写一道需要找全这些位置的调试题;13 道"单点题",用和代码不一样的措辞描述一个行为,考的是语义理解而不是关键词匹配。四种配置分别是:纯内置 grep(对照组)、ColGrep(大模型直接调语义搜索,不经过小 agent)、ColGrep-Agent(搜索下沉给本地 2B agent)、Balanced(名字和模式走 ColGrep,行为问题走 agent)。打分也是盲评:Opus 5.5 对照标准答案判对/部分对/错,不知道答案是哪个配置产出的;另有一个 judge 看完整 trace,两两对比排名。
token 的口径也交代清楚了:只算 Claude Code 的 API 输入输出 token,本地 2B 模型产生的 token 不算——因为不走账单,本来也不用付钱。置信区间用的是 95% bootstrap,先对每道题的 3 次运行取平均,再在题目层面算区间。
数字:token 省 34%,成本降 40%,准确率没显著变化
直接看结果表(相对内置 grep):
- 每题平均 API token:grep 142k → ColGrep-Agent 93k,省 34.3%,95% 置信区间 [28, 40];88% 的题目都省了 token。Balanced 省 21.2%,区间 [13, 29]。
- 每题缓存感知 API 成本:grep 7.3 美分 → ColGrep-Agent 4.4 美分,降 40%;Balanced 5.1 美分。
- 答对率:grep 83.3%,ColGrep-Agent 80.8%,差 2.6 个百分点,95% 区间 [-10.9, +5.1]——无统计显著差异;Balanced 的 83.3% 和 grep 的观测值完全持平。
- 轮次与耗时:平均轮次 5.5 → 3.9;但单题耗时从 13.0 秒涨到 21.6 秒——省的是钱和 token,不是时间。
 624 sessions 实测:相对内置 grep 的 token、成本、答对率对比。数据来源:LightOn HF 官方博客(2026-10-12)Table 2。
为什么省 token?原文给了机制解释:省的主要原因是大模型的搜索轮次被砍掉了。每一轮新对话都要把之前攒下的上下文重发一遍,在这些评测里平均每轮约 2.3 万 token。用 grep 时 Claude 平均要 5.5 轮、5.1 次 grep/find/ls、2.0 次读文件;交给 agent 后变成 3.9 轮、2.0 次 grep、0.9 次读文件。轮次少了,重发的上下文就少了——这就是三分之一 token 的来源。trace judge 的两两对比里,agent 的 trace 有 75% 的时间被排在 grep 前面,常见模式是"一次下沉搜索代替好几轮猜符号名"。
还有一个对 vibe 开发者很关键的分布:仓库越大,省得越多。5 万行以下省 19%,5 万到 15 万行省 29%,15 万到 60 万行省 40%;13 个仓库全部省了 token,没有例外。原文还举了一个具体例子:一道 CRM 仓库的题,问"管理员自定义属性的列表形状在哪声明、自动生成的类型化 API 层又在哪引入这个形状"。难的是措辞——代码里这些东西叫 field(fieldDefinition、fieldListOutput),不叫"custom attributes"。grep 路线走了 6 轮、16 万 token,先猜错好几次关键词;agent 路线第一轮语义搜索就落进了 fields 模块,3 轮、7.9 万 token 交卷,两边答案都对。这道题省了 51%,是高于平均的个例,但机制很典型:语义搜索跳过了"猜名字"这个最烧 token 的环节。
小模型本身有多能打:2B 干翻 10 倍体量的对手
博客的第 4 节换了个考法:不看它帮 Claude 省了多少 token,只看这个 2B 模型自己找代码有多准。考场是改装过的 SWE-bench Lite 和 Multi-SWE-bench Flash——注意考的不是生成 patch,而是代码定位:给定 issue,指出相关的文件和行。结果是,ColGrep-Agent-2B 在 SWE-bench Lite 上拿到了所有被测模型里最高的行级 F1(19.92),对手包括 10 倍以上体量的 Gemma-4-31B、Qwen3.5-27B、DeepSeek-V4-Flash。文件级 F1(76.18)也和 30B 级模型掰手腕。
另一张表更有解释力。在 Semble 代码搜索基准(1251 题、63 个仓库、19 种语言)上,对比的是 ripgrep、BM25、CodeRankEmbed 这些正经检索基线:ColGrep-Agent-2B 的 NDCG@10 是 0.868 全场最高,Precision@10 达到 0.744——BM25 只有 0.296。关键在最后一列"返回文件数":agent 平均只返回 1.7 个文件,而 BM25 返回 4.6 个、CodeRankEmbed 9.2 个。返回得少但准得多,这正是它省 token 的微观机制:大模型不需要再读一堆"可能相关"的文件来排除。
这个 2B 是怎么训出来的?起点是 MiniCPM5-2B,先用 Qwen3.5-27B 当老师生成非推理轨迹做 SFT 冷启动,再用 GRPO 做强化学习,奖励是文件 F1 和行 F1 的平均,外加"第二轮之后每多一轮就扣分"的回合惩罚——直接把"别磨蹭"写进了奖励函数。harness 只给三个工具:语义搜索、只读终端、交卷,10 回合预算,训的时候和 colgrep --agent 跑的时候是同一套。一个细节:训练时如果模型调了 grep 会被扣一点分——连"别用 grep"都是学出来的,不是写死的规则。
回到分工实验,还有一组数字值得单独拎出来看:光是 ColGrep 语义搜索(不经过小 agent,大模型直接调)就省了 24.6% 的 token;加上 agent 的多轮"搜—读—跟引用"之后,省到 34.3%。也就是说,语义搜索贡献了约四分之三,agent 的自主探索又多抠出约 10 个百分点。这组对照说明了一件事: embedding 检索是地基,agent harness 是上面的房子——只上语义搜索也能省,但让小模型自己决定"再搜一轮还是交卷",还有额外的油水。
上手:两条命令,三个集成
安装是两条命令:brew install lightonai/tap/colgrep && colgrep --install-agent。第二条会下载默认的 colgrep-agent-2B-Q8_0.gguf 模型,约 2.5GB,验证能加载,并准备好 prompt 缓存。不需要 Python 环境,不需要外部推理服务,不需要 API key。推理优先用 GPU(Apple Silicon 走 Metal,NVIDIA/AMD/Intel 走 Vulkan),没有就回落 CPU;M3 Pro 上一问约 20 秒,峰值内存 3–4GB。
仓库侧先 colgrep init 建一次索引,之后搜到文件变化会自动增量更新。接到 coding agent 有三条:colgrep --install-claude-code、--install-codex、--install-opencode。Claude Code 的集成用的是 hooks:它是在 agent 的上下文里"建议"用哪个搜索工具,而不是强制。建议的强度可以调:colgrep settings --hook-mode agent 是省 token 最多的 agent 模式,hybrid 是默认的 Balanced,colgrep 是只建议纯语义搜索。"建议而非强制"这个设计值得注意——它承认大模型有自己的判断,工具只负责把选项摆到它面前。
为什么重要:小模型分工经济学
原文结语里有一句值得全文引用级对待的话,大意是:coding agent 工作流里的每一步,并不都需要走 frontier 模型。找文件是重要工作,但大部分可以交给一个专门为仓库探索训过的小模型。这是第一篇用硬数字把"小模型分工经济学"算清楚的文章。
算账的逻辑分三层。第一层,省的不是算力,是账单。本地 2B 模型的推理不走 API 计费,token 口径里直接不算它。34% 的 token 下降几乎原样变成 40% 的成本下降(缓存感知口径下成本降幅甚至更大),因为被砍掉的正是大模型最贵的部分:带着几万 token 上下文的多轮试错。对按量付费的 vibe 开发者,这是立刻能用的省钱方案,不用换模型、不用改 prompt,装两条命令就行。
第二层,分工的边界画在了"搜索"而不是"推理"。小模型只干定位:搜、读、跟引用、交回位置;判断对错、继续推理还是大模型的事。原文的例子里,agent 交回 fields.service.ts 带着代码,Claude 自己再 grep 确认了 fields.contracts.ts:101 才交卷——大模型保留了最终校验权。这是一种"脏活外包、决策权不外包"的分工,比"让小模型替你写代码"要稳得多,因为搜索错了大不了多搜一轮,推理错了才是真错。
 分工流程:大模型保留推理与校验,搜索下沉给本地 2B 模型。本地推理不走 API 计费。
第三层,规模效应站在大仓库这边。15 万到 60 万行的仓库省 40%,百万行以上的两个仓库省 37–46%。vibe coding 的项目往往起步小、膨胀快——早期几千行时省 19% 感知不强,但项目长大之后,这个 2.5GB 的本地小模型会越来越值钱。这和"买更大模型"的思路正好反过来:不是把所有步骤都堆给更贵的模型,而是把最烧钱的步骤拆出来,交给便宜到几乎免费的本地算力。
判断区:事实与观点分开标
以上所有数字都来自 LightOn 2026-10-12 的官方博客,是厂商自测:52 题 × 13 个 2026 年新建仓库 × 3 次 × 4 配置 = 624 sessions,Claude Code + Sonnet 5.5,盲评打分。token 省 34.3%(95% CI [28,40])、缓存感知成本降 40%、答对率 80.8% vs 83.3% 无统计显著差异、Balanced 省 21.2% 且答对率持平、耗时 13.0s → 21.6s。
这是"小模型分工"第一次有可复用的账本。之前小模型的故事都是"模型本身便宜",这篇的故事是"把大模型工作流里最贵的一步拆出来"。34% 这个数字的意义不在于它多大,而在于它第一次把"拆哪一步、省多少钱、准确率掉多少"同时测出来了。以后任何"大模型 + 本地小模型"的分工方案,都得按这个格式交账:省了多少 token、准确率置信区间是什么、延迟涨了多少。
对 vibe 开发者,结论是"装",但预期要摆正。两条命令、2.5GB、无 API key、无 Python 环境,门槛低到没有理由不试。但它省的是 token 和钱,不是时间——单题 13 秒变 21.6 秒,M3 Pro 上一问 20 秒。如果你是"赶 demo"的节奏,Balanced 模式(省 21%、答对率持平、17.7 秒)是更均衡的默认;如果你是"半夜挂着让 agent 跑"的节奏,agent 模式的 34% 才划算。省钱和省时间在这里是反方向的,选哪个看你的场景。
hooks"建议而非强制"是 agent 工具集成该学的姿势。很多工具集成恨不得把自己焊进 agent 的每一步,ColGrep 反过来:只在上下文里建议,大模型可以不用,还给了三档强度可调。这种"把选择权留给大模型"的设计,长期看比强制集成活得久——因为大模型的能力在涨,今天需要强制的步骤,明天它自己就会了。
【观点四】开源 + 本地,是这套分工能成立的前提。如果这个 2B 模型是某个云 API,你省下的 token 钱会以另一种形式交回去,延迟也更不可控。正因为它是 GGUF、跑在 llama.cpp 上、索引存在本地,"分工"才真的等于"省钱"。LightOn 把模型、权重、ColGrep 引擎(next-plaid 仓库)、评测 harness 全开了源,624 sessions 的考场谁都能重跑。这种"账本开源"的发布方式,比单纯开源模型更值得鼓励——它把举证责任留给了所有人,而不是只让厂商自说自话。
还有什么没说
第一,准确率"无统计显著变化"这句话要打折听。原文自己写了:区间是 [-10.9, +5.1],宽到"不能排除有意义的下降"。52 道题的样本下,-2.6 个百分点确实不显著,但也不证明"没影响"。Balanced 模式的 83.3% 持平反而是更扎实的结论——如果你在意准确率一分都不掉,选 Balanced,别选纯 agent 模式。
第二,延迟是真代价。本地一问在 GPU 服务器上中位数 7 秒、90 分位 22 秒,端到端 13 秒涨到 21.6 秒。token 省 34% 是拿时间换的,这笔账在"人等着看结果"的交互场景里不一定划算。原文把 Balanced 设为默认 hook 模式,等于默认推荐了折中项,这个产品判断是对的。
第三,测的是"代码搜索题",不是"端到端编码任务"。找文件只是修 bug 的第一步,后面改代码、跑测试的 token 一分没省。34% 是搜索环节的节省,摊到完整任务上会被稀释。看数字的时候别把它当成"用 Claude Code 的总账单打 66 折"。
第四,厂商自测的固有限制。仓库是 LightOn 自己选的 13 个,题是 LightOn 自己出的 52 道,sanity check 的表述也很诚实("不能证明没见过")。独立第三方复测之前,把 34% 理解成"在 LightOn 设计的考场上"的成绩更稳妥。好消息是仓库、题目和 harness 都是公开的,谁都可以重跑一遍。
第五,索引本身的成本没进账。评测里每个仓库都要先 colgrep init 建一次多向量索引,之后增量更新。建索引要花多少时间、占多少磁盘,原文没给数字。对小仓库这可以忽略,对 180 万行那种大仓库,第一次建索引可能是个"先交一笔"的成本——只不过交一次,后面每题都在省,摊薄得很快。以及一个附带的隐私红利:索引存在本地,检索和 agent 推理都不需要代码离开本机。搜索这一步不经过任何第三方 API——当然大模型那一步还是走你自己的 API key,但至少"翻仓库"这个动作是完全本地的,对私有代码更友好。
相关阅读
小模型系列(讲"模型本身"的那几篇):ant-ling-3-1-flash 开源:小模型本体、JetBrains Mellum 2.1:开源代码 agent 模型、Agent37:YC F26 的低成本 agent 沙箱;agent 协作视角:Groundcover:agent-to-agent 可观测性。本篇是这个系列里第一篇讲"分工"的——模型已经够多了,缺的是把活拆开的账本。
一句话总结:ColGrep-Agent-2B 用 624 个 sessions 证明了一件事——coding agent 工作流里"满仓库找代码"这一步,不值得次次走 frontier 模型;把它外包给本地 2B 小模型,API token 省 34%、成本降 40%,准确率没有显著变化,代价是每次多等几秒。这是小模型分工经济学的第一本硬账。
评论 (0)
原始来源
相关文章
10 月 14 日,Simon Willison 在 iPhone Claude app 的 chat 模式里给 Claude Opus 5.5 Max 发了一个 prompt;3 小时 7 分钟单次推理后,交出来一款带音乐、动画、成就系统的可玩 cozy 找不同游戏。他的评价:告诉模型“保证好玩”,出奇地管用。
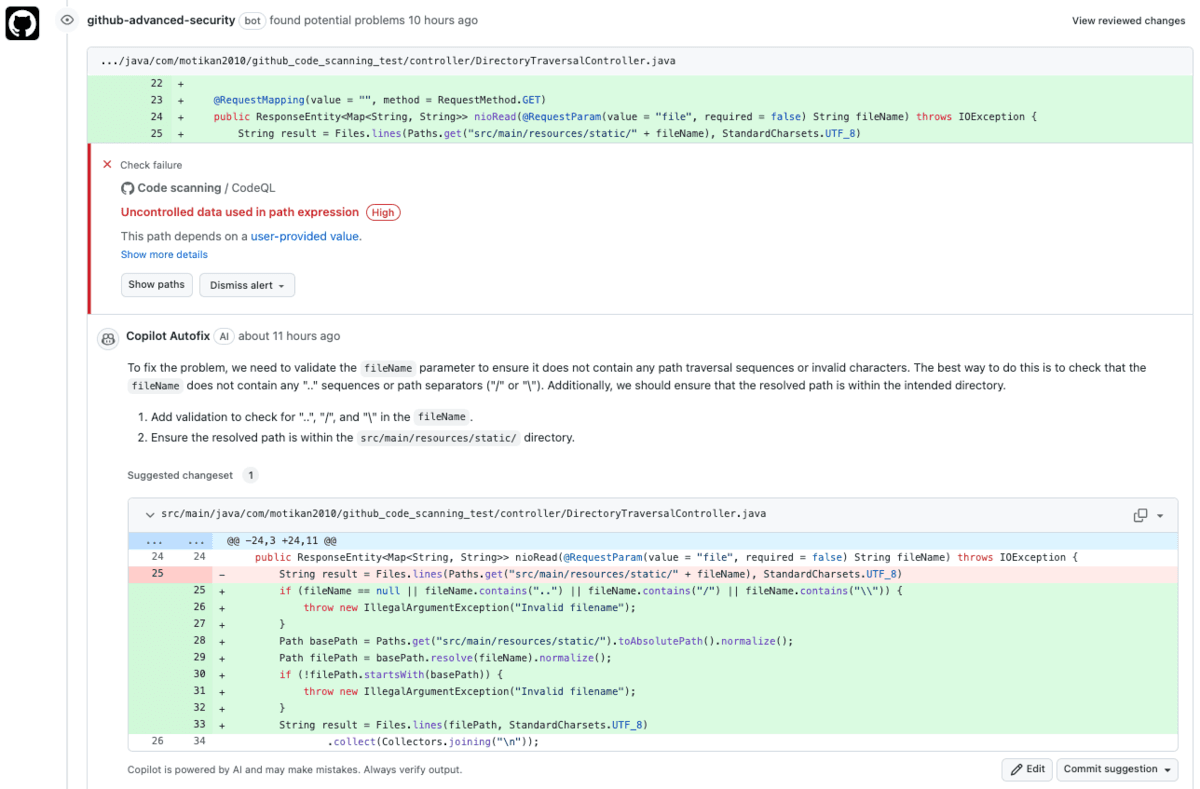
10 月 15 日,GitHub 的 agent 式自动修漏洞 GA:告警指派给 Copilot,跨代码库探索、生成修复、重跑 CodeQL 验证、开 draft PR;免费的 Generate Fix 按钮被 Assign to Copilot 取代,按 AI Credits + Actions 分钟收费,企业账单新增 Advanced Security 产品行。
AI 生成的表格代码是按 demo 数据规模写的:全量拉取卡死页面、假分页、前端排序悄悄错位。本篇讲一张表的交互工程:offset vs cursor 分页选型、排序列白名单、筛选同步 URL、JSONB 存列偏好、跨页批量选中、虚拟滚动测试方法,以及 12 项上线验收清单。