别再一次性全拉出来:vibe 项目的数据表格实战
AI 生成的表格代码是按 demo 数据规模写的:全量拉取卡死页面、假分页、前端排序悄悄错位。本篇讲一张表的交互工程:offset vs cursor 分页选型、排序列白名单、筛选同步 URL、JSONB 存列偏好、跨页批量选中、虚拟滚动测试方法,以及 12 项上线验收清单。
本篇讲的是数据列表的交互工程,与站内两篇明确分工:vibe-project-admin-panel-guide(Admin 管理后台)讲的是"后台基建怎么搭"(路由/鉴权/审计),本篇讲的是"后台里那张表怎么做"(分页/排序/筛选/列定制/批量操作)——基建 vs 表格,互链 https://vibefix.work/zh/explore/vibe-project-admin-panel-guide ;vibe-project-search-guide(站内搜索实战)讲的是"全文搜索",本篇第 3 节讲的是"表格内筛选排序"——搜全站 vs 筛本表,互链 https://vibefix.work/zh/explore/vibe-project-search-guide
先说一个你大概率见过的场面:让 AI 给你的 vibe 项目加一个"订单列表"页,prompt 发出去,代码跑起来,demo 数据 50 条,表格漂亮、排序图标会动、分页按钮齐全。你很满意,部署上线。三个月后真实数据涨到 8000 条,用户打开页面白屏 4 秒,滚动像幻灯片,点"按金额排序"之后翻到第 3 页,金额顺序是乱的。你回去看代码,发现 AI 写的分页是个摆设——这不是你 prompt 写得不好,这是 AI 生成表格代码的系统性盲区:它按 demo 数据的规模写代码,而真实数据的规模永远比 demo 大两个数量级。
本篇就是来补这一课的。只讲一张表:数据怎么从库里出来、怎么分页、怎么排序筛选、用户怎么定制列、怎么批量操作,以及大数据量下怎么渲染。全是落地细节,不讲概念。
1. 三大通病:先认出 AI 给你埋的雷
在动手改之前,先学会一眼认出这三个通病。它们几乎出现在每一份 AI 生成的表格代码里,区别只是爆雷的时间早晚。
通病一:一次性全量拉取。最常见的写法是后端一个 findMany() 全表查出来,前端 data.map(...) 全渲染。demo 阶段 50 条数据,一切正常;数据上千之后,接口返回体膨胀到几 MB,前端一次创建几千个 DOM 节点,主线程被布局计算堵死,页面直接卡住。判定的方法很简单:打开 Network 面板看列表接口的返回大小,超过 500KB 就算中招;或者打开 Chrome 任务管理器,点开列表页内存涨几百 MB,也是中招。
通病二:无分页的"假深翻"。有些 AI 会给你分页按钮,但后端每次还是全量返回,前端用 slice((page-1)*20, page*20) 切页。用户翻到第 1 页很快,翻到第 50 页请求越来越慢——因为每一页都在重复下载全量数据。更隐蔽的版本是:分页按钮存在,但没有总页数、没有"跳到第 N 页",用户只能一页一页点"下一页",几千条数据翻到天荒地老。
通病三:排序在前端排,错位给用户看。这是最阴险的一个。后端按创建时间分页返回 20 条,前端拿到这 20 条再按"金额"排序。用户在第 3 页看到的是"这 20 条里金额从大到小",但全局看,第 2 页的最大金额可能比第 3 页的最小金额还大——排序只在小窗口内成立,全局是错的。用户不会说"你的排序算法错了",他会说"你们的数据是乱的",信任直接扣光。记住一条铁律,排序、分页、筛选必须在数据库里一次完成,前端只做渲染,后面所有章节都是这条铁律的展开。
2. 分页选型:offset vs cursor,三选一决策表
分页只有两种正经做法,没有第三种。选错的代价不是"慢一点",而是某些功能根本做不出来。
offset 分页(LIMIT 20 OFFSET 40):实现最简单,天生支持"跳到第 N 页"和显示总页数。代价有两个:第一,数据库要先扫描并丢弃前面的所有行再取你要的 20 条,页码越深越慢,翻到几百页之后能明显感觉到卡顿;第二,数据在实时变化时(比如订单不断新增),用户在第 5 页停留一会儿再点下一页,前面新插入的行会把后面的行往后顶,导致漏读(某行永远翻不到)或重复(某行出现两次)。
cursor 分页(也叫 keyset 分页):不用页码,用"上一页最后一条的锚点"定位下一页:
-- offset:翻到第 10001 条,前面 10000 条先扫描再丢弃
SELECT * FROM orders ORDER BY created_at DESC, id DESC LIMIT 20 OFFSET 10000;

-- cursor:直接定位到锚点,页码多深都一样快
SELECT * FROM orders
WHERE (created_at, id) < ('2026-10-01 12:00:00', 88412)
ORDER BY created_at DESC, id DESC LIMIT 20;
cursor 的代价是:不能"跳到第 37 页"(没有锚点就翻不过去),总页数也不好算(大表的 COUNT(*) 本身就很慢)。另外锚点必须唯一:如果只用 created_at 做锚点,同一秒创建的多条订单会互相挤掉,必须拼上 id 做复合锚点——这是 AI 最常漏掉的一行。
 offset vs cursor:深翻页时的成本趋势与实时插入时的一致性差异(示意,真实数字以你的库实测为准)
决策看三个维度:
| 维度 | offset 分页 | cursor 分页 |
|---|---|---|
| 大数据量深翻页性能 | × 越深越慢,扫描丢弃成本线性上涨 | ✓ 锚点定位,页码深度不影响速度 |
| "跳到第 N 页"需求 | ✓ 天然支持,总页数、跳页输入框直接可用 | × 不支持,只能上一页/下一页连续翻 |
| 实时插入导致跳行/漏读 | × 新数据顶入会导致漏读或重复 | ✓ 锚点不动,插入不影响已翻过的页 |
落地建议:管理后台用 offset,用户侧动态列表用 cursor。后台的订单/用户表数据相对静态,运营同学需要"跳到第 58 页"和"一共 231 页"这种确定性;用户侧的动态 feed(消息流、活动流)数据不停插入,用 cursor 才能保证不跳行。一个项目里两种分页并存完全正常,按页面选,不按"技术品味"选。
3. 排序与筛选:白名单管列名,URL 管状态
 一张表的完整数据流:URL 是前端唯一的真相来源,排序分页筛选一律在库内完成
排序有两个坑,一个是安全坑,一个是逻辑坑,先说安全坑。
列名不能参数化,这是 SQL 注入的经典入口。AI 很喜欢生成这种代码:
// × 危险:用户输入直接进了 orderBy 的键名
const rows = await prisma.order.findMany({
  orderBy: { [req.query.sort]: req.query.dir },  // sort=任意字符串
  skip: (page - 1) * 20, take: 20,
});
Prisma 这类 ORM 会对值做参数化,但列名(对象的键)是拼进 SQL 结构的,用户传 sort=password 轻则报错暴露字段名,重则配合其他漏洞拖数据。正确做法是可排序列白名单:前端传的永远是业务键,后端用映射表翻译成真实列名,不在表里的直接拒绝:
// ✓ 白名单映射:用户输入只做查表,不进 SQL
const SORTABLE = {
  created: "created_at",
  amount: "total_amount",
  status: "status",
} as const;

const column = SORTABLE[req.query.sort];
if (!column) return res.status(400).json({ error: "不支持的排序列" });

const rows = await prisma.order.findMany({
  orderBy: { [column]: req.query.dir === "asc" ? "asc" : "desc" },
  skip: (page - 1) * 20, take: 20,
});
注意这个映射表还有第二个好处:前端列 id(created)和数据库列名(created_at)解耦,以后改表结构不用改前端。筛选条件的字段名同理,白名单伺候。
逻辑坑:排序必须在库内,和分页同一条 SQL。用 TanStack Table 时,如果你开了 manualPagination(服务端分页),就必须同时开 manualSorting 和 manualFiltering——三个 manual 是绑定的。只开分页不开手动排序,TanStack 会用它内置的 getSortedRowModel 对当前页的 20 条做前端排序,完美复现第 1 节的通病三。这个坑隐蔽在"看起来一切正常"里:排序图标会动,当前页确实排好了,只有翻页对比才能发现全局是错的。
筛选条件同步到 URL。表格的当前状态(页码、排序、筛选)应该全部写进 URL 查询参数:/orders?page=3&sort=-amount&status=paid。三个直接收益:链接可分享(客服把"这页数据"丢给运营,打开就是同一页);浏览器回退可用(点进详情再回来,筛选状态还在);某些公开列表页还能吃到 SEO。实现上用 TanStack Query 时,把 URL 参数拼进 queryKey,换页自动触发请求、自动缓存、回退自动命中缓存不重发。一个 AI 常忘的细节:筛选条件变化时页码重置为 1——否则用户筛完还停在第 8 页,看到空页以为出 bug 了。
最后划一条界:本节讲的是表格内结构化筛选(状态下拉框、时间范围、金额区间)。跨字段的模糊全文搜索(输入"张三"搜出所有相关订单、用户、备注)是另一套东西,归站内搜索实战那篇管,不要在本节里手搓一个 LIKE 全表扫描的"搜索框"。
4. 列定制:让用户自己决定看什么列
表格做到一定程度,用户一定会提:"能不能把'备注'列关掉?'退款金额'能不能挪到前面?"别为每个用户硬编码一套列,标准做法是存偏好,不存布局代码。
偏好存在用户表的 JSONB 字段里,按"表"分组:
-- users 表加一列 table_prefs JSONB,结构约等于:
{
  "orders": {
    "columns": [
      { "id": "created",   "visible": true },
      { "id": "customer",  "visible": true },
      { "id": "amount",    "visible": true },
      { "id": "remark",    "visible": false },
      { "id": "refunded",  "visible": true }
    ],
    "pageSize": 50
  },
  "products": { "columns": [ ... ] }
}
三条渲染约定,缺一不可:
第一,column id 必须稳定。用业务键(created、amount),不要用数组下标。否则你下次在中间加一列,所有老用户的偏好全错位。顺带一提,这个 id 和第 3 节排序白名单的键用同一套,一举两得。
第二,默认列配置永远由代码提供。用户没有偏好(新用户)或偏好里缺某列(你上线了新列)时,用代码里的默认配置补齐。合并逻辑是:偏好里的顺序和显隐优先,没见过的列按默认顺序追加到末尾。这样你加新列,老用户不受影响。
第三,服务端只存偏好,不做校验之外的事。列的渲染方式(金额加粗、状态变徽章)是前端 column def 的事,后端只管把 JSONB 原样存取。偏好接口单独一个 PATCH /me/table-prefs,别和业务接口搅在一起。
前端用 TanStack Table 的话,这套偏好直接对接到 columnVisibility 和 columnOrder 两个 state 上,改完防抖 500ms 写回后端。用户拖拽调列顺序用 @dnd-kit 这类库接 onColumnOrderChange,不要自己手写拖拽——手写拖拽的表格列是 bug 重灾区。
5. 批量操作:跨页选中、二次确认、异步进度
批量操作是表格从"展示"变成"生产力工具"的分水岭,也是 AI 生成代码翻车率最高的地方,因为涉及三个页面的状态联动。
跨页选中态保持。AI 的默认写法是把选中行 id 存在本页组件的 state 里,用户翻到第 2 页再翻回来,选中全丢了。正确做法是把选中态提升到表格之外(或 URL 之外的一个全局 store),存 Set<rowId>。但光存 id 还不够,还有第二种模式:"选中全部 N 条符合筛选的结果"——用户点了表头的全选框,期望的是把筛选出的 3000 条全选上,而不是当前页的 20 条。这时前端不存 3000 个 id,而是存一个标记 { mode: "all", filters: {...} },批量接口后端用同一套筛选条件重新查出 id 集合再执行。注意"同一套"三个字:前后端必须共用一套筛选转 SQL 的逻辑,否则用户看到的是 A 集合,实际操作的是 B 集合,这是批量操作里最危险的不一致。
危险动作二次确认。删除、封禁、退款这类不可逆操作,点"批量删除"后不要直接执行。弹窗里要显示后端实时算出来的影响行数(将删除 1,284 条订单,此操作不可撤销),让用户确认的是数字,不是按钮。这个 COUNT 请求和真正执行的批量请求用同一套筛选条件,理由同上。
批量任务转异步 + 进度反馈。一次操作几十行可以同步等,几百上千行必须走异步:前端提交后拿到 jobId,后端进队列执行,前端用轮询或 SSE 展示进度条(已处理 640 / 1284)。三个细节:第一,提交按钮加幂等 key(UUID),防用户连点发两次;第二,任务完成后给明确终态(成功 X 条、失败 Y 条,失败的可下载清单),不要只显示"完成";第三,执行期间表格数据加一个"刷新"提示,因为后台在改数据,前端缓存已经过期了。
6. 大数据量渲染:虚拟滚动 vs 分页,给测试方法不给数字
很多文章会告诉你"超过 1 万行就用虚拟滚动",别信这种绝对数字。阈值取决于你的行复杂度(一行 5 个纯文本单元格和一行带头像、徽章、操作按钮完全是两回事)、用户设备、以及框架版本。给你的不是数字,是一套 15 分钟能跑完的测试方法,在你自己的项目里测出你自己的线:
第一步,造数据。用脚本往测试库灌四档数据:1 千、5 千、2 万、5 万行,行内容尽量接近真实(别用纯 lorem ipsum,带上你真实的单元格组件)。
第二步,测三个指标。每档数据下:① 首屏可交互时间(Lighthouse 或直接看 Network + 主线程空闲);② 滚动帧率(Chrome DevTools → Performance,录 5 秒滚动,看 dropped frames 占比);③ 内存(Chrome 任务管理器里看标签页内存,对比打开表格前后)。
第三步,看交互需求做决策。数字只是输入,真正的决策变量是用户要怎么用这张表:
| 用户需求 | 选虚拟滚动 | 选分页 |
|---|---|---|
| 一眼扫完全部数据,快速滚动定位 | ✓ 连续滚动无断点 | × 翻页打断浏览流 |
| Ctrl+F 在全量数据里查找 | ✓(配合服务端搜索高亮) | × 只能搜当前页 |
| 把"第 7 页"分享给同事 / 浏览器回退 | × 滚动位置难分享、难恢复 | ✓ URL 即状态 |
| 公开页面需要 SEO | × 爬虫看不到滚动加载的内容 | ✓ 每页独立 URL |
| 审计、财务对账(要确定"看全了") | × 滚动容易漏 | ✓ 页码即进度 |
经验上说,几千行以内的普通表格直接渲染通常无感,万行以上再认真考虑虚拟化——但这只是经验,不是承诺,请用上面的三步法在你自己的表上验证。技术选型上,TanStack 生态用 @tanstack/react-virtual(和 Table 是同一作者,API 风格统一);注意虚拟滚动和第 2 节的 cursor 分页是天然搭档(都是"连续向前"模型),和 offset 的"跳页"模型是拧巴的。
7. 三态三件套:空结果、加载骨架、错误重试
一张表的完成度,30% 看正常态,70% 看三个非正常态。AI 生成的代码通常只有正常态,另外三态全靠你补。
空结果要分两种。第一种是"真的没数据"(新注册的用户,订单表空空如也):这时表格区不要只显示"暂无数据"四个字,给一个引导——"还没有订单,去创建第一条"配一个创建按钮。空状态是转化入口,不是死胡同。第二种是"筛选条件太严,筛出来是空的":必须给"清空筛选条件"一键恢复,用户自己筛空的,让他自己能一键回来。注意和搜索指南划界:那篇讲的是"搜不到关键词怎么办"(换词、放宽条件),这里讲的是"结构化筛选结果为空怎么办",场景不同,文案也不同。
加载用骨架屏,不用全屏转圈。表格的 loading 态应该是灰色行块骨架(shimmer),表头保持可见,用户一眼就知道"表格正在来"。分页/排序/筛选切换时,用 TanStack Query 的 keepPreviousData(或新版的 placeholderData):旧数据保留显示、顶部加一条细 loading 条,而不是整个表格闪一下白屏再出来。闪白屏的表格会让用户觉得"每次点一下都要重新加载",体感慢三倍。
错误给重试,不给 500。列表接口失败时,表格区显示人类能懂的话:"数据加载失败,可能是网络问题",配一个"重试"按钮。重试按钮直接调 refetch,不要让用户整页刷新。开发阶段顺手把重试逻辑也测了:把后端停掉点一次,看空态、骨架、错误三态是不是都对——这三态在 demo 时永远不会触发,上线第一天一定会触发。
8. 一人团队落地清单:技术选型 + 12 项验收
先定技术选型,亲核过官网与社区现状(2026-10-17,见文末核验记录):
TanStack Table 是 vibe 项目的默认答案。它是 headless 的:只管排序、分页、筛选、选中、列显隐这些状态逻辑,不管你长什么样,样式 100% 归你,shadcn/tailwind 直接套。但版本要选对——现在有两条主线:v8(最新 8.21.3)是久经考验的稳定线,教程、示例、AI 训练语料全是 v8 的形状(useReactTable + getCoreRowModel);v9 在 2026 年 8 月官宣 stable,是地道的 API 重写(useReactTable 改名 useTable、功能要走 tableFeatures() 注册),社区里已经出现 v9 误升级导致白屏、又 pin 回 v8 的案例。一人团队现在开新项目,直接上 v8:AI 生成 v8 代码的正确率高一个档次,v9 的新 API 它大概率按旧记忆写错。v8 对 React 19 完全兼容(支持 React 16.8 到 19),这点亲核过社区实测记录。
AG Grid 是备选,不是默认。官方自 34.3(2025 年 10 月)起支持 React 19,2026 年主线是 v35/v36。它强在企业级重型场景:透视表、Excel 导出、单元格编辑、服务端行模型,开箱即用。但代价是体积大、API 重,高级功能要企业版许可。判断标准很简单:你的表格需求里出现"透视"或"Excel 级编辑"再考虑它,否则 TanStack Table 更轻、更自由。
前后端约定三条(和第 3 节呼应):分页参数 ?page=&pageSize= 或 cursor 参数二选一;排序 ?sort=-amount(减号表降序);筛选 ?status=paid&from=2026-10-01。约定写进一篇 20 行的文档,贴在仓库 README 里,前后端各看各的。
最后是 12 项验收清单。上线前逐项打勾,一项不过不许发布:
- 列表接口返回体 ≤ 200KB(Network 面板实测,不是估算)
- 翻到第 50 页,接口耗时与第 1 页同数量级(offset 方案此项改用 cursor,或接受并记录)
- 按金额排序后连续翻 5 页,全局有序(抽查相邻两页边界的两条记录)
- 排序列传非法值(如
?sort=password),后端返回 400,不进 SQL - 筛选条件变化后页码自动回到第 1 页
- 当前页 URL 复制到新标签页打开,看到完全相同的表格状态
- 列显隐/顺序修改后刷新页面,偏好保留(JSONB 回读)
- 新加一列,老用户偏好不错位(column id 稳定性测试)
- 选中第 1 页 3 行,翻到第 2 页再回来,选中态还在
- "选中全部 1,284 条"执行批量删除,二次确认弹窗显示的行数与实际执行一致
- 断网(DevTools offline)点列表,看到可读的错误态 + 重试按钮,不是白屏
- 空筛选结果页有"清空筛选"按钮;全新空表有"创建第一条"引导
相关阅读:《vibe 项目的 Admin 管理后台实战》(本篇表格要挂在哪套后台基建里);《vibe 项目的站内搜索实战》(表格筛不出来的东西,交给全文搜索)。
一句话总结:AI 生成的表格代码按 demo 数据规模写,而你的真实数据永远大两个数量级。记住铁律——排序分页筛选在库内一次完成、列名走白名单、状态写进 URL——再把 12 项验收跑一遍,这张表就经得起真实数据了。
评论 (0)
相关文章
两个人同时改同一行是"一致性"问题,不是"实时"问题——"WebSocket 广播 JSON"的天真方案撑不过三个人(同行冲突、光标打架、断线丢数据)。本指南先与站内 realtime-features(单向推送)、offline-sync(单用户)两篇划界,再深入:OT vs CRDT 一句话讲透+选型对照表(结论先行:一人团队直接选 Yjs)、Y.Doc/Awareness/Provider 三件套(30 行客户端+40 行带鉴权的 y-websocket 服务端)、房间级 ACL 与快照兜底防恶意客户端、生产坑(大文档快照/分片、Y.UndoManager 语义、按席位计费),最后附 5 项上线验收清单。
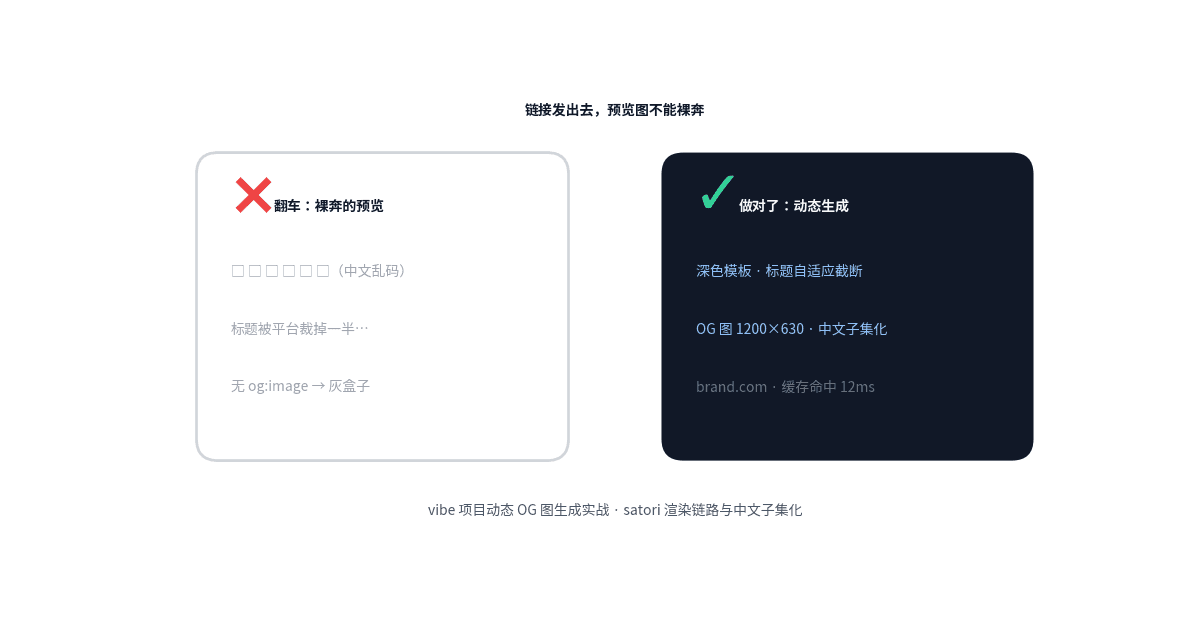
AI 生成的站点要么没有 OG 图,要么中文乱码。本篇走通 satori 渲染链路:JSX 模板→SVG→PNG,CJK 字体子集化把数 MB 压到 KB 级,边缘缓存按 slug 命中,失败时兜底默认图——一个周末搭好的动态预览图管线。
“复制链接分享”是每个 SaaS 最便宜的获客动作,也是 AI 生成代码最容易裸奔的功能。本指南拆解三大经典翻车(可枚举 ID、无过期、撤回不干净),给完整链路:不可猜测的 token 设计与 shr_ 前缀、三档只读/评论/编辑权限模型与三张 Postgres 表、可直接运行的过期+次数统一校验中间件、撤回/轮换语义与缓存失效、防枚举三层防御、分享页消费侧需要的 og 标签。最后附一人团队周末可抄完的最小实现与 10 项上线检查表。