两个人同时改同一行:vibe 项目的多人实时协同编辑实战
两个人同时改同一行是"一致性"问题,不是"实时"问题——"WebSocket 广播 JSON"的天真方案撑不过三个人(同行冲突、光标打架、断线丢数据)。本指南先与站内 realtime-features(单向推送)、offline-sync(单用户)两篇划界,再深入:OT vs CRDT 一句话讲透+选型对照表(结论先行:一人团队直接选 Yjs)、Y.Doc/Awareness/Provider 三件套(30 行客户端+40 行带鉴权的 y-websocket 服务端)、房间级 ACL 与快照兜底防恶意客户端、生产坑(大文档快照/分片、Y.UndoManager 语义、按席位计费),最后附 5 项上线验收清单。
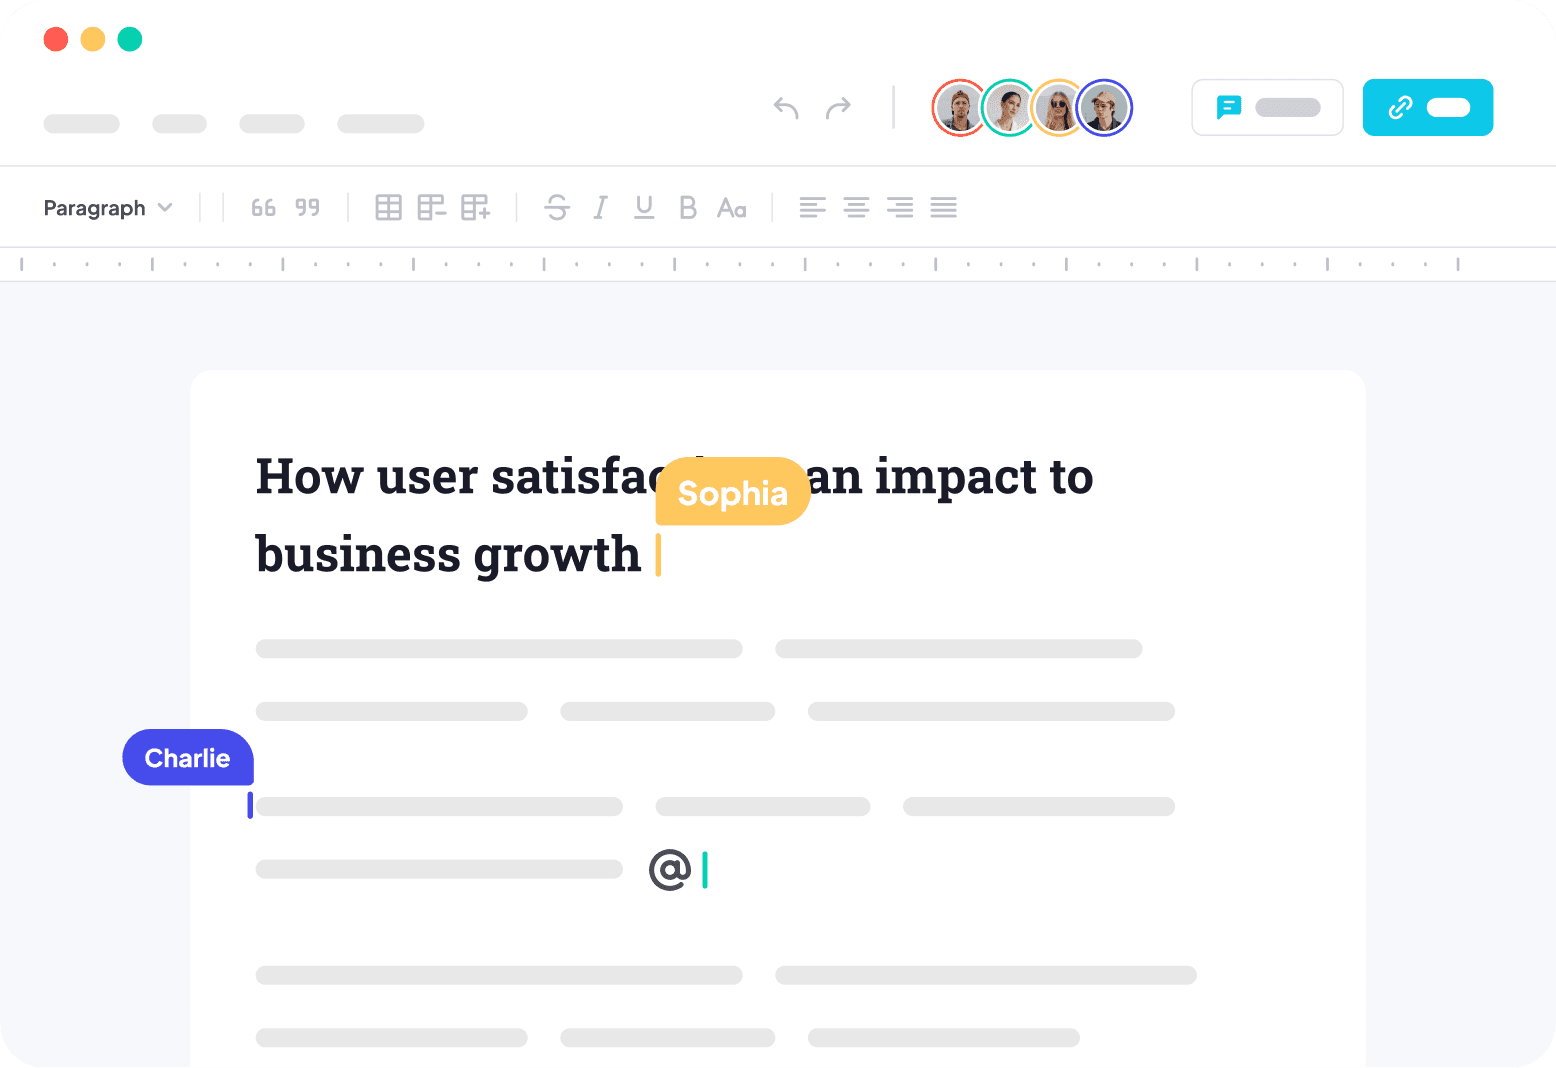
开篇先划界,避免和站内两篇指南混淆。① vibe-project-realtime-features-guide(实时功能)讲的是"服务端→客户端单向推送":股票行情、通知、在线状态,数据只从一个方向流,客户端之间互不干扰;本篇讲的是"多写者同时改同一份文档":A 和 B 在同一秒改同一行,系统必须让两边最终看到同一份内容——方向不同,互链 https://vibefix.work/zh/explore/vibe-project-realtime-features-guide 。② vibe-project-offline-sync-guide(离线同步)讲的是"单用户离线同步":一个人在地铁里写东西,出站后把本地改动合并到云端,冲突只发生在"我"和"云端"之间;本篇讲的是"多人在线并发编辑的冲突解决":冲突发生在"人"和"人"之间,实时发生、实时合并——主体不同,互链 https://vibefix.work/zh/explore/vibe-project-offline-sync-guide 。
场景很具体:你给 vibe 项目加了个"团队文档"功能,两个用户同时打开同一篇文档。A 在第一行开头打字,B 在同一行末尾删字,0.3 秒后两边的屏幕显示了不一样的内容——A 的屏幕上 B 的字没了,B 的屏幕上 A 的字跑到了奇怪的位置。刷新一下,两边又不一样了。这就是协同编辑的日常:它不是"实时"的问题,是"一致"的问题。数据能实时送达,但送达之后两边算出了不同的结果。下面这篇讲的就是怎么让"算出相同结果"这件事,从玄学变成工程。
1. 真问题:为什么"WebSocket 广播 JSON"撑不过三个人
AI 给协同编辑的第一版方案永远是这个:
// 反例:天真广播。A 的每次按键变成 JSON,通过 WebSocket 发给所有人
editor.on('change', (op) => {
  ws.send(JSON.stringify({ type: 'insert', pos: op.index, text: op.text }));
});
ws.onmessage = (msg) => {
  const op = JSON.parse(msg.data);
  editor.apply(op); // 直接按位置应用
};
两个人、网络极好、从不同时打字——这套代码能跑。一旦进入真实世界,三个场景依次把它击穿:
场景一:同时改同一行。文档是 hello,A 在位置 0 插入 X,B 在位置 5 插入 Y,两个操作在网络上"擦肩而过"。A 先应用自己的 X(文档变 Xhello),再收到 B 的"在位置 5 插入 Y"——位置 5 现在对应的是 o 后面,结果 XhellYo;B 那边对称地算出 XhelloY。两边都是"按位置应用",两边结果不一样,而且没有任何一方知道自己错了。这就是"操作需要变换":B 的操作到达 A 时,它针对的是"旧文档"的位置,必须按"A 已经改了什么"重新解释一遍位置。天真广播没有这一步。
场景二:光标打假架。就算文本最终一致了(比如靠"后到的覆盖先到的"这种糙办法),光标位置还是各说各话:A 正在第 3 行打字,B 在第 1 行插入了 10 行,A 的光标还停在"第 3 行"——视觉上光标跳到了别人刚写的内容中间。协同编辑里,光标和选区是和文本同等重要的一等公民,它们也需要实时同步、也需要随文本变化而变换位置。只同步文本不管光标的产品,用三分钟就会让人烦躁。
场景三:断线重连丢操作。A 地铁进隧道断网 30 秒,期间写了 200 个字;重连后,这 200 个字是"新操作",但 B 在这 30 秒里删掉了 A 正在写的那一段。重连的瞬间,系统要回答:A 的 200 个字是插回去、扔掉,还是变成评论?天真广播的答案是"按到达顺序硬插",结果通常是乱码式合并。真实答案是:离线期间的操作必须被完整保留,并在重连后参与"合并",而不是"覆盖"——这要求你的数据结构本身支持"延迟到达的操作也能正确合并"。
三个场景指向同一个根因:协同编辑需要的不是"更快的管道",而是"可合并的数据结构"。管道(WebSocket)只解决送达,合并需要数学。这就是 OT 和 CRDT 登场的原因。
2. OT vs CRDT:结论先行,一人团队直接选 CRDT/Yjs
两句话讲透原理,细节看对照图:
- OT(Operational Transformation,操作变换):所有操作先发到中心服务器,服务器按到达顺序给操作"排队",后到的操作要按"先到的改了什么"做一次变换(改位置、改内容)再广播。Google Docs 早期、Etherpad、ShareDB 都是这条路。一致性靠服务器定序保证——服务器是唯一的真相来源。
- CRDT(无冲突复制数据类型):不给操作排队,而是换数据结构:文档里的每个字符带一个全局唯一的 ID(谁、何时、插在谁后面),合并两个副本 = 取字符集合的并集。数学上保证:无论更新以什么顺序到达,所有副本最终收敛到同一个结果。Yjs、Automerge 是这条路的代表。
/media/content-media/a56f3ccd-38fe-490f-a5d3-6edb6bc228d5/2026/10/47efffcf-1779-4d1e-8492-314362a223f9.png
选型对照表(给决策用的,不是给论文用的):
- 服务端复杂度:OT 必须自建定序 + 变换逻辑,这是"造数据库"级别的工作量;CRDT 的服务端只做消息中转(Yjs 的 y-websocket 服务端不解析文档内容),复杂度低一个数量级。
- 离线支持:OT 的离线是hard模式——重连后积压的操作要重排、重变换,变换函数还要处理"操作针对的文档版本已经不存在了";CRDT 天然支持离线:本地先写,重连后把更新一发,数学保证合并正确。
- 扩展性:OT 的中心服务器是瓶颈和单点;CRDT 的服务端无状态可水平扩展(Yjs 官方文档明确写了可以用 Redis PubSub 做多服务器扩展)。
- 生态:Yjs 有 ProseMirror / Tiptap / Monaco / CodeMirror 的现成编辑器绑定,Yjs 官方文档的编辑器支持一节逐个列出;OT 这边大多要自己对接。
所以结论先行,不绕弯子:一人团队做协同编辑,直接选 CRDT,具体选 Yjs。OT 唯一的优势场景是"你需要对操作内容做强管控"(比如金融级的审计定序),vibe 项目基本碰不到。选 Yjs 不是因为它时髦,是因为它把"最难的那部分"(合并的数学正确性)封装好了,你只需要做"最dirty的那部分"(鉴权、持久化、产品逻辑)——而后者恰恰是 AI 相对擅长的。
3. Yjs 落地:Doc / Awareness / Provider 三件套
Yjs 的架构是三个正交的概念,各管一摊,互不越界(见下图)。先建立这个心智模型,再看代码就不会晕:
/media/content-media/a56f3ccd-38fe-490f-a5d3-6edb6bc228d5/2026/10/88b0dbac-b282-4fe8-9347-6f41f18aa552.png
- Doc:本地的一份完整文档副本,是 CRDT 数据结构本身。所有读写都发生在本地 Doc 上,先写本地、再广播——这是"本地优先"(local-first)的核心,也是断线可写的根基。
- Provider:传输层,负责把本地 Doc 产生的"更新"(update,一种二进制增量)发给别人、把别人的更新拿回来。换 WebSocket、WebRTC 还是你自己的私有协议,只是换 Provider,Doc 层不动。Yjs 官方文档原话:它对网络技术不做任何假设,只要更新最终能到达,文档就能同步,更新的应用顺序无关紧要。
- Awareness:临时状态通道,传"谁在线、光标在哪、选了哪段"。注意它是临时的:不持久化,掉线即消失——别把业务数据往里面塞。
客户端:30 行跑通第一个协同房间
import * as Y from 'yjs';
import { WebsocketProvider } from 'y-websocket';
import { IndexeddbPersistence } from 'y-indexeddb';

// 1. Doc:本地副本。一人一个,互不干扰地写
const ydoc = new Y.Doc();
const ytext = ydoc.getText('content'); // 共享文本类型;还有 getMap/getArray

// 2. 本地持久化:先写 IndexedDB,离线也能写、刷新不丢
//    (文档级隔离:room 名即 key,不同文档互不串)
const persistence = new IndexeddbPersistence('doc-123', ydoc);

// 3. Provider:连上房间,更新自动双向同步。以下 API 均出自 y-websocket 官方文档
const provider = new WebsocketProvider('wss://yourapp.com/collab', 'doc-123', ydoc, {
  params: { token: 'user-jwt-here' }, // 鉴权见第 4 节:走 URL 参数或 cookie
});
provider.on('status', (e) => console.log(e.status)); // 'connected' | 'disconnected'
provider.on('sync', (isSynced) => {
  if (isSynced) console.log('已与服务端对齐,可以开始编辑');
});

// 4. Presence:我的光标/名字,广播给房间里所有人
provider.awareness.setLocalStateField('user', {
  name: 'lee', color: '#4f46e5', cursor: { anchor: 12, head: 18 },
});
// 监听别人:awareness.getStates() 拿到 Map<clientId, state>
provider.awareness.on('change', () => renderCursors(provider.awareness.getStates()));

// 5. 编辑器绑定(二选一,按你用的编辑器):
//    Tiptap:  @tiptap/extension-collaboration  + CollaborationCursor
//    CodeMirror: y-codemirror.next
//    都只是把"编辑器操作"翻译成"ytext 操作",合并逻辑仍在 Yjs 里
注意第 5 点的定位:编辑器绑定是"翻译层",不是"合并层"。有人担心"Tiptap 的协同和 Yjs 的协同是不是两套",答案是不是——翻译层只负责把按键变成 ytext.insert/delete,冲突解决 100% 在 Yjs 的 CRDT 层。这意味着换编辑器不换合并语义,这是 Yjs 生态最值钱的一点。
服务端:最小实现 40 行,核心只有"中转 + 鉴权"
y-websocket 自带可直接跑的服务端(npx y-websocket,PORT 环境变量默认 1234,官方文档有写),但生产环境你大概率要自己包一层——原因只有一个:鉴权。官方默认服务端是不鉴权的,任何人连上任何房间名就能读写。下面是最小的自建服务端(Node,基于 y-websocket README 的自定义服务端写法,setupWSConnection 是该包导出的标准函数):
import http from 'node:http';
import { WebSocketServer } from 'ws';
import { setupWSConnection } from 'y-websocket/bin/utils.js';
import jwt from 'jsonwebtoken';

const server = http.createServer();
const wss = new WebSocketServer({ noServer: true });

// 鉴权发生在"升级"阶段:token 无效,连接根本建不起来
server.on('upgrade', (req, socket, head) => {
  const token = new URL(req.url, 'http://x').searchParams.get('token');
  const room = req.url.split('/')[1]; // 约定:/doc-123?token=xxx
  try {
    const user = jwt.verify(token, process.env.JWT_SECRET);
    if (!canAccess(user.id, room)) { // 文档级 ACL:查你的业务数据库
      socket.write('HTTP/1.1 403 Forbidden\r\n\r\n');
      return socket.destroy();
    }
    req.user = user; req.room = room;
    wss.handleUpgrade(req, socket, head, (ws) => wss.emit('connection', ws, req));
  } catch {
    socket.write('HTTP/1.1 401 Unauthorized\r\n\r\n');
    socket.destroy();
  }
});

// 鉴权通过后,剩下的就是纯中转:服务端不解析、不定序、不存(存见第 5 节)
wss.on('connection', (ws, req) => setupWSConnection(ws, req, { docName: req.room }));
server.listen(1234);
这段代码体现了 Yjs 服务端的哲学:连接层做鉴权,传输层只做中转。服务端不理解文档内容(update 是二进制,服务端原样转发),所以"操作级鉴权"(比如"只读用户不能写")不能在 Yjs 层做——第 4 节会讲真正的防线在哪。
4. 权限与隔离:谁能看、谁能改
协同编辑的权限模型和普通 CRUD 不一样:普通接口是"请求→鉴权→执行",一次请求一个鉴权点;协同是"建连一次、传几千个操作",你不可能给每个按键都调一次鉴权接口。所以权限必须分两级,各管各的:
第一级:房间级(连接时)。就是第 3 节服务端代码里做的:用户连 /doc-123 之前,查业务数据库确认"这个用户对 doc-123 是什么角色"(owner / editor / viewer / 无)。无权限直接 403,连都连不上。这是最重要的防线,挡掉了 99% 的越权。
第二级:角色→能力的映射(客户端 + 服务端快照校验)。viewer 能连,但只能收不能发——做法是客户端根本不为 viewer 创建"可写"的绑定(编辑器设为只读模式,不产生本地 update);同时服务端定时把 Doc 快照落库时做一次"权威校验"(见第 5 节):如果某个 viewer 的客户端被篡改、硬发了 update,快照校验会发现"这个角色不该产生写入",报警并回滚。注意这里的诚实划分:Yjs 传输层本身不做操作级鉴权——update 是二进制,服务端中转时不解析,这是设计使然,不是漏洞。指望"服务端逐条检查每个操作是否合法"的人,是把 OT 的中心化思维套在了 CRDT 上。
恶意客户端的防线:按"能力"而不是按"信任"设计
把话说白:任何客户端都是不可信的。浏览器里的 JS 用户想改就改,伪造一个"删除全文"的 update 发出来,技术上毫无难度。防线有三层:
- 房间隔离:房间名用不可猜测的 ID(UUID),别用自增 ID。连房间名都猜不到,伪造操作无从谈起。这是成本最低的一层,经常被忽略。
- 快照权威校验:服务端定期(比如每 30 秒或每 100 个 update)把 Doc 全量快照
Y.encodeStateAsUpdate(ydoc)落库,落库前跑一遍业务规则校验("viewer 角色的客户端不应产生写入""单次 update 大小不超过 X")。发现异常:报警 + 用上一个干净快照恢复 + 踢掉肇事连接。Yjs 官方文档的 y-websocket 一节明确提到服务端可以配置 persistence(LevelDB)和 HTTP 回调——落库和校验就挂在这两个钩子上。 - 操作审计:update 本身带客户端 ID,服务端中转时把"哪个连接发了多少个 update"记下来。出了事能定位到人,本身就是一种威慑。一人团队做到"能定位"就行,"实时拦截"是以后的事。
一句话总结权限模型:连接时验身份(房间级),平时靠快照兜底(事后校验),别指望传输层逐条审操作。这个模型和"API 鉴权"的直觉不一样,但它是 CRDT 去中心化架构下唯一自洽的做法。
5. 生产坑:大文档、历史版本、计费
坑一:大文档性能
Yjs 的 update 是"增量日志":文档的每一次修改都追加一条记录,永不删除(删除在 CRDT 里是"标记删除",tombstone 要留着,否则后到的并发操作找不到锚点)。一篇被 20 个人改了三个月的文档,update 日志可能膨胀到几十 MB——新用户进房间要下载全量日志重放,首屏直接卡死。解法有两个:
- 快照(snapshot):服务端定期把 Doc 压成一份全量快照
Y.encodeStateAsUpdate(ydoc),新客户端先拿快照(一次到位),再增量同步快照之后的新 update。快照是"压实的日志",体积小一个数量级。这是官方推荐的标准做法,不是奇技淫巧。 - 分片:按"章"拆 Doc(一章一个 Y.Doc / 一个房间),而不是整本书一个 Doc。协同的粒度越小,单个 Doc 的日志越短,加载越快。Notion 的"块"、Google Docs 的"分页"背后都是这个思想:协同单元要和人的心智单元对齐,而不是和"文件"对齐。
坑二:历史版本与 undo 的语义
"查看历史版本"和"撤销"是两个需求,别混在一起:历史版本 = 快照的时间序列(服务端每 N 分钟存一份全量快照,列出来让用户点),实现简单;撤销 = "只撤销我自己的操作,不影响别人同时写的字"——这个语义在协同下是微妙的:A 删了一段话,B 在那段话中间加了批注,A 按 Ctrl+Z 时,B 的批注怎么办?Yjs 给了标准答案:Y.UndoManager(yjs 包自带),它按"操作的所有者"分组,只回滚当前用户的操作,别人的并发写入不受影响。直接用它,别自己写 undo 栈——自己写的 undo 在单用户下是对的,在协同下 100% 有 bug,因为"撤销"本身也是一个需要合并的操作。
坑三:服务端权威校验(防作弊写库)
第 4 节提过,这里展开工程做法:服务端维护每个房间的"影子 Doc"(只收 update、不对外服务),定时做三件事——① 落快照到对象存储/数据库(权威备份,客户端全丢了也能恢复);② 跑业务规则校验(角色、大小、频率);③ 生成历史版本。影子 Doc 的内存占用是实打实的成本:1 万个活跃房间 = 1 万个 Doc 常驻内存——所以不活跃的房间要及时 GC(y-websocket 的 utils 里 Doc 有引用计数,无连接一段时间后释放,配好超时别让内存泄漏)。
坑四:计费按"协作者席位"
协同编辑的计费模型,行业惯例是按"席位"(seat):一个文档不管多少人看,同时可编辑的人数(或月活协作者数)决定档位。技术上,"在线协作者数"直接读 awareness 的状态数就行——provider.awareness.getStates().size 就是当前房间的实时人数,天然就是计费口径。但注意 awareness 掉线即消失的特性:计费要按"去重后的月活用户"算,而不是"瞬时在线峰值",否则用户会为"我开了三个标签页"付三份钱——标签页去重用 BroadcastChannel(y-websocket 官方文档明确写了支持跨标签页通信,同一浏览器的多个标签页只建一条真连接),别重复计费。
6. 上线清单:5 项验收,少一项都别发
协同编辑的 bug 有个恶毒的特点:出问题时两边看到的不一样,但没有任何一方报错。没有崩溃、没有 500,只是 A 和 B 的屏幕悄悄分叉了。所以验收必须"主动制造分叉条件",而不是"点点看没报错就行":
- ✓ 并发压测:开 5 个客户端(无头浏览器就行),同一秒往同一行的 5 个不同位置各插入 20 个字符,结束后对比 5 端的最终文本哈希——必须完全一致。哈希不一致 = 合并有 bug,天塌了。
- ✓ 断线重连:A 断网 30 秒,期间写 50 个字;B 在这 30 秒里删掉 A 正在写的那一段。重连后:A 的 50 个字一个不少(可能位置变了,但内容不丢),B 的删除也生效。丢字 = 本地 Doc 或 IndexedDB 链路有问题。
- ✓ 权限越界负向测试:拿 viewer 的 token 试图连编辑房间 → 必须 403;连上只读房间后,用控制台硬调
ytext.insert伪造写入 → 服务端快照校验必须报警(或至少:其他客户端收到后,刷新页面数据被快照纠正)。"客户端只读"只是 UI 层,真正的防线在服务端。 - ✓ undo 一致性:A 写一段话,B 在中间加批注,A 按 Ctrl+Z:A 的话消失,B 的批注还在(可能位置移动,但不消失)。批注被连带撤销 = UndoManager 没配对,自己写的 undo 栈可以扔了。
- ✓ 性能基线:10 万字符的文档(含 3 个月 update 日志):新客户端从进房间到可编辑,P95 耗时记下来(目标 <2s,靠快照);单次按键到对端渲染的延迟,局域网/4G 下分别记(目标 <300ms)。基线是写给三个月后的你的——到时候文档更大了,拿出来对比就知道什么时候该分片。
一句话总结:协同编辑 = CRDT 解决"合并正确"(选 Yjs,别自己写 OT)、Provider 解决"送达"、Awareness 解决"谁在哪"、服务端解决"鉴权和兜底"。四件事各就其位,别指望一层包办。相关阅读:实时功能实战:服务端到客户端的单向推送(数据只从一个方向流);离线同步实战:单用户的本地优先(冲突只发生在"我"和"云端"之间)——单向推送、单用户离线、多人在线并发,三篇各讲一种实时性,互不重叠。
评论 (0)
相关文章
AI 生成的表格代码是按 demo 数据规模写的:全量拉取卡死页面、假分页、前端排序悄悄错位。本篇讲一张表的交互工程:offset vs cursor 分页选型、排序列白名单、筛选同步 URL、JSONB 存列偏好、跨页批量选中、虚拟滚动测试方法,以及 12 项上线验收清单。
10 月 15 日,GitHub 让 Slack/Teams 里的 Copilot 支持多仓库:一个对话横扫所有仓库的 open PR、本周合并、跨仓库 issue;@GitHub 可出现在消息任意位置,Slack thread 直接当上下文——而 cloud agent 的代码变更仍限单仓库、单分支、单 PR。
AI 生成的暗色模式有三种固定套路的翻车:颜色写死散落各文件、切换时全屏闪白、系统偏好与用户选择打架。本指南给完整工程解法:语义化 CSS 变量(design token)作为唯一真相源、Tailwind v4 的 @custom-variant 接线、system/light/dark 三态状态机与 localStorage vs cookie 持久化规则、根治 SSR 首屏闪烁的 <head> 内联脚本(含 Next.js App Router 实操与量化验收),以及深水区——图片、canvas 图表、iframe 嵌入、WCAG AA 对比度抽查法,最后附硬编码颜色迁移的 5 步 SOP(含 AI 批量改写 prompt 与回归检查清单)。