链接发出去,预览图不能裸奔:vibe 项目的动态 OG 图生成实战
AI 生成的站点要么没有 OG 图,要么中文乱码。本篇走通 satori 渲染链路:JSX 模板→SVG→PNG,CJK 字体子集化把数 MB 压到 KB 级,边缘缓存按 slug 命中,失败时兜底默认图——一个周末搭好的动态预览图管线。
本篇讲的是分享预览图怎么生产,与站内两篇明确分工:vibe-project-seo-aeo-guide(SEO/AEO 实战)讲的是"OG 标签怎么写"(基础 meta 标签),本篇讲的是"og:image 那张图怎么动态生成"(satori 渲染/中文子集化/边缘缓存)——标签 vs 图片生产,互链 https://vibefix.work/zh/explore/vibe-project-seo-aeo-guide ;vibe-project-share-links-guide(分享链接实战,拟与本轮同发)讲的是"分享链接消费侧需要哪些 og 标签",本篇讲的是"这些标签指向的图片怎么造出来"——消费 vs 生产,互链 https://vibefix.work/zh/explore/vibe-project-share-links-guide
1. 为什么默认 OG 图不够用
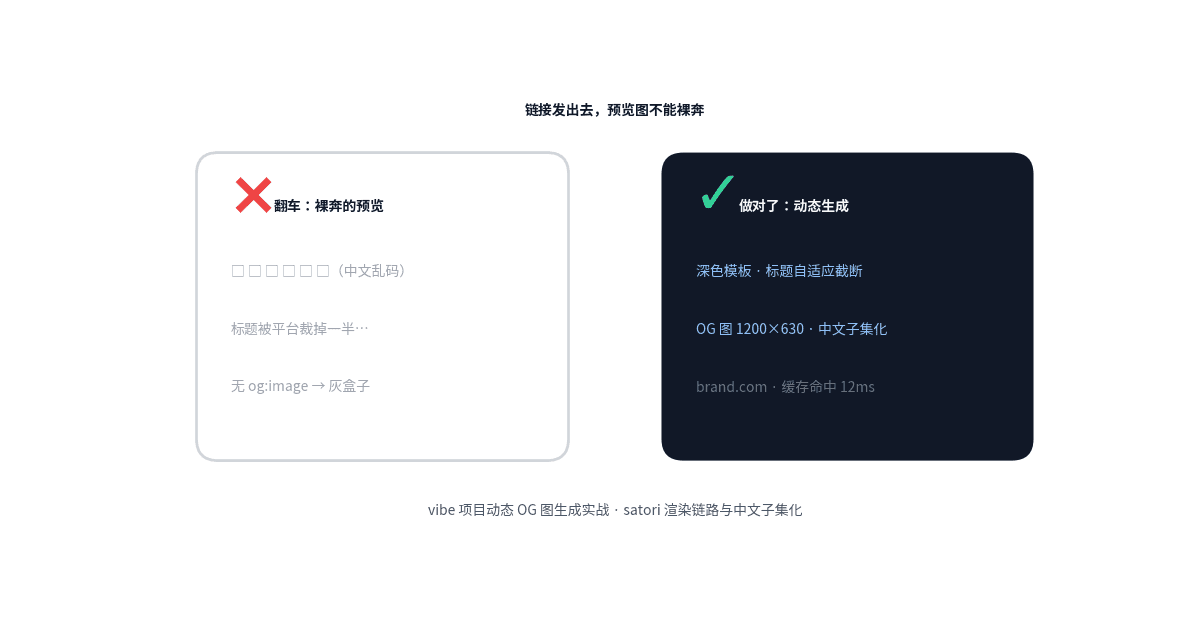
把链接丢进 X、微信、Slack、iMessage,看一眼展开的那张卡片,就是用户对你项目的第一印象。没有 og:image 的链接长什么样,你一定见过:一个灰盒子,或者一张被平台硬裁的网站 favicon,标题旁边空荡荡的。这种链接的点击率和带精美预览图的根本不在一个量级——卡片是注意力,灰盒子是噪音。
AI 生成站点的惨状格外集中,因为大多数 vibe 项目根本没人处理过这张图:
- 无图。AI 搭的站点十个有九个没有 og:image 标签,分享出去就是平台默认的灰盒子。页面本身做得再漂亮,分享出去的那一刻等于裸奔。
- 中文乱码/豆腐块。装了动态生成链路,但没给中文字体,或者给了个拉丁字体。中文标题渲染出来是"口口口口",比没图更丢人——没图是懒,乱码是坏。
- 被裁。1200×630 的图,平台按 1.91:1 展示;标题写了三行,平台只显示两行;关键信息(价格、日期、品牌)正好落在安全区外面。图有了,但信息没了。
这三类惨状有一个共同点:它们都发生在"链接被分享"的瞬间,而那个瞬间你没法手动救火。所以 OG 图必须是一个工程问题,而不是一个设计问题:模板化、自动化、有兜底。
2. 方案选型:三选一决策表
动态生成 OG 图,主流就三条路。先上结论,再讲为什么:
| 方案 | 原理 | 成本 | 中文支持 | 动态性 | 适合谁 |
|---|---|---|---|---|---|
| satori(HTML→SVG→PNG) | JSX 写模板,satori 排版成 SVG,再转 PNG | 低(纯计算,无浏览器) | 手动加载字体 + 子集化后优秀 | 极强(按 slug/标题实时渲染) | 绝大多数 vibe 项目,本文主推 |
| 无头浏览器截图 | Playwright/Puppeteer 打开页面截图 | 高(Chromium 冷启动慢、内存大) | 好(浏览器原生字体回退) | 强,但慢且贵 | 页面本身就是图、不想维护两套模板时 |
| 静态设计图 | 设计师出一张,全部页面共用 | 最低 | 无问题(人工出图) | 无(全站一张) | 单页站点、MVP 验证期 |
satori(Vercel 开源,GitHub 1.4 万+ star,2026 年 10 月仍在活跃迭代,npm 上已到 0.38.x)是这条链路的事实标准:它只做一件事——把 JSX+CSS 排成 SVG,速度比起浏览器快一个数量级,且没有浏览器依赖,天然适合跑在边缘函数里。Next.js 的 next/og(ImageResponse)底层就是 satori,Vercel 的 OG 图片生成文档目前仍在维护,Next.js 用户可以直接用官方封装。
替代方案值得知道名字:2026 年 10 月有开发者实测把 Astro 构建期的 OG 生成从 satori 换成 Takumi(Rust 实现的同类库),160 个页面的冷构建快了约三成。如果你是构建期批量生成、且对构建时长敏感,可以评估;运行时按请求生成的话,satori 的生态和文档仍然是最稳的选择。
哪三种情况不该选 satori?说实话。第一,模板需要完整现代 CSS(容器查询、复杂 grid 自动排布、backdrop-filter)——satori 实现的是有意的 CSS 子集(文档里逐条列了哪些属性和浏览器一致、哪些不一致),跟这个子集较劲的成本比无头截图更高。第二,OG 图必须和用户看到的页面像素级一致(仪表盘导出、证书类)——直接截真实页面,保证所见即所得,零模板漂移。第三,团队边缘零 JS、全部构建期预渲染——设计师维护 Figma 文件的静态管线可能是维护成本最低的方案。上面的决策表是默认值,不是教条:正确答案是你这个一人团队真正愿意长期维护的那一个。
安全插一句,2026 年 9 月 22 日曝过一个和这条链路直接相关的漏洞:satori 生成 SVG 时转义不当(GHSA-wx4j-mvgx-mqwp),在 Next.js Node 运行时的 ImageResponse 里可被放大成 RCE(GHSA-vcvr-r3jv-pc5j / CVE-2026-94545)。修复版本是 satori ≥ 0.33.5、Next.js ≥ 16.3.6(或 15.5.26 加固版);Edge 运行时的 ImageResponse 不受影响。结论很简单:装依赖时直接上最新版,动态参数一律做转义,第 6 节有兜底写法。
3. 中文大坑:字体子集化
这是中文项目翻车的头号原因,机制值得讲透。satori 渲染文字不依赖系统字体——它只认你显式传进 fonts 数组的字体文件。一个完整的 CJK 字体(比如 Noto Sans SC)动辄数 MB:放到边缘函数里,每次冷启动都要下载、解析这几 MB,延迟和内存双双爆炸;更糟的是,很多人嫌麻烦干脆不传中文字体,于是中文字符没有字形可用,渲染出来就是豆腐块。
解法是字体子集化:只打包模板实际用到的字形。一个 OG 模板的文案是高度可控的——固定文案("首页""文章""立即体验"这类)加上可枚举的变量(文章标题、项目名),把用到的字符收集起来,切出一个只有几十 KB 的子集字体。体积从 MB 级掉到 KB 级,见下图(量级示意):
 字体子集化:完整 CJK 字体数 MB vs 子集化后 KB 级(量级示意,非精确数值)
子集化脚本(Node + fontkit,照着跑):
// scripts/subset-font.js
const fs = require('fs')
const fontkit = require('fontkit')

// 1. 打开完整 CJK 字体
const font = fontkit.openSync('fonts/NotoSansSC-Regular.otf')
const subset = font.createSubset()

// 2. 收集模板会用到的全部字符:固定文案 + 所有标题
const fixed = '首页文章项目关于立即体验下载分享阅读·—…'
const titles = JSON.parse(fs.readFileSync('titles.json', 'utf8')).join('')
const chars = new Set((fixed + titles).split(''))

// 3. 只打包这些字形的 glyph
for (const ch of chars) {
  const glyph = font.glyphForCodePoint(ch.codePointAt(0))
  if (glyph && glyph.id !== 0) subset.includeGlyph(glyph.id)
}

// 4. 输出子集字体
fs.writeFileSync('fonts/NotoSansSC-subset.ttf', Buffer.from(subset.encode()))
console.log(`子集化完成:${chars.size} 个字符 → fonts/NotoSansSC-subset.ttf`)
几个实战要点:
- 标题是变量时,字符集必须跟着变。用户生成内容(UGC)的标题没法预先枚举:做法是定时(比如每天一次)重新扫描全站标题、重新跑子集化脚本,产物进版本控制或对象存储。构建期跑一次,线上永远用最新的子集。
- fontkit 不是唯一工具。Python 生态用
pyftsubset(fonttools)一行命令也能切;Google Fonts 的 CSS API 支持&text=你的文字参数,服务端按需拉取即切即用,记得把结果缓存下来别每次都请求。 - 字重与 fallback 链。satori 的
fonts数组按顺序匹配:先放粗体子集,再放常规子集,最后放一个拉丁字体(Inter 这类几百 KB 的)处理数字和英文。一个中文站点常见的翻车是只给了中文常规字重,模板里fontWeight: 700的标题被静默降级成"伪粗体"甚至回退到默认字体——字重要和模板里用到的每一档一一对应。 - emoji 单独处理。satori 内置的 emoji 支持有限,正确姿势是再加载一个 emoji 字体(如 Noto Emoji 或 Twemoji,同样做子集化,只留模板用到的几个)。或者更干脆:OG 模板里不用 emoji,用 SVG 图标代替——跨平台渲染最稳定。
4. 模板设计约束
OG 图是 1200×630,但"能用"的区域比这小。各平台的展示比例不完全一致(X 的大卡片、微信聊天窗口、Slack 展开图各有裁剪),经验法则是:关键信息放在中央 1000×540 的安全区内,四周各留 100px 左右的边距,品牌 logo 和标题都别贴边。
标题溢出是第二大翻车点。动态标题长度不可控,模板必须写死截断策略:
- 单行标题:
whiteSpace: 'nowrap', overflow: 'hidden', textOverflow: 'ellipsis',超长直接省略号。 - 多行标题:固定行数(一般 2 行),用
lineClamp: 2,第 3 行起截断。satori 支持 lineClamp,但注意它对浮动元素后的文本不生效——模板里别在标题旁边放浮动元素。 - 字号分档:标题超过 20 字自动降一档字号。别指望 CSS 的
clamp()之类花活,satori 的 CSS 是子集实现,写最保守的样式。
深色/浅色两套模板不是为了好看,是为了可读性:深色模板配浅色字、浅色模板配深色字,对比度拉满。分享卡片在手机上只有火柴盒大,灰底灰字等于隐形。品牌色只做点缀(一条色带、一个 logo),别做大面积底色——不同平台的缩略图压缩算法对大面积纯色+文字的组合很不友好,糊成一片。
最后一条铁律:模板里别放外部图片 URL。satori 支持 <img>,但运行时去拉外部图等于给渲染链路加了一个不可控的网络依赖。logo 这类固定素材转成 base64 或 ArrayBuffer 内联进模板,用户头像这类变量走"构建期下载到本地、渲染时读本地文件"的路线。
5. 边缘部署与缓存
完整链路见下图。核心思想一句话:渲染是昂贵的,所以只渲染一次,之后全走缓存。
 satori 渲染链路:JSX 模板 → satori → SVG → PNG → 边缘缓存 → 各平台抓取
最小可跑代码(Next.js App Router,Edge 运行时):
// app/og/route.tsx
import { ImageResponse } from 'next/og'

export const runtime = 'edge'

// 字体在模块作用域加载一次,别每次请求都读
const fontData = fetch(
  new URL('./fonts/NotoSansSC-subset.ttf', import.meta.url)
).then((res) => res.arrayBuffer())

export async function GET(req: Request) {
  const { searchParams } = new URL(req.url)
  const title = (searchParams.get('title') ?? '默认标题').slice(0, 60)

  return new ImageResponse(
    (
      <div
        style={{
          width: '100%',
          height: '100%',
          display: 'flex',
          flexDirection: 'column',
          justifyContent: 'center',
          padding: '80px 100px',
          background: '#111827',
          color: '#F9FAFB',
          fontFamily: '"Noto Sans SC"',
        }}
      >
        <div style={{ fontSize: 72, fontWeight: 700, lineClamp: 2 }}>{title}</div>
        <div style={{ fontSize: 32, color: '#93C5FD', marginTop: 24 }}>brand.com</div>
      </div>
    ),
    {
      width: 1200,
      height: 630,
      fonts: [{ name: 'Noto Sans SC', data: await fontData, weight: 400, style: 'normal' }],
    }
  )
}
缓存设计是这套方案的灵魂,分三层:
- 缓存键按 slug。路由设计成
/og/[slug]/opengraph-image(Next.js 的文件约定opengraph-image.tsx会自动生成对应 og:image 标签),每个内容页一张图,互不污染。标题变更 → slug 不变但内容变了怎么办?把标题的哈希拼进缓存键,或在内容更新时主动 purge。 - Cache-Control 写对。OG 图是内容强相关的静态资源:
public, max-age=86400, s-maxage=31536000, stale-while-revalidate=86400起步。爬虫一年抓一次都嫌多,CDN 边缘能扛住就别回源。 - 冷启动预热。边缘函数第一次渲染要加载字体、初始化 satori,是整条链路最慢的一次。发布新内容时,用构建脚本主动请求一遍新 slug 的 OG 地址(warming),让爬虫第一次来就命中热缓存。Vercel 这类平台上,构建期直接生成静态 PNG 落盘是最彻底的做法——运行时零渲染。
一个容易踩的坑:别把 OG 路由放在需要登录的路径后面。爬虫不带 cookie,鉴权中间件会把它拦在外面,表现为"调试器里能抓到图、分享出去没有图"。OG 路由和它依赖的字体文件走公开路径,单独配一条不过鉴权的规则。
6. 降级与兜底
动态链路一定会失败:字体文件损坏、标题里混进了子集之外的生僻字、边缘函数超时。兜底策略只有一条:永远有图可回,失败时回默认图,而不是 500。
export async function GET(req: Request) {
  try {
    return await renderOg(req) // 上面的 ImageResponse 逻辑
  } catch (err) {
    console.error('[og] render failed, serving fallback', err)
    // 兜底:返回预生成的默认图(构建期产物,存在 public/og-fallback.png)
    const fallback = await fetch(new URL('/og-fallback.png', req.url))
    return new Response(await fallback.arrayBuffer(), {
      headers: {
        'Content-Type': 'image/png',
        'Cache-Control': 'public, max-age=3600', // 兜底图缓存短一点,方便恢复
      },
    })
  }
}
超时预算要显式设置。satori 渲染一张 1200×630 的图通常在几百毫秒内完成,设置一个硬上限(比如 5 秒):超时直接走兜底,别让爬虫干等。注意有些平台的爬虫抓图超时比你想象的更没耐心——与其让它拿到一个半截响应,不如给它一张完整的默认图。
输入侧的兜底和安全是一件事:标题截断长度(.slice(0, 60) 不是摆设)、去掉控制字符、做 HTML 转义。2026 年 9 月的 satori 转义漏洞(第 2 节)就是动态参数未经处理直接进 SVG 的后果:升级到已修复版本 + 服务端转义,两道保险缺一不可。
7. 验证清单:各平台 unfurl 差异
图生成了,不等于各平台都认。每个平台的爬虫行为都不一样,上线前逐个验证:
- X(Twitter)。用官方的卡片验证器(Card Validator)抓一遍,确认
twitter:card为summary_large_image、图片 1200×630 能完整展示。X 对图片有单独的缓存,换了图之后用验证器重新抓取一次才能刷新——具体缓存时长以验证器实测为准,不要凭经验猜。 - 微信。微信聊天窗口的分享图来自网页的 og:image 或页面首图(JS-SDK 自定义分享另需配置)。微信的抓取对国内可访问性敏感:图片 URL 必须能在微信网络环境下打开,境外部署的图床先自测。注意微信内置浏览器的缓存很"顽固",测试时用不同链接参数区分版本。
- Slack。Slack 的 unfurl 会抓 og 标签,图片有大小限制,超大 PNG 会被拒绝展开。Slack 提供 unfurl 调试手段,图片换了之后重新 unfurl 验证。企业内网链接注意 Slack 爬虫的 IP 段要在防火墙放行。
- LinkedIn。LinkedIn 的 Post Inspector 支持按需重新抓取,是几个平台里最"好说话"的——把它当冒烟测试的第一站正合适,因为它的报错最明确。LinkedIn 能正常渲染但 X 不行,问题几乎总在 X 的图片缓存,不在你的标签。
- iMessage。苹果的抓取最"挑剔":要求 HTTPS、图片 URL 必须可直接访问且返回正确的 Content-Type,对重定向链条的容忍度低。iMessage 没有公开的调试器,只能真机实测——准备两台设备(一个发、一个收)是必要成本。
爬虫 UA 注意事项(通用):
- og:image 必须用绝对 URL(含 https 域名),相对路径在爬虫侧是未定义行为。
- 别给爬虫返回和用户不一样的 HTML(cloaking),但可以给爬虫更轻的响应:检测到爬虫 UA 时跳过重型 JS,直接返回带完整 og 标签的服务端渲染 HTML——这不算作弊,这是让爬虫干活。
- 图片响应头里
Content-Type: image/png写对,Content-Length别丢。有些爬虫遇到分块传输会直接放弃。 - 上线后第一周,每天抽几个新链接手动分享验证——各平台的抓取失败都是静默的,没人会告诉你。
8. 一人团队最小实现:10 项上线检查表
把前面 7 节压缩成一个周末能干完的清单:
- 定模板。1200×630,关键信息进中央 1000×540 安全区,深色/浅色各一套,标题写死截断策略(单行省略号 / 双行 lineClamp)。
- 选链路。默认 satori + Edge 函数;Next.js 项目直接用
next/og的ImageResponse。构建期批量生成且在意时长,再评估 Takumi。 - 锁版本。satori ≥ 0.33.5(或直接用最新 0.38.x),Next.js 用已修复转义漏洞的版本。依赖锁文件提交进仓库。
- 切字体。跑第 3 节的子集化脚本,产物(几十 KB)随代码部署。字重要覆盖模板用到的每一档,emoji 要么子集化要么换 SVG 图标。
- 写路由。
/og/[slug]/opengraph-image,字体模块级缓存,标题截断 + 转义,超时 5 秒硬上限。 - 做兜底。预生成一张默认图放
public/og-fallback.png,渲染异常/timeout 时返回它,绝不 500。 - 配缓存。
Cache-Control: public, s-maxage=31536000起步;缓存键含 slug(+标题哈希);发布新内容时主动预热。 - 放行爬虫。OG 路由和字体走公开路径,不过登录鉴权;图片用绝对 HTTPS URL;响应头 Content-Type 写对。
- 逐个平台验证。X 卡片验证器、微信真机、Slack unfurl、iMessage 真机,各抓一遍,截图存档。
- 监控。OG 路由的 5xx 率和 p95 延迟进监控;兜底图命中次数告警——兜底经常被命中说明模板或字体有系统性问题。
相关阅读:《vibe 项目的 SEO/AEO 实战手册》(OG 标签怎么写,标签侧);《分享链接实战》(消费侧需要哪些 og 标签,本轮同发)。三篇合起来,就是一条链接从"被分享"到"被点开"的完整链路:标签告诉平台"这里有张图",本篇负责把那张图造出来,分享链接那篇负责让标签指向正确的图。
一句话总结:OG 图不是设计稿,是一条渲染管线——satori 做排版、子集化解决中文、边缘缓存解决成本、兜底解决深夜。一个周末搭完,之后每条分享链接都自带一张体面的预览图。
最后补一个值得养成的习惯:上线当天把各平台渲染出的卡片逐个截图,存进仓库和模板放一起。半年后某天标题渲染异常、或某个平台悄悄改了裁剪比例,你对着已知良好的基线几秒钟就能定位,而不是把整份检查表重新学一遍。OG 图是基础设施——就按基础设施对待:有产物、有版本、有记录。
评论 (0)
相关文章
AI 生成的表格代码是按 demo 数据规模写的:全量拉取卡死页面、假分页、前端排序悄悄错位。本篇讲一张表的交互工程:offset vs cursor 分页选型、排序列白名单、筛选同步 URL、JSONB 存列偏好、跨页批量选中、虚拟滚动测试方法,以及 12 项上线验收清单。
“复制链接分享”是每个 SaaS 最便宜的获客动作,也是 AI 生成代码最容易裸奔的功能。本指南拆解三大经典翻车(可枚举 ID、无过期、撤回不干净),给完整链路:不可猜测的 token 设计与 shr_ 前缀、三档只读/评论/编辑权限模型与三张 Postgres 表、可直接运行的过期+次数统一校验中间件、撤回/轮换语义与缓存失效、防枚举三层防御、分享页消费侧需要的 og 标签。最后附一人团队周末可抄完的最小实现与 10 项上线检查表。
上架只是拿到了入场券。本篇讲透原生推送的完整实战:APNs token/证书双模式、FCM HTTP v1、Expo 捷径、设备令牌管线、iOS 权限话术、四种推送形态、服务端发送、到达率与合规,附 12 项上线检查表。