DeepSeek 发布 V4.1-Flash-1017:“许愿式编程”的性价比之王,API 新增 Search 与 Fetch 联网能力
10 月 17 日,DeepSeek 发布 V4.1-Flash-1017:11 项基准较 9 月版全部提升,权重以 MIT 许可开源,API 名称与价格不变;自研搜索引擎同步开放为 Search 与 Fetch 两个公开 API,每千次成功请求 0.75 美元。本文拆解跑分细节、计费与限流规则,以及“官方联网检索”做成 API 基础设施对 vibe coder 意味着什么。
10 月 17 日,DeepSeek 一天之内连放三枪:V4.1-Flash 升级为 V4.1-Flash-1017(网页、App、API 三端同步,价格纹丝不动)、MIT 权重上架 Hugging Face 和 ModelScope,以及——对开发者来说可能分量最重的一件——把自家搜索引擎打包成 Search 和 Fetch 两个 API,正式向所有开发者开放。这不是一次常规的小版本更新,它是 DeepSeek 第一次把"模型 + 联网检索"做成一整套官方基础设施。想清楚这件事的分量,再决定你要不要跟。
一、到底发生了什么:三件事,一天之内
先把事实摆齐。DeepSeek-V4.1-Flash-1017 是 9 月 10 日发布的 V4.1-Flash 的小版本更新,命名沿用 DeepSeek 的日期快照惯例——1017 就是 10 月 17 日,上一个世代叫 V4-Flash-0731。官方的口径很克制:模型卡第一句就写明这是"minor update",但给出的 11 项基准对照显示,新版在推理、编程、agent 和视觉基准上全面超过了 9 月版,同时任务执行更快、输出更短。官方把这叫作"性能与成本的帕累托改进"。
对现有用户最省事的一点:API 调用方式和价格完全不变。你一直用的 deepseek-flash 这个名字,底层已经自动换成了 1017;连已经退役的老名字 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 都还能调,只是改由新版响应、按 Flash 价格计费。换句话说,这是 DeepSeek 第二次玩"接口不动、底层换新"——上个月发布 V4.1-Flash 时就是这么干的。用户零迁移成本,这是它敢高频迭代的底气。
权重侧同步开源:完整权重以 MIT 许可放上 Hugging Face 和 ModelScope。注意这次没有附带新的技术报告——1017 的模型卡保留了定位说明、基准表和推理指引,技术报告直接沿用前一版。想自己部署的人注意:权重是 FP8/INT8 打包的大文件,硬件需求要按精度和内存自己评估,社区项目已经在跟进适配。
二、跑分:11 项全升,涨得最多的全是编程活
先看数字,再谈看法。模型卡给出的新旧对照里,涨幅最大的三项分别是:
- Terminal-Bench 4.0:31.2 涨到 42.3(+11.1)。这是用 Claude Code 框架测的终端 agent 任务,一口气涨了 11 个点,超过了同表里的 GPT-5.6 Sol(39.9),但仍低于 Opus 5(51.8)。
- DeepSWE v1.1:74.2 涨到 77.0(+2.8)。用 Mini-SWE-V2 框架测的软件工程 agent 任务。新版 77.0 高于同表里 Opus 5 的 74.0 和 GPT-5.6 Sol 的 73.0——至少在 DeepSeek 自己这张表里,它把两家都超了。
- NL2Repo-Bench:上一版 65.4 涨到 68.2(+2.8)。自然语言需求生成完整仓库的任务,这正是 vibe coding 最核心的场景。

剩下的 8 项也全部上涨:ProgramBench 20.3 到 29.1(+8.8)、Apex Bench v1.1 64.6 到 72.1(+7.5)、不带工具的 HLE 36.8 到 42.6(+5.8)、Automation-Bench v1.0.6 54.8 到 60.5(+5.7)、Agents' Last Exam 31.8 到 35.4(+3.6)、Chartography(带工具)78.9 到 83.0、BabyVision(带工具)89.6 到 92.5、ZeroBench-main(带工具)49.0 到 51.0。涨幅在 2.0 到 11.1 个百分点之间,没有一项倒退。
两点冷静的提醒。第一,所有分数都是 DeepSeek 自报,第三方独立评测还没出来——多家转述的媒体都加了这句,我也照原样转达。第二,模型卡里对比的对手版本(K3、GLM-5.3、GPT-5.6 Sol、Opus 5)是官方选的,表格天然对发布方有利。我的建议在文末:拿你自己的任务集跑一轮,比看任何表格都管用。
但有一条信息是扎实的:涨幅最大的几项(Terminal-Bench、ProgramBench、DeepSWE、NL2Repo)清一色是 agent 编程任务。DeepSeek 这次的优化方向非常明确——不是通用聊天,而是"让模型在工具里干活"。这和下一节的"许愿式编程"是一回事。
三、"许愿式编程":1017 真正想卖的东西
官方这次给 1017 讲了一个很具体的故事:用带自我反馈的强化学习,训练模型端到端地从零开发完整项目。据官方公告(多家媒体转引),演示包括用 Godot 引擎复刻《传送门 2》、一个网页赛车游戏,以及故宫 3D 建模。演示归演示,但方向值得注意——DeepSeek 明确说新版针对自家 DeepSeek Harness(建议升级到 v0.2.1-rc.1 以上)、腾讯的 CodeBuddy 和 WorkBuddy 做了优化。
翻译一下:1017 的目标用户不是"在网页对话框里聊天的人",而是"把模型嵌进编程工具里的人"。模型卡里那句"任务执行更快、输出更短"也是这个逻辑的另一面——agent 跑任务时,输出 token 直接等于钱和时间。输出更短,意味着同样一个任务花的 token 更少、跑得更快。官方说这是"性能-成本帕累托改进",话术背后是实打实的工程取向:这一代优化的不是"答得好不好",而是"干活划不划算"。
技术细节上还有几处值得开发者注意。上下文 1M token,官方推荐 temperature 1.0、top_p 1.0、max_tokens 不低于 256K——temperature 给 1.0 说明官方对自己的输出稳定性有信心,也暗示 agent 场景下他们希望你保留采样的多样性。比较特殊的是,这一版不附带 Jinja 格式的聊天模板。官方的替代方案是两件套:模型仓库里 encoding 文件夹的自研 Python 参考实现(encoding.py,带多轮对话、工具调用、thinking 模式、数值推理强度、对话中途系统消息、图文交错等测试用例),以及新发布的 deepseek-recipe——一套 Rust 库加 Python 绑定,把 Messages、Chat Completions、Responses 三种 API 请求转成统一的 Conversation 格式,再编码成 V4/V4.1 的提示或 token ID,最后把模型输出解析回完整或流式响应。模型推理、工具执行和 HTTP 传输留给调用方自己处理。本地部署的人要留意:提示词拼装这块得按官方这套来,别再套旧模板。
四、真正的大新闻:Search 和 Fetch API 正式开放
模型更新之外,10 月 17 日同一天,DeepSeek 把自家搜索引擎做成了两个公开 API。这是国产 coding 模型第一次把"官方联网检索"做成 API 基础设施,值得单独拆开讲。
Search API(POST https://api.deepseek.com/v1/tools/search):按查询返回结构化网页结果,背后是 DeepSeek 自研搜索引擎。请求字段很克制:query(必填,1 到 128 个字符)、count(默认 10,最多 50)、ori_question(触发搜索的用户原始问题,1 到 128 字符,用来帮助理解查询意图)、localization(一个 IP 地址,用来本地化结果)、need_content(是否连页面正文一起返回,默认 false)。查询语法直接透传,支持 site:、-site:、减号排除、引号精确匹配、lang:、after:、before: 一整套算子——比如"DeepSeek site:github.com OR site:huggingface.co lang:en after:2025"这种组合是官方文档里的现成例子。
返回的每个结果带 9 个字段,其中三个最有信息量:rerank_score(0 到 3 的相关性分,综合相关性、权威性和新鲜度,1.5 以上算高质量)、summary(600 到 800 字符的长摘要,文档里明确写着"intended to be read by a model",就是给模型读的)、authority(0 到 4 的权威度分级,3 以上是高权威来源)。另外 snippet 是 100 到 200 字符的短摘要,给 UI 展示用;content 只有 need_content=true 时才有内容。字段设计能看出来:这套 API 从一开始就是为 agent 和 RAG 流水线设计的,不是给人肉浏览用的。
Fetch API(POST https://api.deepseek.com/v1/tools/fetch):更简单,传一个 URL,返回页面的标题和 Markdown 正文。抓取受目标站点的可用性和访问策略限制,抓不到会返回 404 类错误。
计费方式很有 DeepSeek 风格:按成功请求计费,不按 token、不按返回条数。Search 和 Fetch 各自每 1000 次成功请求 0.75 美元;"成功"的定义很严——HTTP 200 且有实际结果(Search 必须返回非空 results 数组,Fetch 必须拿到页面内容)。失败的请求、空结果、超时一律不收费。count 只控制返回几条,不影响单价。限流是账户级的,Search 和 Fetch 各自独立 QPS 5,Fetch 还有额外的按域名 QPS 限流,超了返回 429。
还有一个时间窗口:如果你经 DeepSeek Harness、Claude Code 或 Codex 使用 DeepSeek API,服务端工具发起的 Search/Fetch 调用目前免费,北京时间 2026 年 11 月 1 日 0 点起开始计费。也就是说还有两周的免费测试期——后面会讲怎么用。
五、为什么这事对 vibe coder 特别重要
先说结论:以前 agent 联网这"最后一公里",要么接第三方搜索 API(贵、配额紧、结果质量参差),要么自己写爬虫(反爬、解析、维护全是坑)。DeepSeek 这次等于把自研搜索引擎——官方说法是每天处理全球数亿次请求、索引数千亿网页,还会过滤 SEO 垃圾和低质 AI 生成内容——直接塞进了自家 API,而且按成功计费、失败不收钱。对做 RAG 和 agent 的人来说,"联网检索"第一次有了来自模型厂商官方的、便宜的、一站式的方案。
更关键的是组合拳。1017 本身是 agent 编程取向的模型(输出更短、任务更快、针对 Harness 和 CodeBuddy 优化),MIT 权重允许私有化部署,OpenRouter 等渠道覆盖云端调用,现在再加上官方的 Search/Fetch——私有化、云端、联网三条路全通了。一个 vibe coder 可以这样搭:本地或云端跑 1017 做代码生成,遇到需要查最新文档、API 变更、报错信息时,直接调官方 Search/Fetch 拿结构化结果喂回模型,中间不需要再维护一套搜索基础设施。rerank_score 和 authority 字段甚至帮你把"结果可不可信"这层判断也做了。
横向对比一下格局。OpenAI 和 Anthropic 的联网能力基本锁在自家产品和 agent 框架里,对外没有单独把"搜索引擎"拆成按次计费的公开 API;第三方搜索 API 是独立生意,和模型是两家供应商,出了问题你得两头排查。DeepSeek 这次把"模型 + 搜索"做成同一家、同一个 key、同一份账单,排查链路短了一大截。这就是我说的"API 基础设施"——它卖的不是一个功能,而是一种新的默认配置:以后做 coding agent,联网检索不再是一个需要单独选型的外部依赖。
当然也要看到边界。QPS 5 的账户级限流意味着高并发场景下它撑不起大流量;Fetch 的按域名限流对"批量抓某个站"这类用法是硬约束;summary 和 rerank 毕竟是 DeepSeek 自家的排序,权威度分级和你自己的判断标准未必一致——关键决策还是要让模型交叉验证,或者至少把 authority 小于 3 的结果降权处理。这些都是工程上要自己兜底的地方,官方文档把错误码和重试建议写得很清楚,照着做就行。
六、上手建议:免费窗口到 11 月 1 日,先测再换
给想跟进的 vibe coder 几条实操建议:
第一,把这两周免费期用满。在 DeepSeek Harness、Claude Code 或 Codex 里走 DeepSeek API,服务端工具的 Search/Fetch 调用到北京时间 11 月 1 日 0 点之前都不收费。这正是测"联网检索这一环"的效果和延迟的最好时机:建一个固定的测试任务集(比如 20 个需要查最新文档的编程任务),记录通过率、每任务耗时、每任务的搜索调用次数,11 月 1 日之后按每千次 0.75 美元把账算进去,再决定要不要长期用。
第二,换默认模型之前,先跑自己的任务集。官方表格再好看也是官方自报。1017 的 API 名字和价格都没变,切换成本为零——但"零成本切换"不等于"零风险切换"。拿你自己的代表性任务(尤其是带工具调用的 agent 任务)跑新旧两版,对比通过率和每任务 token 消耗,数据OK再换默认。特别注意 temperature 1.0 是官方推荐值,别沿用你原来低温的习惯直接套。
第三,Search 的查询算子值得花半小时熟悉。site: 限定域名、lang: 限定语言、after:/before: 限定时间,这三个组合起来,基本能解决"搜最新英文官方文档"这个最高频需求。ori_question 字段别空着——把用户的原始问题传进去,官方说能改善查询理解,实测一下就知道值不值。need_content 默认 false,需要正文时再开,省得每次都拉一堆用不上的文本。
第四,本地部署的人先看 encoding 和 deepseek-recipe。没有 Jinja 模板意味着你不能再套用旧的拼装逻辑,官方的 encoding.py 参考实现和 Rust 工具库是唯一正统路径。先用参考实现跑通,再考虑上 deepseek-recipe 做生产化。
七、来源、口径与一句提醒
本文的事实部分来自三处一手来源:Hugging Face 上的 DeepSeek-V4.1-Flash-1017 模型卡(基准表、采样参数、encoding 与 deepseek-recipe 说明、MIT 许可)、DeepSeek 官方 API 文档的 Search & Fetch 指南(端点、字段、算子、计费、限流全文),以及 10 月 17 日的媒体报道(ABMedia 等多家一致转引官方公告,用于确认发布日期与演示案例)。需要诚实说明的是:官方微信公众号的原文因反爬限制未能直接阅读,发布日期 10 月 17 日以多家媒体一致转引为准。
最后重复一遍最重要的提醒:所有跑分都是 DeepSeek 官方自报,第三方独立验证还没出现。模型卡的对比表是发布方自己选的对手、自己跑的分。1017 的方向是对的(agent 编程 + 官方联网 + 按成功计费),免费窗口也实在,但"换默认模型"这个决定,请用你自己的任务集投票。两周时间,够跑一轮了。
评论 (0)
原始来源
相关文章
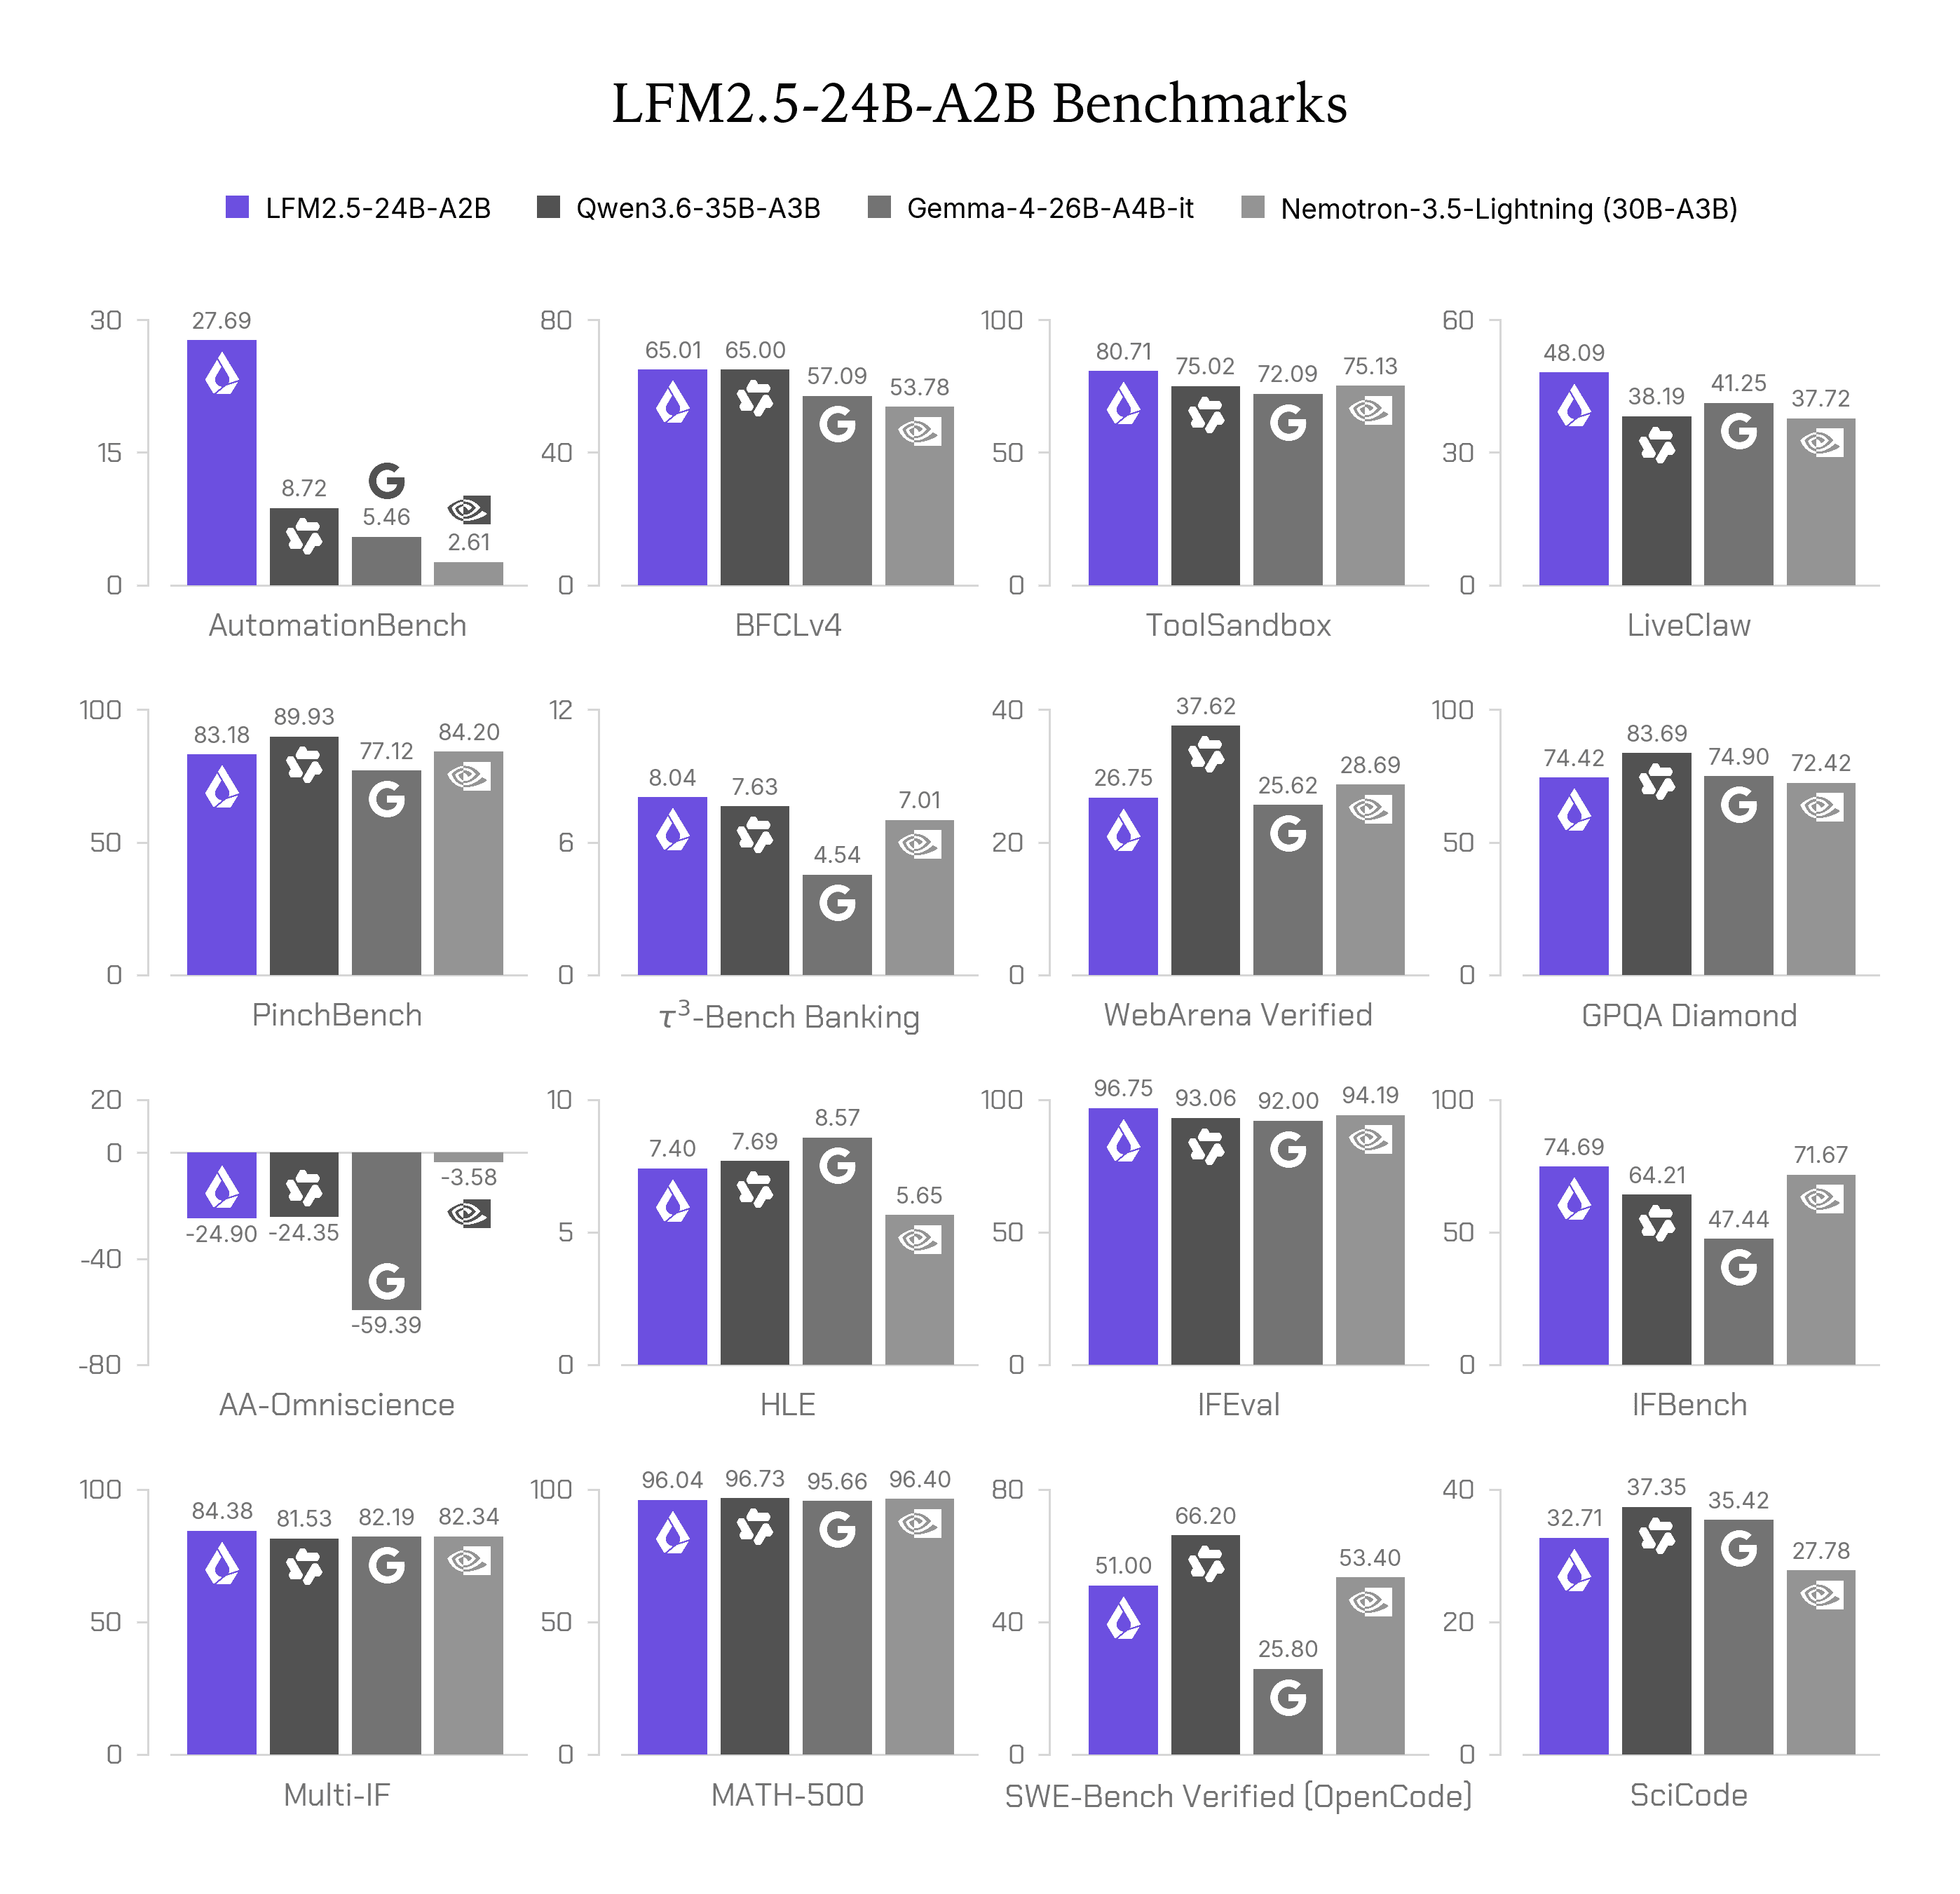
10 月 13 日,Liquid AI 发布 LFM2.5-24B-A2B:24B 总参数、每 token 仅激活约 2B 的开源权重 MoE,为本地 agent 而生。这次真正的看点是训练方法论——把 OpenCode、Pi、OpenClaw、Hermes Agent 等真实 agent harness 做进 RL。本文拆解五阶段后训练、16 项厂商自测基准(工具调用与指令遵循强、知识与重编码弱),以及它到底适合谁。
Anthropic Frontier Red Team(10-12)把 26B 模型跑在 15 台 55 美元电视盒子上(0.39 tokens/s),预测小模型年底达到 GLM-5.2 的复制水平。本文分清"测出来的"与"预测的",拆解 ECI 算法、上界 caveat,以及它对 agent 沙箱的意义,并与真实的 CyberXero 攻击事件对照。
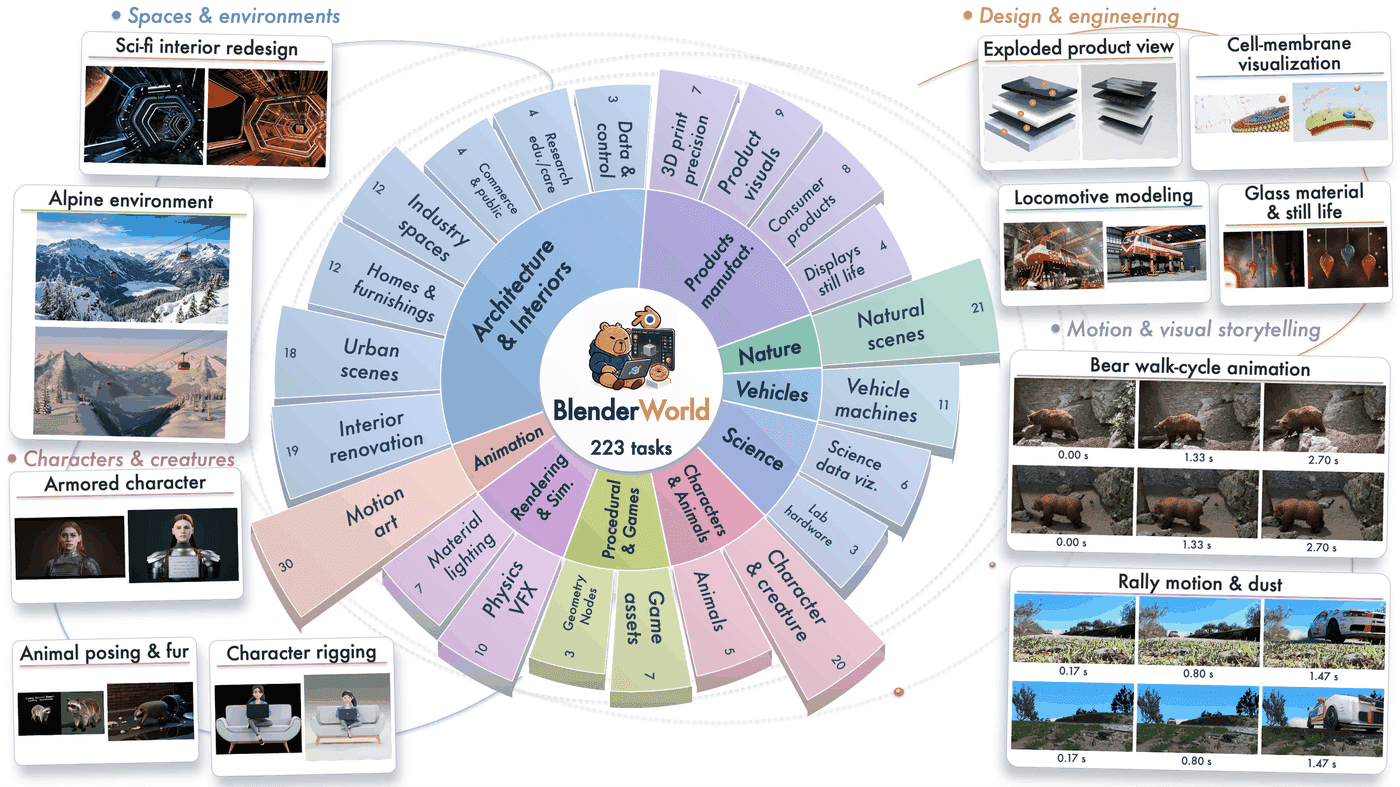
10 月 14 日,阿里 Qwen 团队开源 BlenderWorld:一套考视觉智能体在 Blender 里做真实 3D 创作的基准,223 个任务、2651 条评分标准,交卷交的是可编辑的 .blend 工程文件而非渲染图。本文拆解它的考法、判分流水线与评测风向意义。