阿里 Qwen 开源 BlenderWorld:给视觉智能体出了一套 3D 建模大考,223 道题 + 2651 条标准
10 月 14 日,阿里 Qwen 团队开源 BlenderWorld:一套考视觉智能体在 Blender 里做真实 3D 创作的基准,223 个任务、2651 条评分标准,交卷交的是可编辑的 .blend 工程文件而非渲染图。本文拆解它的考法、判分流水线与评测风向意义。
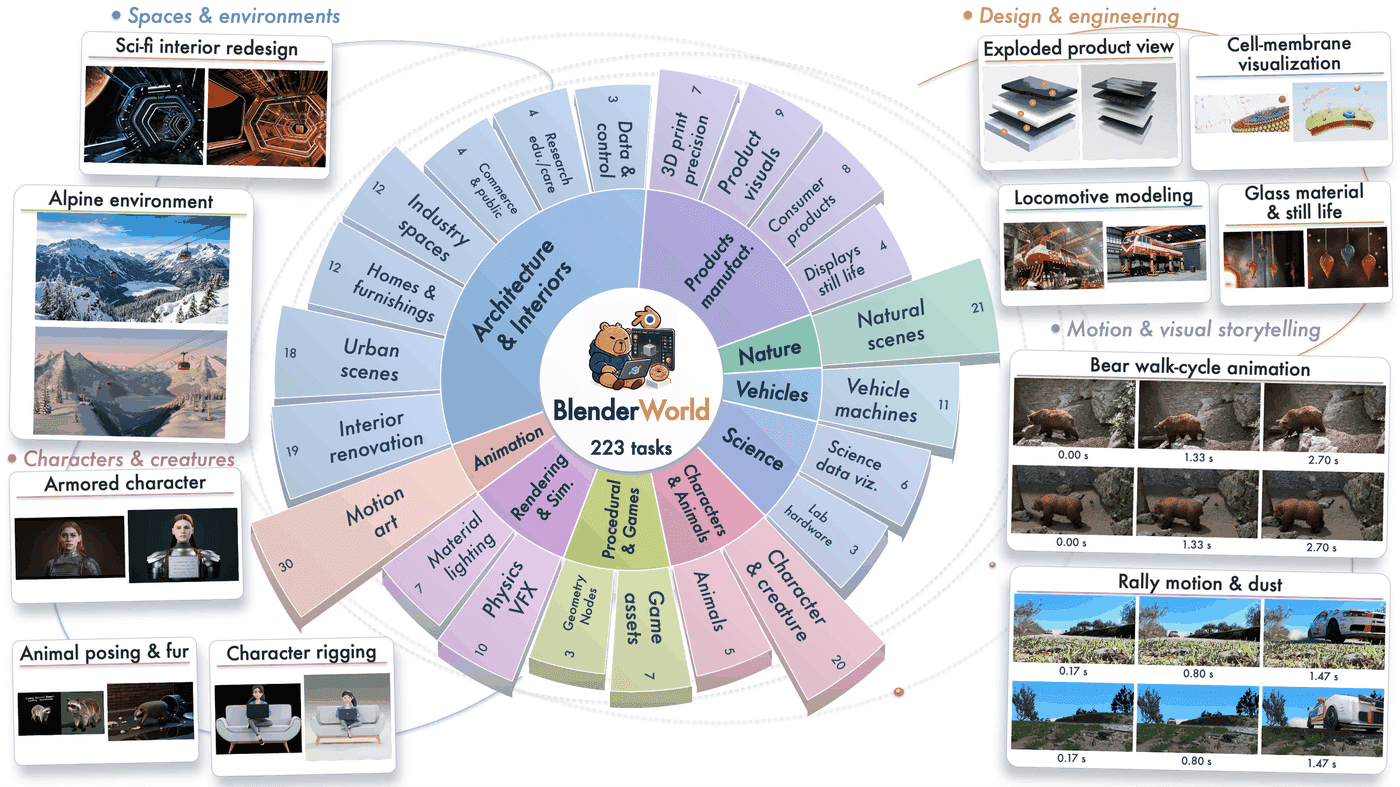
10 月 14 日,阿里 Qwen 团队在 GitHub 上开源了 BlenderWorld,全称 "Benchmarking Visual Agents for 3D Creation from Real-World References",MIT 协议。直译过来就是:给视觉智能体出的 3D 创作基准测试。注意它的措辞——不是"图像理解",不是"文生 3D",而是 from real-world references 的 3D creation:给 agent 一段来自真实世界的参考(一句文字描述、一组图文、一小段视频),让它在 Blender 里亲手把场景建出来。交卷时交的不是一张渲染图,而是一份能打开、能改、能继续生产的 .blend 工程文件。
这套题的体量是 223 个任务(编号 bw_0001 到 bw_0223),配套 2651 条二元评分标准。输入分三种模态:纯文字描述 78 个、图文混合 130 个、视频加文字 15 个。其中 59 个任务还附带规格文件——Markdown、YAML、JSON 里写着尺寸、材质、相机参数,相当于甲方甩过来的 production brief,agent 得照着规格书干活,而不是自由发挥。应用场景覆盖了分镜脚本、产品发布、游戏资产、电商视觉、房地产营销、科研插画、装修方案、课堂教学、安全培训、展览策划、建筑报告等十余个方向,基本都是"有人愿意为此付钱"的真实生产场景。
交卷标准:可编辑的 .blend,而非一张生图
这是 BlenderWorld 和绝大多数视觉评测最根本的区别。以往测视觉模型,考的是看图问答、看图描述;测生成模型,考的是提示词到图片的质量。但 BlenderWorld 考的是 agent 能不能在真实生产软件里交付:打开 Blender,建模、布光、调材质、摆相机,最后交出 .blend 工程文件,并按需附带渲染图、视频或模型导出。
这个设计卡住了一个真实痛点:今天的生成式 AI 能出图,但出不了"能进生产流程的东西"。一张 4K 渲染图再漂亮,3D 美术也拿它没办法——拓扑是死的,材质是假的,灯光不可调,改一个字都得重画。而 .blend 文件是活的:网格、修改器、材质节点、灯光 rig 全都在,接手的美术可以直接改、可以继续往下做。BlenderWorld 把"可编辑"写进交卷要求,等于把评测的终点从"看起来对"推到了"能用"。这一步很关键,因为"看起来对"正是生成式模型最擅长作弊的地方。
交付物的定义也很讲究:核心是 .blend 工程文件,渲染图、视频、模型导出是"按需附带"。也就是说,渲染图只是佐证,工程文件才是本体。这个主次关系一旦确立,很多投机取巧的路就被堵死了——你没法靠一张精修过的渲染图蒙混过关,因为判分的第一路(Agent-as-Judge)是直接打开你的 .blend 场景做检查的,布线、层级、参数一个都藏不住。
怎么考:一条 bw 命令走完备考到判分
官方提供了一套 bw 命令行工具链,把参赛到评测的全流程包了起来:bw download 拉数据集,bw verify 做校验,bw list 查任务,bw prepare 准备环境,bw pack-submission 打包提交,bw evaluate 跑评测。整个链路可复现——这对 benchmark 不是加分项,是生命线:跑分环境、渲染参数、判分模型但凡有一处对不上,"谁的分更高"就没法对账。
评测流水线的设计相当"不客气"。对提交的 .blend 场景,系统会做 8 个自适应视角的渲染,渲染器用 Cycles,1024×1024 分辨率、64 采样,每个视角最多允许 2 次纠正性重渲染。判分分三路走:Agent-as-Judge 直接检查 Blender 场景本身(物体在不在、层级对不对、参数合不合规格);VLM 对照 2651 条二元标准逐条打视觉分;再加上 8 项整体视觉质量评分。最终得分是 0.5×规则分 + 0.5×维度分——规则和整体观感各占一半,既不让"堆细节但整体崩了"的混过去,也不让"整体顺眼但规格全错"的拿高分。
权重设计里藏着出题人的态度:每条标准的权重分 1、2、3 三档,其中权重 3 的标准占了全部 2651 条里的 83.3%,权重 2 占 14.9%,权重 1 只有 1.8%。翻译一下:核心的硬性要求没做到,分数会掉得很惨;边角料的加分项再多也救不回来。这种"抓大放小"的判分,恰恰是生产场景里的真实逻辑——甲方不会因为你灯光调得有氛围感,就原谅你把产品尺寸做错了。
还有一个值得玩味的细节:论文里三路判分(场景检查、视觉标准、质量评分)用的都是 GPT-5.6-terra 担任评委。这意味着跑一轮完整评测的成本不低,复现别人的分数也需要同样的评委模型。这是目前 agent-as-judge 类评测的通病,BlenderWorld 也没能例外——判分越"智能",可复现性就越贵。
2651 条标准长什么样
官方给出的数据集统计图把这套题的结构摊得很明白,值得细看:

左图是 11 大应用场景的任务分布:分镜脚本 35 个最多,其次是产品发布和游戏资产各 21 个,电商视觉 20 个,房地产营销 19 个,科研插画和装修方案各 18 个,课堂教学 16 个,安全培训、展览策划、建筑报告各 15 个。分镜和产品视觉占大头不意外——这是"参考图转 3D 场景"需求最旺盛、也最容易标准化的两个行当。
中图是参考与附件的类型:图片参考 130 个(占 58.3%)、视频参考 15 个(6.7%),规格文件则是 Markdown 28、YAML 20、JSON 11,加起来正好是 59 个带规格书的任务。注意这个比例:超过一半的任务是"图文混合"输入——纯文字太发散,纯图片又缺约束,图文结合才是真实 brief 的常态。
右图是评分标准的维度与权重:2651 条标准里,Function(功能正确性)660 条、Geometry(几何)446 条、Composition(构图)310 条、Material(材质)291 条、Lighting(灯光)203 条,往下还有空间布局、整体观、物理、比例、存在性、数量、颜色等维度。功能和几何两项加起来超过 1100 条,占了四成以上——出题人用数字表明了立场:先做对,再做好看。
考试环境:Blender 4.2.10,官方连 coding-agent 镜像都配好了
生成环境锁定在 Blender 4.2.10。官方还捆绑了一个开箱即用的 coding-agent 环境:Codex CLI 0.147.0、Claude Code 2.1.220、Node.js 22.17.0,可以通过 MCP 工具直接驱动 Blender。这意味着参赛的 agent 不需要自己琢磨"怎么让 LLM 操作 Blender"——官方把"手"(MCP 工具)和"脑"(coding agent)之间的连线已经接好了,参赛者专注的是"怎么做对题"。
另外,评测还支持可选的 Harbor 集成。数据集、代码、评测工具三件套同步发布在 GitHub、Hugging Face、ModelScope 三个平台,国内开发者从 ModelScope 拉数据会顺畅得多。MIT 协议意味着商用友好,拿去魔改、拿去做内部评测都没门槛。
观点:评测的风向变了,从"聊天打分"转向"交生产文件"
BlenderWorld 最值得关注的不是 223 这个数字,而是它代表的评测范式迁移。过去两年,agent 评测的主流是"聊天问答打分":给模型一段对话、几张图,看它答得对不对、说得好不好。但 SWE-bench 之后,代码 agent 的评测已经转向了真实任务——能不能真的修掉那个 bug、能不能真的让测试变绿。BlenderWorld 把同样的逻辑搬到了视觉创作:别告诉我你"理解"了参考图,把 .blend 交出来,打开能改、渲染能看、规格对得上,才算数。
对 vibe coder 来说,这套题的直接价值是"怎么判断一个视觉 agent 真能干活"的参考坐标。现在市面上的视觉 agent、3D 生成工具,demo 一个比一个好看,但"好看"和"能干活"之间隔着一条生产流程的鸿沟。BlenderWorld 的 2651 条标准,本质上是一份"3D 生产交付 checklist"的量化版——以后再有人跟你说"我们的 agent 能做 3D",你可以问的第一个问题就是:它能在 BlenderWorld 上交出可编辑的 .blend 吗?能拿几分?
还有一层意义是"谁在出题"。过去 agent 评测的基础设施基本是欧美团队在搭:SWE-bench、WebArena、OSWorld,清一色的英文语境。BlenderWorld 是国产团队(Qwen)在评测基础设施上的一次正式出题,而且出的是一道"动手题"不是"选择题"。评测标准就是话语权——谁定义"什么是好的视觉 agent",谁就定义了这个赛道的优化方向。Qwen 这次把定义权写进了 2651 条二元标准里。
当然也要泼一瓢冷水:这套题的门槛不低。8 视角 Cycles 渲染加三路 VLM 判分,跑一轮的算力成本和时间成本都摆在那里;评委模型 GPT-5.6-terra 的选择也意味着分数的可复现性和"换评委是否还稳定"都有待验证。但这不妨碍它的方向是对的——评测就应该比被测的东西更难、更贵、更较真,否则它就没有存在的意义。
一句话总结:当 AI 评测开始要求"交出能在生产软件里打开的文件",说明这个行业对 agent 的期待,已经从"说得像回事"变成了"干得出活"。BlenderWorld 是视觉 agent 的第一场"实操考试",考题已经公开,MIT 协议,欢迎来战。
评论 (0)
原始来源
相关文章
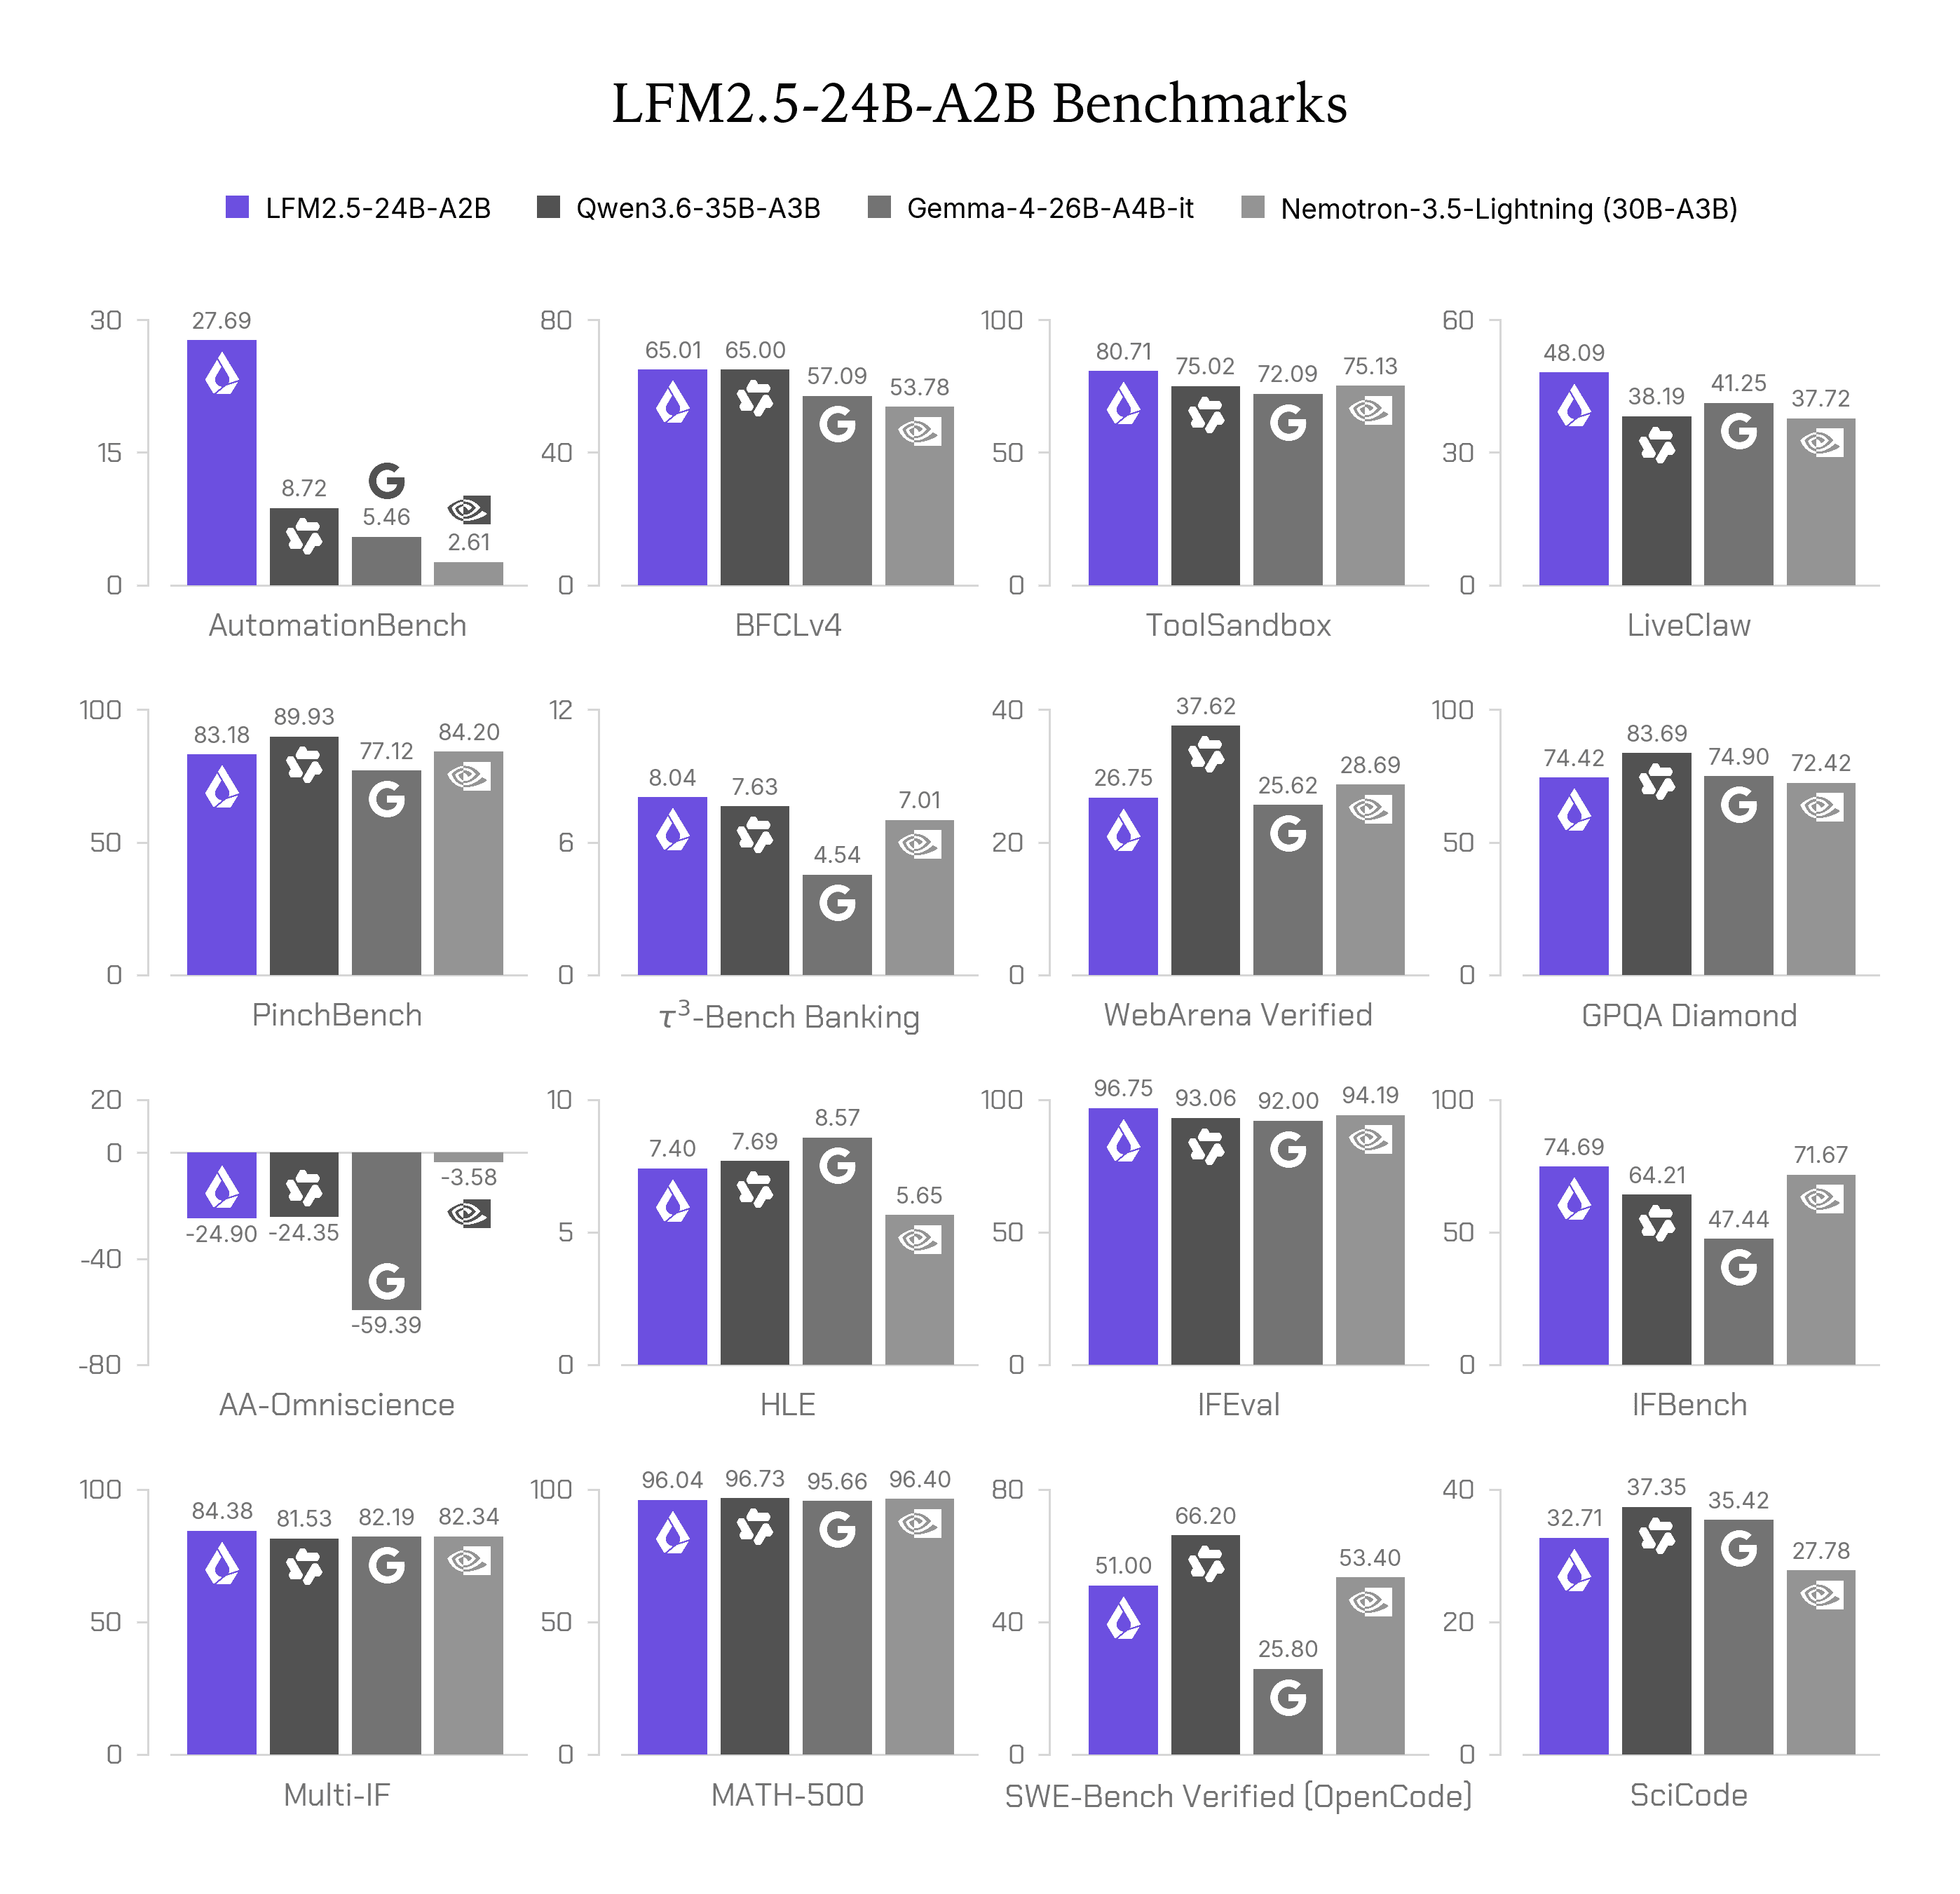
10 月 13 日,Liquid AI 发布 LFM2.5-24B-A2B:24B 总参数、每 token 仅激活约 2B 的开源权重 MoE,为本地 agent 而生。这次真正的看点是训练方法论——把 OpenCode、Pi、OpenClaw、Hermes Agent 等真实 agent harness 做进 RL。本文拆解五阶段后训练、16 项厂商自测基准(工具调用与指令遵循强、知识与重编码弱),以及它到底适合谁。
10 月 17 日,DeepSeek 发布 V4.1-Flash-1017:11 项基准较 9 月版全部提升,权重以 MIT 许可开源,API 名称与价格不变;自研搜索引擎同步开放为 Search 与 Fetch 两个公开 API,每千次成功请求 0.75 美元。本文拆解跑分细节、计费与限流规则,以及“官方联网检索”做成 API 基础设施对 vibe coder 意味着什么。
Anthropic Frontier Red Team(10-12)把 26B 模型跑在 15 台 55 美元电视盒子上(0.39 tokens/s),预测小模型年底达到 GLM-5.2 的复制水平。本文分清"测出来的"与"预测的",拆解 ECI 算法、上界 caveat,以及它对 agent 沙箱的意义,并与真实的 CyberXero 攻击事件对照。