Liquid AI 发布 LFM2.5-24B-A2B:24B 参数、每 token 只激活 2B 的本地 agent 开源模型
10 月 13 日,Liquid AI 发布 LFM2.5-24B-A2B:24B 总参数、每 token 仅激活约 2B 的开源权重 MoE,为本地 agent 而生。这次真正的看点是训练方法论——把 OpenCode、Pi、OpenClaw、Hermes Agent 等真实 agent harness 做进 RL。本文拆解五阶段后训练、16 项厂商自测基准(工具调用与指令遵循强、知识与重编码弱),以及它到底适合谁。
10 月 13 日,Liquid AI 在 Hugging Face 官方博客上发布了 LFM2.5-24B-A2B:一个 24B 总参数、每个 token 只激活约 2B 参数的混合专家(MoE)模型,Base 与后训练版本双双开源权重,定位是"给本地 agent 用的推理模型"。发布 5 天内,这个模型的讨论集中在一个点上:它不是在卷参数,而是在卷"小模型能不能真的把工具用好"。
先说我的判断。过去一年,本地 agent 的瓶颈从来不是"能不能跑起来"——llama.cpp、MLX、Ollama 早把运行门槛压到了一台笔记本上。真正的瓶颈是:当你把一个 20B 级别的小模型接到 OpenClaw、OpenCode 这类 agent 框架上,它往往连工具调用的格式都调不稳,多步任务走到一半就散架。LFM2.5-24B-A2B 这次真正的看点不是"24B 参数"这个数字,而是它的训练方法论:Liquid AI 把 Pi、OpenCode、OpenClaw、Hermes Agent 这些 vibe coder 每天真实在用的 agent harness,直接做进了最后的强化学习阶段。换句话说,这个模型不是在聊天评测上刷分刷出来的,它是在真实 agent 工作流里被"调教"出来的。
一句话速览:它到底是什么
LFM2.5-24B-A2B 延续了上一代 LFM2-24B-A2B 的架构:40 层 Transformer,每层 MoE 块有 64 个专家、top-4 路由,每个 token 只激活约 2B 参数;架构上是门控短卷积(gated short convolutions)与分组查询注意力(GQA)的混合体。相比前代,有三处硬升级:上下文窗口从 32K 扩展到 131K,词表通过原位分词器扩展(in-place tokenizer expansion)从 65K 翻倍到 128K(对非拉丁语系的 token 化更友好),以及它变成了一个纯推理模型——每一轮都会先输出显式的 chain-of-thought,再给出最终答案。
预训练规模从约 17T token 拉到约 33T token;中期训练再加了 2T token 的 32K 上下文数据(偏重推理、数学、代码、指令遵循和多语言文本),以及 300B token 的 131K 上下文数据(偏重长上下文)。工具调用和多轮轨迹数据贯穿这两个阶段——这为后面的 agent 训练打了底。
真正的看点:五阶段后训练,最后一步在真实 agent 里做 RL
后训练把 base 模型变成 agent,分了五个阶段走:
1. 监督微调(SFT);2. 教师专业化(teacher specialization);3. 多领域 on-policy 蒸馏(MOPD),先在非 agent 任务上蒸馏专业教师模型;4. 第二轮 MOPD,这次聚焦 agent 任务;5. Agentic RL:在真实 agent harness 里做强化学习——官方点名的环境包括 OpenClaw、Hermes Agent、Pi 和 OpenCode。
前四步是常规操作,第五步才是这次发布值得单独写一段的原因。大多数模型的 RL 阶段是在"评测任务"上做的:给模型一道题,看答案对不对,给 reward。而 Liquid AI 的做法是把模型直接放进 agent 框架里跑:让它去调用工具、走多步任务、在真实的 harness 反馈下学习。这两者训练出来的能力是完全不同的:前者擅长"答对题",后者擅长"把事办成"——而这恰恰是本地 agent 场景里小模型最缺的一课。
为什么这么说?因为 agent 能力的衰减曲线在小模型上特别陡。一个 70B 级别的模型,工具调用格式偶尔错一次,靠强推理能力还能自己纠回来;一个 20B 级别的小模型,第一次调错工具格式,后面的多步计划就全塌了。所以对小模型来说,"会用工具"不是锦上添花,是生死线。Liquid AI 显然想明白了这一点:与其在通用聊天评测上跟大模型硬碰硬,不如把训练预算花在让小模型"在真实工作流里不出错"上。这个思路,比参数数字本身更值得行业抄作业。
基准:agent 和指令遵循是强项,但先看清三件事
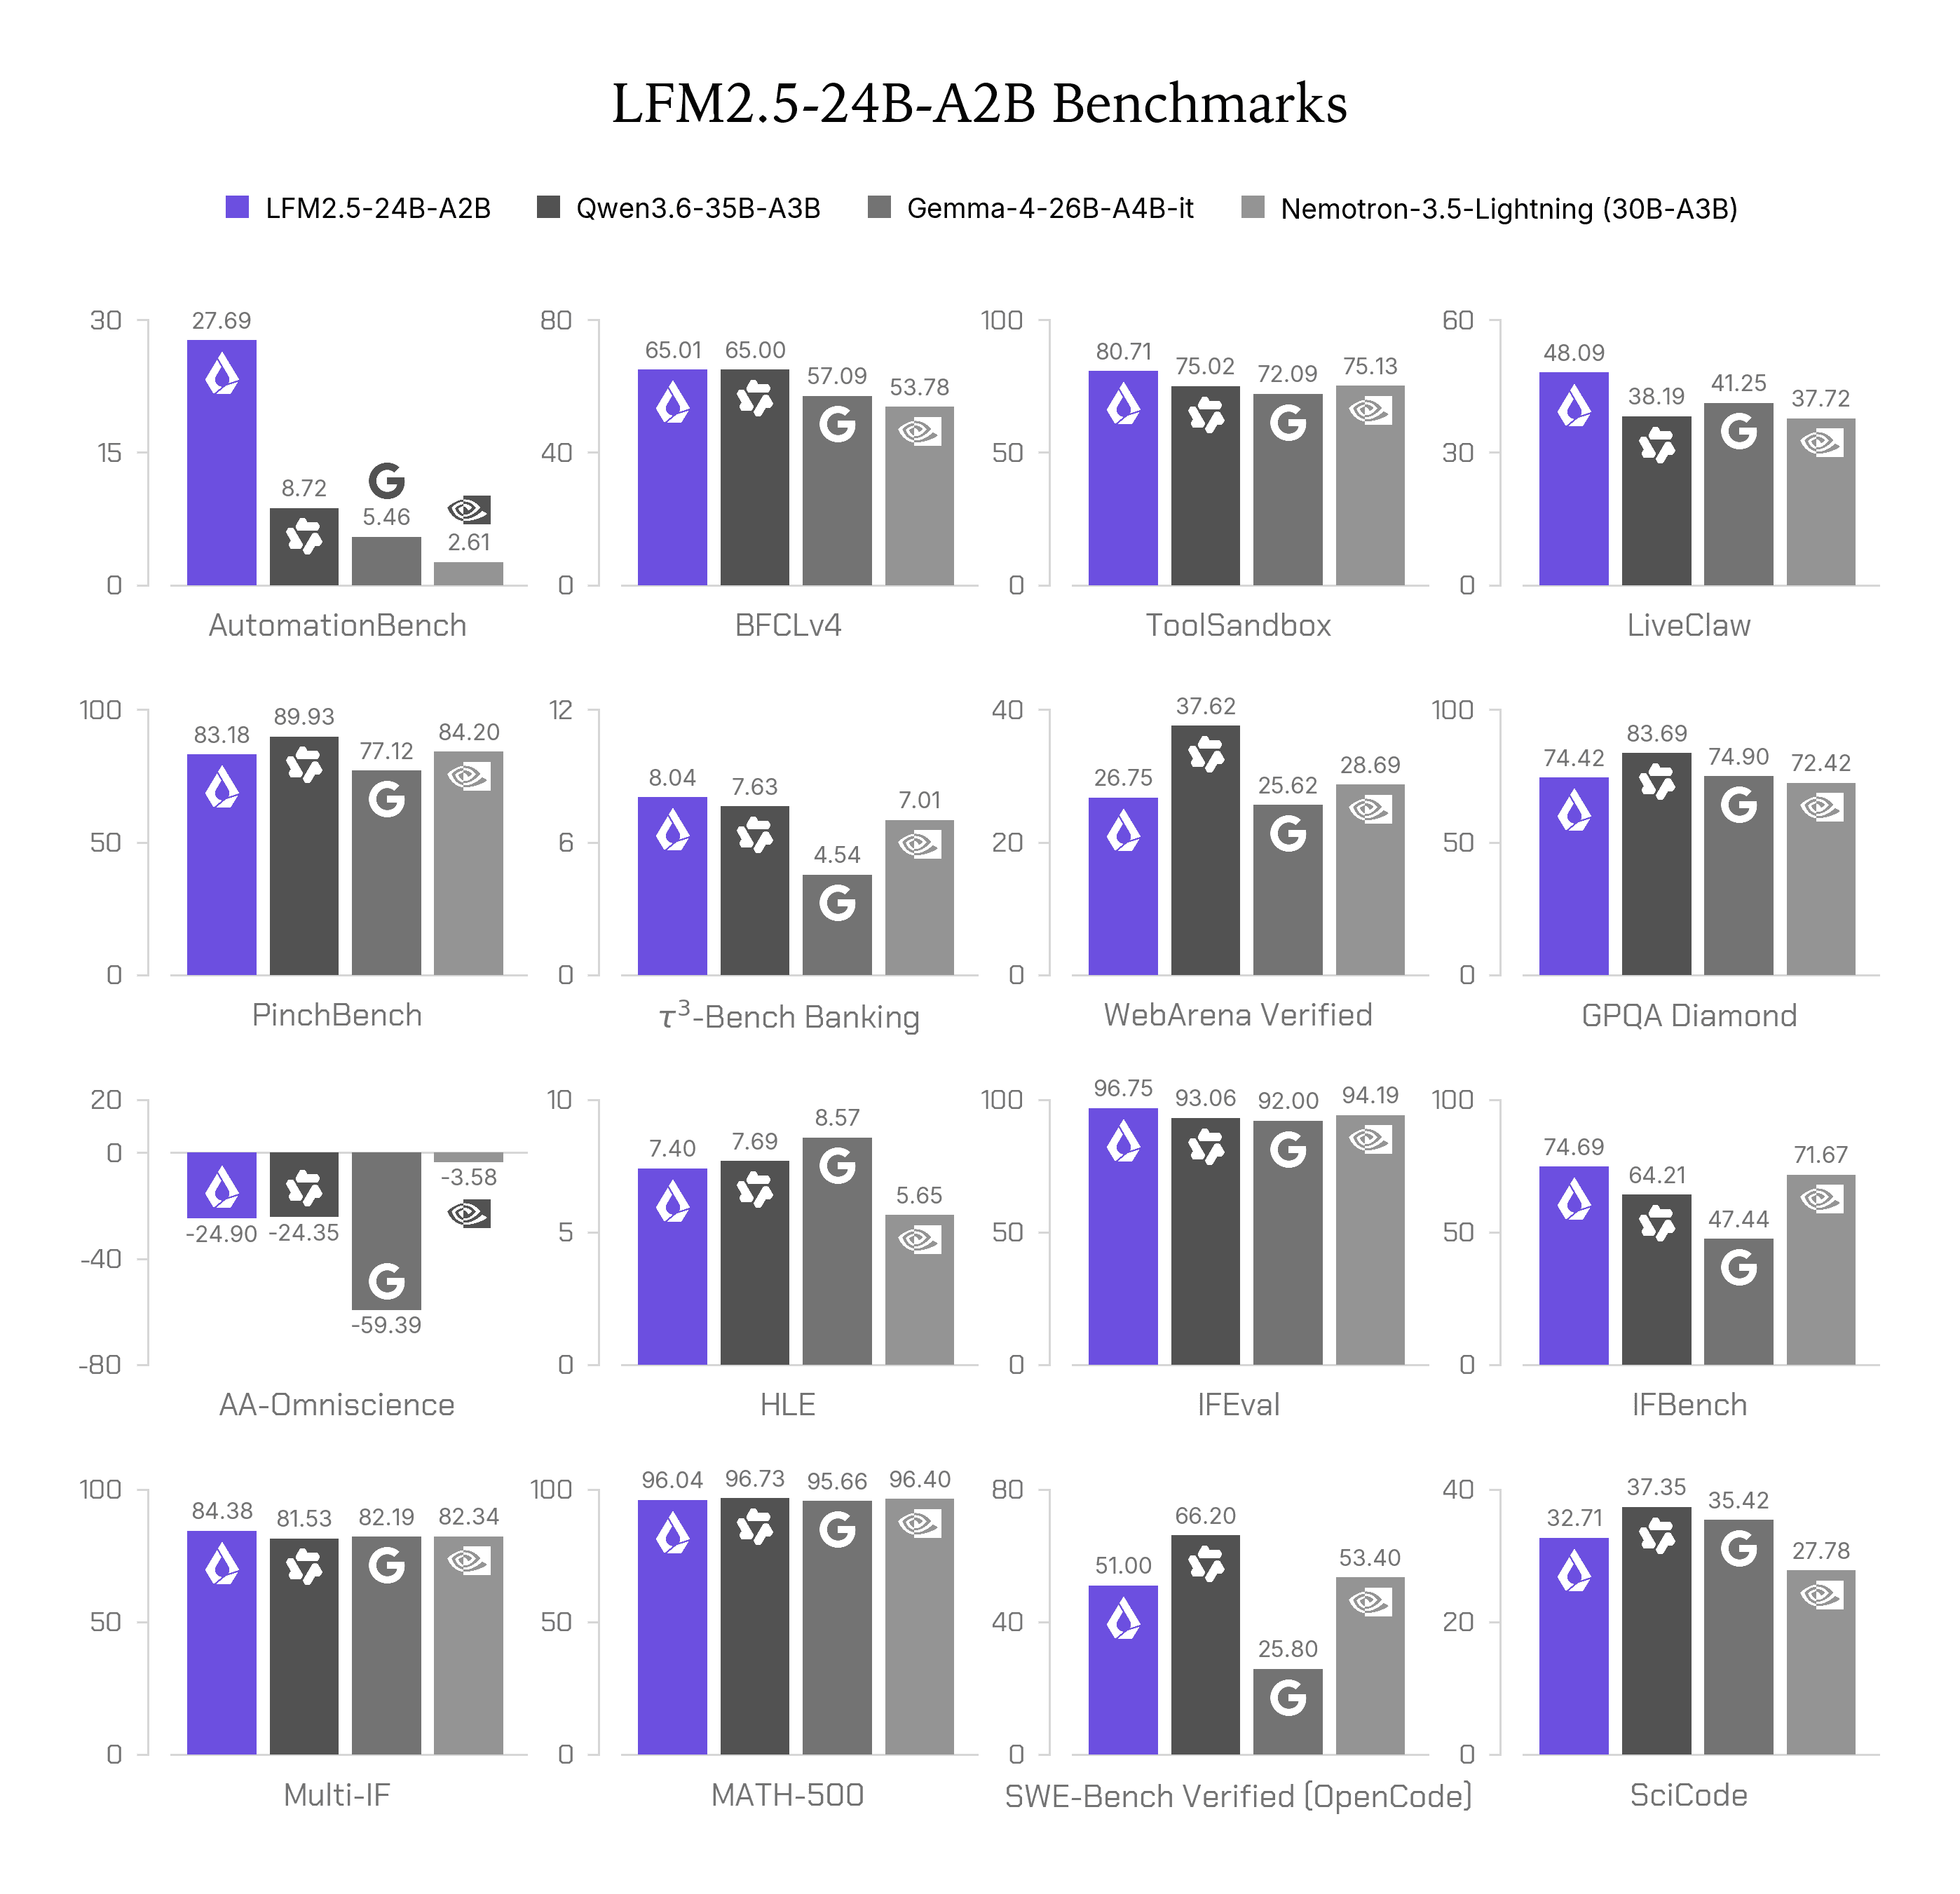
官方用 vLLM、在 16 项基准上把 LFM2.5-24B-A2B 和三个对手做了对比:Qwen3.6-35B-A3B(总参数和激活参数都多约 50%)、Gemma-4-26B-A4B-it、Nemotron-3.5-Lightning(30B-A3B)。先看它赢的地方:
在 8 项 agent/工具类基准里,它有 5 项领先或持平:AutomationBench 27.69 对 Qwen3.6 的 8.72(超过三倍,断层领先)、LiveClaw 48.09 对 38.19、BFCLv4 65.01(基本与 Qwen3.6 的 65.00 持平)、ToolSandbox 80.71 对 75.02、τ³-Bench Banking 8.04 对 7.63。三项指令遵循基准全部领先:IFEval 96.75、IFBench 74.69、Multi-IF 84.38。这个组合很有说服力:一个 agent 模型最核心的两项素质——"会调工具"和"听得懂人话"——它都拿到了同级最强。
但有三件事必须同时说清楚,否则这篇报道就是软文:
第一,全部基准都是厂商自测。官方明确写了:所有模型都用 vLLM、按各基准推荐的生成参数跑。这是 Liquid AI 自己跑的分,没有第三方独立验证。AutomationBench 上 3 倍于对手的断层领先很抓眼球,但也恰恰是最需要独立复现的一组数字。在第三方评测出来之前,建议把这些分数当作"厂商宣称"而非"定论"。
第二,它输掉的项目也很集中,而且官方自己承认了。知识密集型基准:GPQA Diamond 74.42 对 Qwen3.6 的 83.69、HLE 7.40 对 Gemma-4 的 8.57;重编码基准:SWE-Bench Verified(OpenCode)51.00 对 Qwen3.6 的 66.20、SciCode 32.71 对 37.35。官方在博客里原话建议:知识密集型工作负载,请给它配检索或联网搜索。这是一个诚实的自我定位——2B 激活参数的 MoE,指望它记住全世界本来就不现实;它的设计哲学是"推理和工具调用在本地,知识从外部拿"。
第三,注意 PinchBench 和 WebArena Verified 这两项 agent 基准它也没赢。PinchBench 83.18 对 Qwen3.6 的 89.93,WebArena Verified 26.75 对 37.62。所以"5/8 领先或持平"的另一面是:剩下 3 项里有两项输得不少。这说明它的 agent 能力是有侧重的——在自动化任务编排(AutomationBench)、真实 harness 任务(LiveClaw)这类"动手型"场景强,在网页浏览导航(WebArena)这类场景还有差距。选型的时候要对着自己的场景看,别只看总分。

跑得有多快:M5 Max 上 184 tok/s,B300 上 2.1 万 tok/s
推理速度是这次发布的另一个硬指标,而且数据给得很具体。官方宣称它是同组 MoE 里在边缘端最快的:Apple M5 Max 上解码 184 tokens/s,Ryzen AI Max+ 395 上 114 tokens/s,比次优模型快约 1.7 倍,且内存占用最低。GPU 端,在单张 NVIDIA B300 上高并发下输出超过 2.1 万 tokens/s,是同尺寸级别里最快的。
为什么速度对 agent 模型格外重要?因为 agent 的 token 消耗是聊天场景的几倍甚至几十倍:每一轮都要先输出 chain-of-thought,再调工具,再读工具返回,再继续推理。一个每 token 便宜、解码快的模型,意味着 agent 可以"一直开着"而不心疼成本——官方博客的原话是"run agents continuously on your own hardware"。2B 激活参数的意义就在这里:每个推理 token 的计算量小,连续运行的边际成本低。
生态支持是首日拉满的:llama.cpp、MLX、vLLM、SGLang、ONNX,开源当天就能用。接入本地 agent 的方式也很直接——在任意 OpenAI 兼容的后端后面把模型 serve 起来,然后把 agent harness 指过去。以 Hermes Agent 为例:
hermes config set model.provider custom
hermes config set model.base_url http://localhost:8080/v1
hermes config set model.default LFM2.5-24B-A2B
hermes config set model.context_length 131072
hermes config set model.api_mode chat_completions
hermes config set agent.tool_use_enforcement true
端口取决于你用的推理后端:llama.cpp 和 MLX 是 8080,vLLM 是 8000,SGLang 是 30000,LM Studio 是 1234。OpenClaw 和 Pi 的配置可以去模型卡上找,完整教程在 Liquid AI 的官方文档里。
它适合谁,不适合谁
最适合的读者:想私有化部署 agent,但数据不能出内网的人。这是 LFM2.5-24B-A2B 最清晰的目标场景:金融、医疗、政企,或者任何对数据出境敏感的团队。以前这类团队的选择很尴尬——要么用云端大模型(数据要出去),要么在本地跑小模型(agent 能力不够看)。一个"工具调用和指令遵循达到同级最强、能在笔记本上 184 tok/s 跑起来"的开源权重模型,直接把这个选择的代价压低了一大截。131K 上下文也够塞下比较长的 agent 工作记忆。
其次是本地 vibe coding 玩家。OpenCode、Pi 这些 harness 的用户,可以直接把本地模型指过去做日常编码 agent。注意它的短板:SWE-Bench Verified 51.00 对 Qwen3.6 的 66.20,说明重编码任务上它还是明显弱一档。我的建议是:把它当作"日常杂活 agent"(改配置、跑脚本、调工具链),重度编码任务还是交给更强的代码模型,或者等社区的微调版本。
不适合的场景:纯知识问答、需要强记忆的任务。GPQA 和 HLE 的分数已经说明了问题。官方的建议是配检索或联网——这不是客套话,是这个模型正确的使用姿势:RAG + LFM2.5 做推理和工具编排,各司其职。
结语:小模型的下半场,是"会干活"而不是"知道得多"
LFM2.5-24B-A2B 代表了一个正在成型的趋势:小模型的竞争重心,正在从"参数和知识量"转向"在真实工作流里把事办成的能力"。Liquid AI 这次把真实 agent harness 做进 RL 的做法,如果被第三方评测证实有效,很可能会成为 20B 级别 agent 模型的标准训练范式——就像当年 SFT 成为标准流程一样。
当然,现在下结论还太早。所有基准都是厂商自测,社区独立验证还没出来;它在 WebArena 这类场景的短板也提醒我们,"agent 能力"不是一个单一分数,而是一组场景相关的能力侧写。但方向是对的:对想在本地、私有化跑 agent 的人来说,市面上多了一个值得认真评估的开源选项——而且评估成本很低,权重已经在 Hugging Face 上,Base 和后训练版都有,llama.cpp 当天就能跑起来。先跑起来,再看它在你自己的 harness 里表现如何,这比任何基准分数都更能说明问题。
一句话总结:别只看 24B 这个数字,看它的训练方法——把 vibe coder 每天用的工具直接做进强化学习,这才是这次发布真正想讲的故事。
评论 (0)
原始来源
相关文章
10 月 17 日,DeepSeek 发布 V4.1-Flash-1017:11 项基准较 9 月版全部提升,权重以 MIT 许可开源,API 名称与价格不变;自研搜索引擎同步开放为 Search 与 Fetch 两个公开 API,每千次成功请求 0.75 美元。本文拆解跑分细节、计费与限流规则,以及“官方联网检索”做成 API 基础设施对 vibe coder 意味着什么。
Anthropic Frontier Red Team(10-12)把 26B 模型跑在 15 台 55 美元电视盒子上(0.39 tokens/s),预测小模型年底达到 GLM-5.2 的复制水平。本文分清"测出来的"与"预测的",拆解 ECI 算法、上界 caveat,以及它对 agent 沙箱的意义,并与真实的 CyberXero 攻击事件对照。
10 月 14 日,阿里 Qwen 团队开源 BlenderWorld:一套考视觉智能体在 Blender 里做真实 3D 创作的基准,223 个任务、2651 条评分标准,交卷交的是可编辑的 .blend 工程文件而非渲染图。本文拆解它的考法、判分流水线与评测风向意义。