本地跑得好好的,一上服务器就崩:vibe 项目的 Docker 生产化实战
AI 生成的 Dockerfile 有 5 个常见毛病:单阶段构建、root 运行、无健康检查、收不到 SIGTERM、secret 打进镜像层。这篇给你多阶段构建模板、基础镜像选型决策表、生产级 compose 编排和上线前 checklist。
先划清边界:这篇不讲什么
站内已经有三篇容易混淆的指南,先说明分工,免得你读重了:
- 《vibe 项目的自托管落地实战》讲的是「把服务放哪」——VPS、Coolify、Dokku 怎么选、成本拐点在哪;
- 《vibe 项目的开发环境标准化实战》讲的是「本地怎么跑起来」——devcontainer、新人 30 分钟上手;
- 《vibe 项目的 CI/CD 最小管线》讲的是「代码怎么自动上线」——5 个 Job 的流水线。
本篇只回答一个问题:「镜像怎么做、容器怎么跑,才不会在生产环境翻车。」Dockerfile 多阶段构建、基础镜像选型、非 root 运行、健康检查、优雅停机、compose 生产编排——这些是上面三篇都没展开的脏活累活。
AI 生成的 Dockerfile,通常有这 5 个毛病
让 AI「写个 Dockerfile」是 vibe coding 的标准动作,10 秒出结果。但直接拿去生产,大概率踩中下面至少一条:
- 单阶段构建,镜像 1.2GB 起步。源码、node_modules、构建工具、.git 全塞进最终镜像,拉镜像比部署代码还慢;
- root 用户运行。容器逃逸不是危言耸听,root 进程被打穿就是宿主机 root;
- 没有 HEALTHCHECK。进程僵死了但容器显示 running,负载均衡继续往里导流量;
- 收不到 SIGTERM。用 shell 格式 CMD 启动,信号被 sh 吃掉,滚动更新时请求直接被掐断;
- secret 写进镜像层。
ENV API_KEY=xxx写在 Dockerfile 里,镜像推到仓库就等于公开。
下面逐个拆掉。
决策表:你的项目值得容器化吗
不是所有 vibe 项目都需要 Docker。先花 30 秒对一下表:
| 场景 | 建议 | 理由 |
|---|---|---|
| 纯 Next.js 前端,部署在 Vercel / Netlify | 不需要 | 平台已经帮你做了构建和运行时隔离 |
| 前后端同构,上 Railway / Render / Fly.io | 可选 | 平台支持 Dockerfile,但 buildpack 也够用;想锁定环境再上 |
| 自有 VPS / 裸金属 / Coolify / Dokku | 必须 | 没有容器,环境漂移早晚找上门 |
| 后端 + 数据库 + Redis + 定时任务多组件 | 必须 | docker compose 是唯一能让本地和生产用同一套编排的东西 |
| 要给客户/朋友交付「一键跑起来」 | 推荐 | docker compose up 比写 3 页环境说明靠谱 |
多阶段构建:最终镜像里只留运行时
多阶段构建的核心思想一句话:构建是构建,运行是运行,用 COPY --from 只把产物搬进最终镜像。下面是一个生产可用的 Node.js 模板(Next.js standalone 输出或纯 Node 服务都适用):
# ---------- 阶段 1:装依赖 ----------
FROM node:20-slim AS deps
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci --omit=dev

# ---------- 阶段 2:构建 ----------
FROM node:20-slim AS build
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci
COPY . .
RUN npm run build

# ---------- 阶段 3:运行时(唯一被推送的镜像) ----------
FROM gcr.io/distroless/nodejs20-debian12 AS runtime
WORKDIR /app
COPY --from=deps /app/node_modules ./node_modules
COPY --from=build /app/dist ./dist
COPY --from=build /app/package.json ./package.json
USER nonroot
EXPOSE 3000
ENTRYPOINT ["node", "dist/index.js"]注意三个细节:第一,npm ci --omit=dev 装生产依赖,构建阶段才装全量,devDependencies(typescript、eslint)永远进不了最终镜像;第二,最终阶段用 USER nonroot,distroless 镜像自带 nonroot 用户(uid 65532);第三,ENTRYPOINT 用 JSON 数组格式(exec 格式),让 node 成为 PID 1,直接收信号——这就是第 4 个毛病的解法。

Python 项目同理,只是把 npm 换成 pip,运行时换成 python:3.12-slim:
FROM python:3.12-slim AS build
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir --prefix=/install -r requirements.txt

FROM python:3.12-slim AS runtime
WORKDIR /app
COPY --from=build /install /usr/local
COPY ./src ./src
RUN useradd -m appuser && chown -R appuser /app
USER appuser
EXPOSE 8000
ENTRYPOINT ["python", "-m", "src.main"]
基础镜像选型:体积差一个数量级

| 基础镜像 | 适用场景 | 注意 |
|---|---|---|
node:20(debian 全量) | 别用 | 约 1GB,含编译工具链,攻击面最大 |
node:20-slim | 默认选择 | 有 shell,方便 exec 进去排错 |
node:20-alpine | 需要极致体积时 | musl 不是 glibc,sharp、prisma 等二进制包可能翻车,先实测 |
distroless/nodejs20 | 生产最终态 | 无 shell、无包管理器,排错靠日志和指标;调试时临时换 slim 版 |
一人团队的务实路线:开发调试用 slim,上生产用 distroless,Dockerfile 里用 ARG BASE_IMAGE 一行切换。Alpine 的坑值得单独说一句:AI 很爱给你用 alpine,因为「小」,但 musl 与 glibc 的差异会导致某些 npm 包的预编译二进制无法加载,报错信息还极其晦涩——除非你实测过,否则别为了省 40MB 赌这个。
生产级 Dockerfile 的 6 条硬规矩
.dockerignore必须写。至少排除node_modules、.git、.env、*.log、.next/cache。否则构建上下文几 GB,COPY . .把本地 .env 直接打进镜像——secret 泄露就是这么发生的。- 非 root 运行。distroless 用
USER nonroot;slim/debian 系自己useradd。配合--read-only运行更佳(需要写 /tmp 的应用挂 volume)。 - HEALTHCHECK 必须有。没有它,编排器不知道你的应用是真活还是僵死:
注意HEALTHCHECK --interval=30s --timeout=5s --start-period=20s --retries=3 \ CMD node -e "fetch('http://localhost:3000/api/health').then(r=>{if(!r.ok)process.exit(1)})" || exit 1start-period要覆盖冷启动时间,否则应用还没起来就被判死刑、反复重启。 - 信号用 exec 格式。
CMD npm start(shell 格式)会让 sh 成为 PID 1,SIGTERM 发不到 node。永远用["node","dist/index.js"]这种 JSON 数组格式。 - secret 走运行时注入,不进镜像层。Dockerfile 里不出现任何
ENV SECRET;构建期需要的 key 用 build secrets:RUN --mount=type=secret,id=npmrc npm ci。 - 固定小版本。
FROM node:20今天和三个月后不是同一个镜像。用node:20.18.1-slim这类精确 tag, renovate / dependabot 负责跟进。
优雅停机:别让滚动更新掐断用户请求
容器收到 SIGTERM 到被 SIGKILL 之间,默认只有 10 秒。这 10 秒要干三件事:停止接收新请求、处理完手头请求、关闭数据库连接。Node.js 模板:
const server = app.listen(3000);

async function shutdown(signal) {
  console.log(`received ${signal}, draining...`);
  server.close(async () => {          // 1. 不再接受新连接
    await db.end();                  // 2. 关掉连接池
    process.exit(0);
  });
  setTimeout(() => process.exit(1), 9000).unref(); // 3. 9 秒兜底
}
process.on('SIGTERM', () => shutdown('SIGTERM'));
process.on('SIGINT', () => shutdown('SIGINT'));
Python(uvicorn/fastapi)把 --timeout-graceful-shutdown 调大,并在 lifespan 里关闭连接池。配合 compose 的 stop_grace_period: 30s,滚动更新时用户侧是零感知。
docker compose 生产编排:一份能用的模板
services:
  app:
    build: .
    image: registry.example.com/myapp:${TAG:-latest}
    restart: unless-stopped
    env_file: .env.production
    ports: ["127.0.0.1:3000:3000"]   # 只绑本机,前面放 Caddy/Nginx 反代
    depends_on:
      db: { condition: service_healthy }
      redis: { condition: service_started }
    healthcheck:
      test: ["CMD", "node", "-e", "fetch('http://localhost:3000/api/health').then(r=>{if(!r.ok)process.exit(1)})"]
      interval: 30s
      start_period: 20s
    deploy:
      resources:
        limits: { cpus: "1.0", memory: 512M }  # 防内存泄漏拖垮整台机器
    stop_grace_period: 30s
    logging: { driver: json-file, options: { max-size: "10m", max-file: "3" } }

  db:
    image: postgres:16-alpine
    restart: unless-stopped
    environment:
      POSTGRES_PASSWORD_FILE: /run/secrets/db_password
    secrets: [db_password]
    volumes: [pgdata:/var/lib/postgresql/data]
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres"]
      interval: 10s

  redis:
    image: redis:7-alpine
    restart: unless-stopped
    command: ["redis-server", "--appendonly", "yes", "--maxmemory", "256mb",
              "--maxmemory-policy", "allkeys-lru"]

volumes: { pgdata: {} }
secrets: { db_password: { file: ./secrets/db_password.txt } }逐条解释关键选择:ports 只绑 127.0.0.1——数据库和 Redis 根本不映射端口,应用容器之间走 compose 内网,这是最低成本的网络隔离;depends_on 配 service_healthy 而不是裸依赖,避免应用在数据库还没 ready 时 crash-loop;resources.limits 给内存设上限,Node 应用内存泄漏时只会重启自己,不会把整台 VPS 拖死;日志加 max-size 轮转,否则 json-file 日志能把磁盘吃满——这是 vibe 项目半夜被告警短信吵醒的经典原因。
镜像安全最小集:一个人能做完的三件事
- 构建后扫一遍。
docker scout cves myapp:latest或开源的 trivy:trivy image myapp:latest。重点看 CRITICAL,每周跑一次就行,修法通常是升级基础镜像 tag。 - secret 审计。构建前跑
grep -r "sk-\|AKIA\|BEGIN PRIVATE KEY" --include="Dockerfile" --include=".dockerignore" .太原始?用 gitleaks 扫整个仓库,一条命令。 - 最小权限运行。非 root + 只读文件系统(
read_only: true,需要写的地方挂tmpfs),这两项做完,容器逃逸的利用链就断了大半。
构建加速:别让每次部署等 10 分钟
多阶段构建的隐藏福利是层缓存:依赖层几乎不变,只有最后一两层重建。CI 里用 buildx 的 registry 缓存:
docker buildx build \
  --cache-from type=registry,ref=registry.example.com/myapp:cache \
  --cache-to type=registry,ref=registry.example.com/myapp:cache,mode=max \
  --push -t registry.example.com/myapp:${GITHUB_SHA} .
实测效果:依赖不变时构建从 6 分钟降到 40 秒。另外 COPY package.json 永远放在 COPY . . 前面——这是层缓存的铁律,顺序反了,每次改一行代码都重装依赖。
上线前 checklist(打印出来逐项打勾)
- ☐
docker build在干净环境(CI)能一次通过,本地缓存不算数 - ☐ 镜像里
whoami不是 root - ☐
docker scout/ trivy 无 CRITICAL 漏洞 - ☐ HEALTHCHECK 的
/api/health真实检查了 DB 连通性(别只 return 200) - ☐
docker stop后 10 秒内优雅退出,日志里能看到 draining - ☐ 数据库和 Redis 没有映射到公网端口
- ☐ 日志轮转已配,磁盘不会被吃满
- ☐
.env.production不在镜像里、不在 git 里 - ☐ 内存 limit 已设,OOM 时只重启容器
- ☐ 回滚方案:上一个 tag 的镜像还在仓库里,一条命令能切回去
5 个真实翻车现场(都是血换来的)
- Alpine + Prisma = 凌晨三点的 500。musl 下 Prisma 引擎二进制加载失败,本地 Mac(glibc 兼容层)测不出来。解法:用 slim,或给 Prisma 配
binaryTargets = ["linux-musl"]并实测。 npm start吃掉了 SIGTERM。滚动更新时旧容器被 SIGKILL,正在处理的支付回调直接中断。解法:exec 格式 ENTRYPOINT + 优雅停机代码。- HEALTHCHECK interval 太短。冷启动 25 秒,interval 10 秒,容器永远进不了 healthy,compose 一直重启。解法:
start_period覆盖冷启动。 - 日志把磁盘写满。json-file 默认无上限,三个月后 VPS 磁盘 100%,数据库先挂。解法:logging max-size 轮转。
.env打进镜像推到了 Docker Hub 公开仓库。API key 当天就被刷。解法:.dockerignore + build secrets + 泄露后立刻轮换所有 key(别只删镜像)。
总结一句话:Dockerfile 是生产环境的第一道门,AI 生成的初稿永远只是草稿——用上面的 checklist 逐项验收,再推上生产。
评论 (0)
相关文章
三个信号说明你该 monorepo 了:一个功能要开 3 个 PR、类型对不上线才炸、AI agent 老改漏。这篇给你可直接抄的目录骨架、Turborepo 编排、类型共享实战,以及 Vercel 与 Docker 各自的部署坑。
功能开关把部署和发布解耦:代码先上,功能后开。四种开关类型与选型矩阵、一张表的最小实现、兜底铁律(新功能默认关、止血开关冻结)、开关腐烂治理,以及开关与灰度发布如何配合。
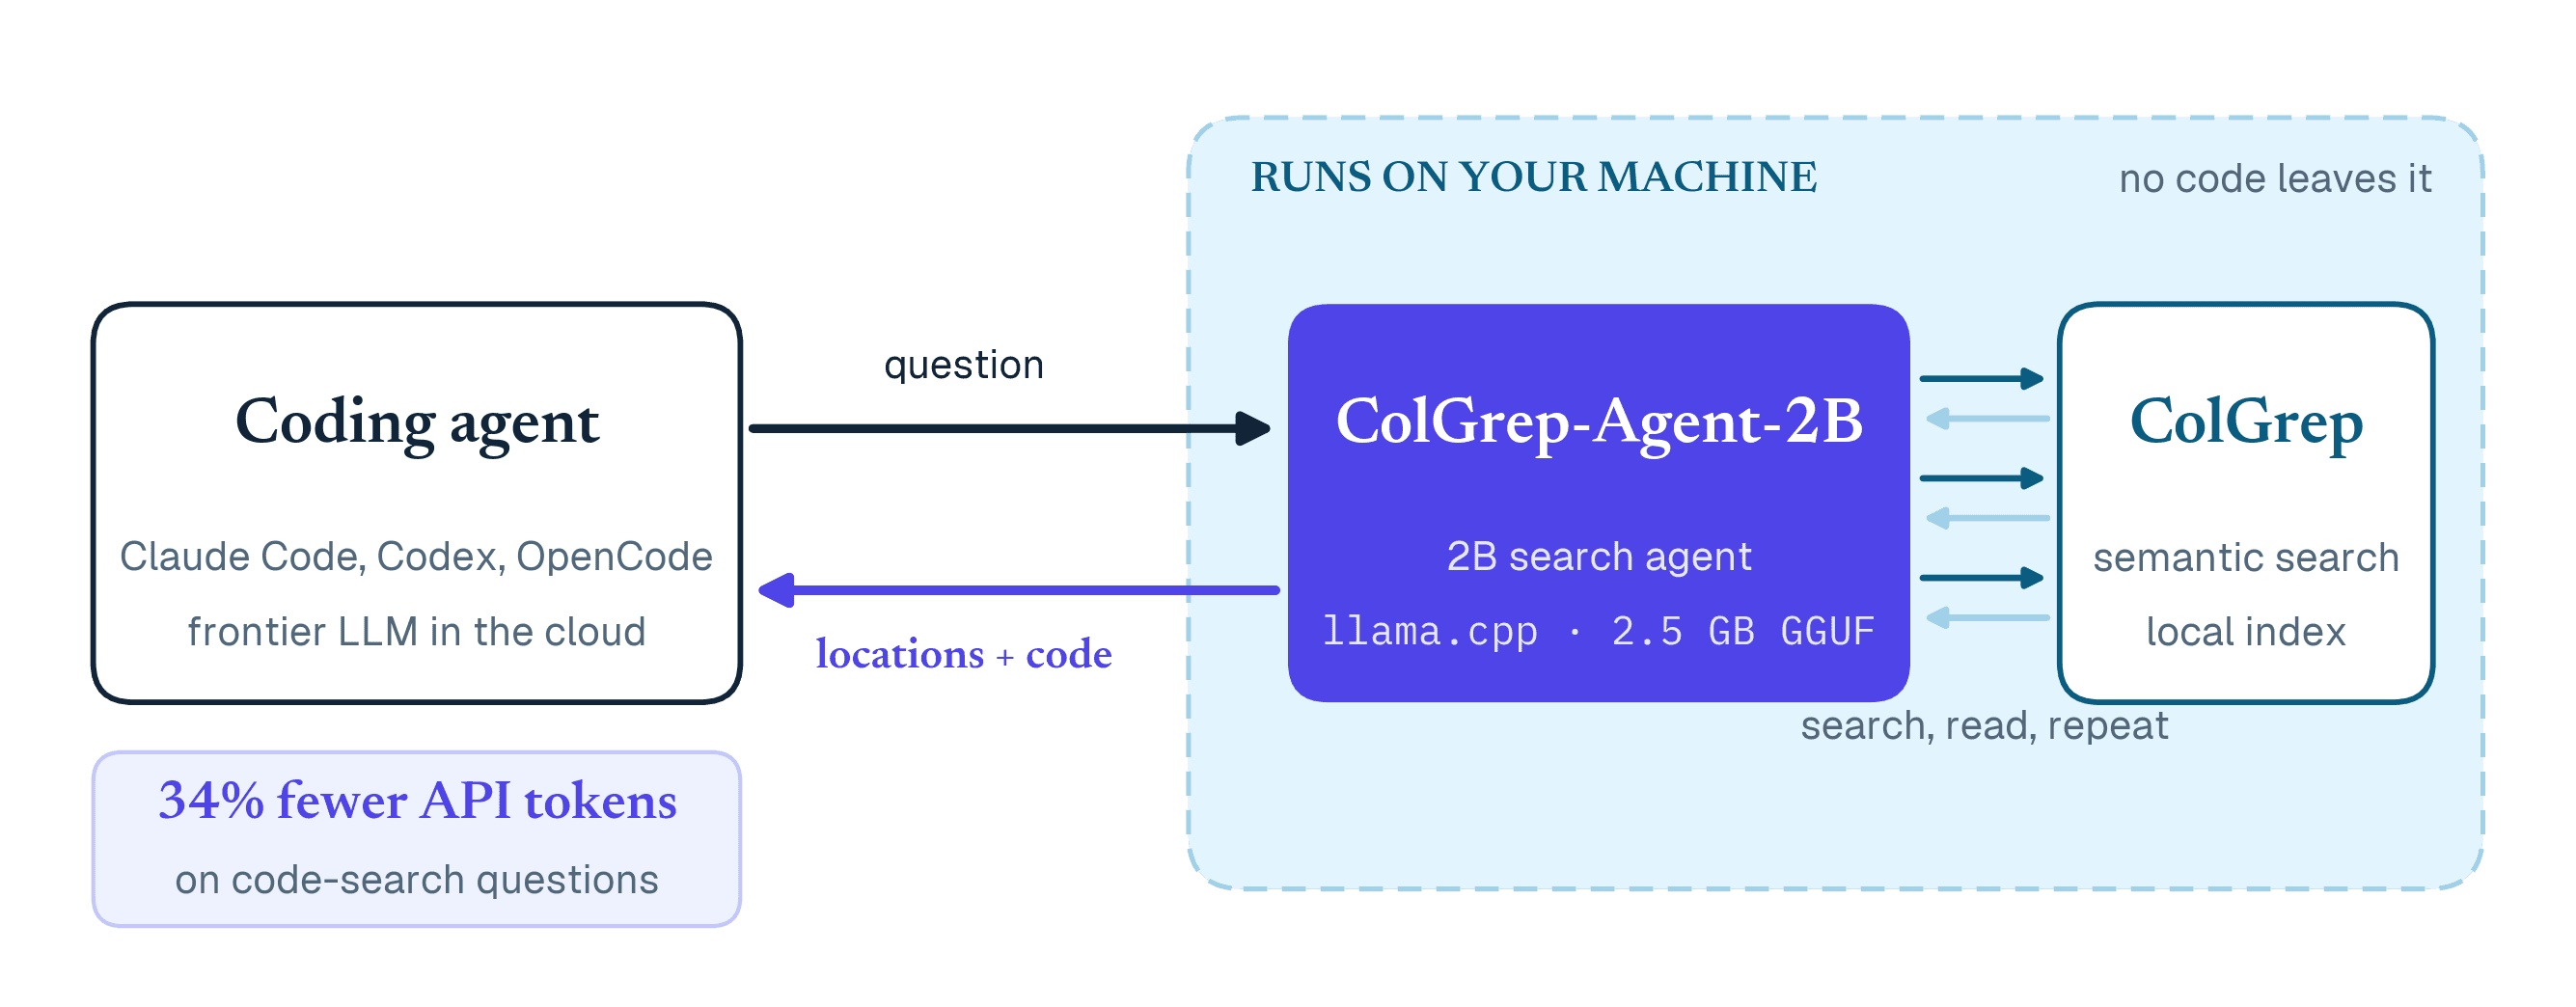
LightOn 10 月 12 日在 Hugging Face 官方博客发布 ColGrep-Agent-2B:一个跑在本地的 20 亿参数代码搜索 agent。624 个 sessions 实测(Claude Code + Sonnet 5.5,52 题 × 13 个 2026 年新建仓库):把搜索下沉给本地小模型后,API token 省 34.3%、缓存感知成本降 40%,答对率无统计显著变化。这是第一篇用硬数字算清“小模型分工经济学”的文章。