给 vibe 项目装上「眼睛和耳朵」:一人团队的可观测性实战
AI 写的代码半夜静默失败、token 账单悄悄爆炸、用户报错你复现不了——vibe 项目大多死于「看不见」。这篇实战指南带你用 1 小时搭起最小可用可观测性:结构化日志、OpenTelemetry 追踪、一个看板、两个告警,外加必须埋的 4 个指标和 3 个反模式。
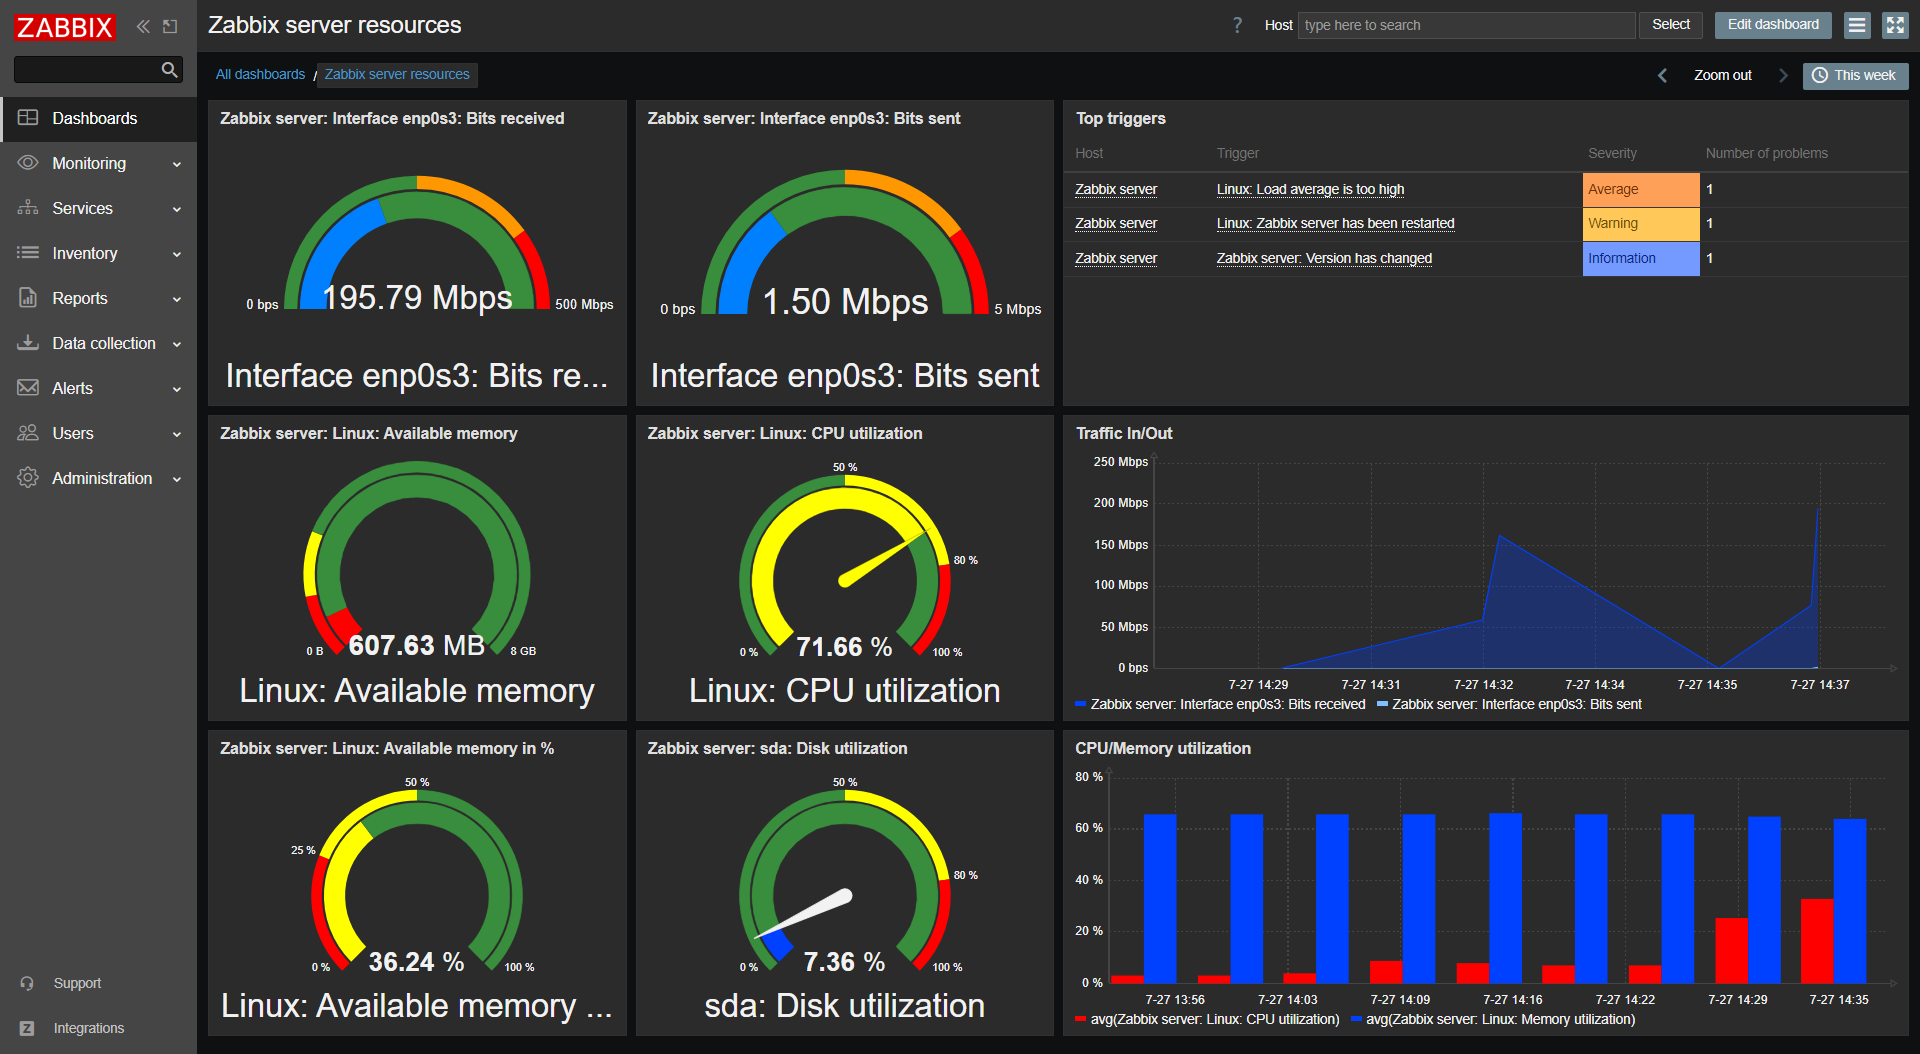
你的项目正在「盲飞」,你只是还不知道
先讲三个每个 vibe coder 都经历过的凌晨三点时刻。第一个:用户在群里说「刚才下单失败了」,你打开日志,满屏都是 console.log("here") 和 console.log(data),data 到底是什么,没人知道,包括三个月前写下这行代码的 AI。第二个:月底打开模型厂商的账单,token 费用是上个月的三倍,你完全想不起来钱花在了哪个功能上。第三个:最恐怖的——没有任何报错,没有任何投诉,但某个定时任务已经静默失败两周了,你直到用户流失才发现。
这三个时刻有一个共同的病因:你的项目在盲飞。AI 帮你把功能写出来了,但它没帮你装上仪表盘。可观测性(observability)听起来像大公司的专有名词,动辄 Datadog、Grafana 全家桶,但一人团队真正需要的版本,一个小时就能搭起来。这篇文章就是那一个小时的操作手册。
先说结论:最小可用可观测性只需要四样东西——结构化日志、分布式追踪、一个看板、两个告警。下面逐个拆开,全部按「今晚就能动手」的标准写。
第一步:把日志从「纸条」升级成「表格」
大多数 vibe 项目的日志长这样:AI 随手写的 console.log("user login", userId)、console.log("error!!!", err),混在一起,人能读,机器读不了。排查问题的时候你只能靠 grep 碰运气,稍微复杂一点的线上问题就抓瞎。
改法很简单,几乎零成本:所有日志输出 JSON。每条日志是一个对象,固定带上时间戳、级别、请求 ID,业务字段按需加:
{"ts":"2026-10-07T11:00:00Z","level":"info","req_id":"a3f9…","event":"llm_call","model":"sonnet","tokens_in":1200,"tokens_out":340,"ms":2100}
就这一条改变,排查效率是质变。以前你要靠眼睛扫,现在你可以按 req_id 把一次请求的全链路捞出来,按 event=llm_call 聚合出每个模型的调用量和耗时。Node 用 pino,Python 用 structlog,都是几行配置的事。让 AI 帮你改的时候,指令也很明确:「把全项目的 console.log / print 换成结构化 JSON 日志,统一字段 ts、level、req_id」——这种机械重构恰恰是 AI 最擅长的活。
一个容易被忽略的细节:请求 ID 必须全链路透传。前端生成也好,网关生成也好,一个 req_id 从 HTTP 请求跟到数据库查询、跟到每一次 LLM 调用。没有 req_id 的结构化日志,只是整齐一点的纸条;有了 req_id,它才变成能串起来的证据链。
第二步:接 OpenTelemetry,看到 trace 瀑布图的那一刻会上瘾
日志回答「发生了什么」,追踪(tracing)回答「时间花在哪儿了」。当你的请求链路变成「HTTP → 鉴权 → 向量检索 → 三次 LLM 调用 → 数据库写入」时,光看日志你永远拼不出耗时分布,而一张 trace 瀑布图一眼就能告诉你:哦,原来 80% 的时间卡在第二次 LLM 调用上。
这里的关键选择是 OpenTelemetry,而不是某个厂商的 SDK。理由很实际:OTel 是厂商中立的标准,你今天把 trace 发到自托管的 Parseable,明天想换 Grafana Cloud 或 Datadog,改一行 exporter 配置就行,埋点代码不用动。对一人团队来说,「不被锁定」比「功能多 10%」重要得多。
动手路径(实测走通过):以 Python 项目为例,装 opentelemetry-sdk 和对应框架的 instrumentation 包(FastAPI、httpx、SQLAlchemy 都有官方 instrumentation,基本是 pip install 加两行初始化代码),trace 通过 OTLP 协议发出去。Node 侧也一样,@opentelemetry/sdk-node 加自动插桩,开箱就能抓到 HTTP 和数据库调用的 span。LLM 调用没有现成插桩?自己包一层:每次调模型前后各记一个 span,把 model、tokens、cost 写进 span 属性——这正是后面做成本核算的数据源。
接收端我推荐先看 Parseable:Rust 写的开源可观测平台,AGPL 协议,单个二进制文件约 180MB,本地 ./parseable 一跑就有 Web 界面,能收 OTel 的 trace 和 log。Simon Willison 前几天就这么玩的——Datasette 1.0a41 刚加上 OpenTelemetry 支持,他让 Codex 摸索着把 trace 接进本地 Parseable,成功看到了 trace 瀑布图。对,就是这么轻量:不需要搭 Kafka,不需要写 YAML 写到手软。
当然你也可以直接用托管方案(Grafana Cloud 有免费额度,Axiom、Highlight 这类新贵对小流量也很友好)。选型只有一条标准:今晚能跑起来。可观测性系统的最大风险不是选错,而是「下周再搭」然后永远没搭。
第三步:只看 4 个指标,只设 2 个告警
看板是最容易做过头的地方。我见过的一人项目里,有人配了 20 个看板面板,然后一次都没打开过。记住:你看不懂的指标等于不存在。一人团队的看板上只需要 4 个数字:
- 请求延迟(p50/p95/p99):用户体感的底线。p99 悄悄爬坡,往往是依赖服务或模型变慢的最早信号。
- LLM 调用延迟 / token / 成本,按 endpoint 拆:这是 vibe 项目的专属指标。哪个接口烧 token 最多,必须一眼可见。成本最好换算成钱,而不是 token 数——「昨天烧了 4.2 美元」比「昨天用了 180 万 token」更能让你心疼,也更能驱动优化。
- 错误率:按 endpoint 和错误类型拆。注意要把「模型返回了但内容不可用」(比如 JSON 解析失败、tool call 参数非法)也算进错误——AI 时代的错误,一半长得不像错误。
- agent 循环步数:如果你跑了 agent(客服、代码助手、工作流),记录每次任务循环了几步。步数分布突然拉长,通常意味着 prompt 退化、工具故障,或者 agent 在某个环节打转。
告警更要克制:只设两个。第一,错误率突增(比如 5 分钟错误率超过过去一小时均值的 3 倍);第二,成本突增(单日 LLM 花费超过你设定的硬预算上限的一定比例)。其他的都可以先放一放。告警的铁律是:每一条告警都必须对应一个你知道怎么处理的动作,否则它只会训练你忽略告警——「狼来了」喊三次,你的手机通知权限就形同虚设了。
关于「硬预算上限」多说一句:给模型调用设一个代码层面的熔断,比如单日花费超过 X 美元就降级到便宜模型或直接拒绝非核心请求。这是 2026 年 vibe 项目的必修课。账单爆炸从来不是慢慢发生的,都是一次 prompt 改坏、一次循环 bug,在几小时内烧出来的。熔断器是唯一能在你睡觉时替你踩刹车的东西。
一小时清单:今晚就动手
把上面的内容压缩成一份今晚能执行完的清单。开一瓶快乐水,计时开始:
- 选接收端(10 分钟):本地跑 Parseable,或注册一个托管方案的免费账号。标准只有一个:今晚能看到数据进来。
- 加 OTel SDK(20 分钟):装 SDK 和框架 instrumentation,配好 OTLP exporter 指向接收端。让 AI 写初始化代码,你负责验证 trace 真的进来了。
- 定义 3 个关键指标(10 分钟):请求延迟、LLM 成本(按 endpoint 拆)、错误率。先别贪多,agent 步数可以下周再加。
- 配一个看板(10 分钟):就一个页面,4 个数字(先 3 个也行)。能一眼回答「现在系统健康吗」就行。
- 设两个告警(5 分钟):错误突增、成本突增,推送到你真的会看的地方(手机推送、Telegram,不是邮箱)。
- 故意搞崩一次(5 分钟):这是最重要的一步。 staging 环境也好,本地也好,手动触发一个错误,看告警响不响、看板跳不跳、trace 能不能定位到。从没响过的告警,等于没有告警。
还有两个实操提醒。第一,可观测性本身也有成本:trace 全量采集的话,存储和传输费用会吓你一跳。采样率从 1% 起步,错误请求的 trace 全采、正常请求只采 1%,这是行业标准做法。第二,日志里别记敏感信息:用户输入原文、API key、完整 prompt,默认脱敏。哪天你要把日志给别人看(或者日志服务被脱库),会感谢今天的自己。
三个反模式,看看你中了几个
最后说三个一人团队最常见的反模式,对照自查:
反模式一:上了 20 个看板,从不看。看板的价值在于「被看」。如果你一周都没打开过那个页面,删掉它,或者把它缩成手机推送里的一行数字。没人看的看板只是自我安慰。
反模式二:告警太多,变成「狼来了」。磁盘用了 70% 也告警、CPU 抖一下也告警,一天 30 条,你三天后就会把通知静音。告警只保留「半夜三点愿意起床处理」的那种,其他的降级成看板数字。
反模式三:只记日志,不记指标。日志是用来定位的,指标是用来发现的。没有指标,你发现故障的方式永远是「用户先发现」。指标回答「有没有问题」,日志回答「问题在哪」——顺序不能反。
说到底,可观测性对一人团队的意义,和大公司完全不同。大公司要的是合规和审计,你要的是睡觉安稳:半夜出问题时,手机响的那一下是有信息量的;早上醒来,昨晚烧了多少钱一目了然;用户报 bug,你 10 分钟就能复现定位。AI 帮你把写代码的速度提了 10 倍,配得上它的调试速度,也得跟上 10 倍——不然你只是在用 10 倍的速度制造 10 倍的黑盒。
相关文章

公网上的每个接口都会在某个深夜被超预期调用。这篇实战为一人团队搭建限流体系:算法选型(滑动窗口 vs 令牌桶)、四层防御、AI 接口烧钱专项防护、配额设计、429 响应规范、误伤排查,最后附上线检查清单。

每个 vibe 项目都会经历同一个黑色幽默时刻:网站白屏了,朋友比你的监控先告诉你。这篇实战为一人团队搭建完整错误监控体系:5 分钟 Sentry 最小闭环、错误边界、上报上下文设计、后端结构化日志、AI 调用专项防护、告警分级降噪,最后附上线检查清单。
每个 vibe 项目迟早需要定时任务:每日数据同步、过期订单清理、账单对账、定时报告。AI 给你的第一个版本通常是 setInterval——开发够用,生产必死。这篇实战给出四种跑法的选型地图(应用内/Vercel Cron/GitHub Actions/Cloudflare),cron 表达式速查与时区坑,幂等性、防重叠分布式锁、失败重试与告警、可观测性 run log,以及 cron 接口的鉴权,最后附上线清单。