从能跑到快:vibe 项目性能优化实战
AI 生成的代码能跑,但多半慢:bundle 膨胀、N+1 查询、原图直出、零缓存。本文是一份专为 vibe coder 写的性能优化实战手册——从 Web Vitals 基线、图片与 bundle 瘦身,到数据层修法、LLM 流式体感优化,再到可进 CI 的上线验收清单,一步步把你的项目从「能打开」做到「打开就爽」。
先对号入座:AI 生成代码的四大性能坑
Agent 写代码有一个根本性的偏见:它只优化「能不能跑」,从不优化「跑得多快」。完成功能是它的 KPI,性能是你的。几乎每个 vibe 项目上线后都会踩中下面这几个坑,先对号入座,看看你中了几个。
坑一:依赖装起来不心疼。你要一个日期选择器,Agent 给你装了整个组件库;你要一个图标,它引入了一个 200KB 的图标包。node_modules 里躺着几十个「只用了一个函数」的包,首屏 JS 轻松突破 1MB。Agent 没有「这个包值不值」的概念,有 import 能用就行。
坑二:N+1 查询。这是 AI 生成后端代码的保留节目。列表页先查 50 条记录,再循环 50 次逐条查关联数据。本地开发数据量小,毫秒级返回你毫无感觉;线上数据一多,页面直接从 200ms 变成 8 秒。
坑三:图片原图直出。手机拍的 4K 照片直接当 hero 图上传,单张 8MB,首页三张图 24MB。用户在 4G 下打开你的网站,先看 10 秒白屏。Agent 不会主动压缩、转格式、做响应式尺寸——除非你明确要求。
坑四:没有缓存意识。每次请求都重新查库、重新渲染、重新算。首页内容一天才变一次,Agent 却让它每次访问都走完整链路。缓存是性能优化里投入产出比最高的一招,也是 Agent 最不会主动加的一招。
好消息是:这四个坑都有标准解法,而且都不需要你重写项目。下面按「测量 → 图片 → bundle → 数据 → 体感 → 验收」的顺序,一个一个填。
没有基线的优化都是玄学:先测量
动手改代码之前,先回答一个问题:你的网站现在到底有多慢?答不上来,就别动手。性能优化最大的浪费,就是凭感觉优化了一个本来就不是瓶颈的地方。
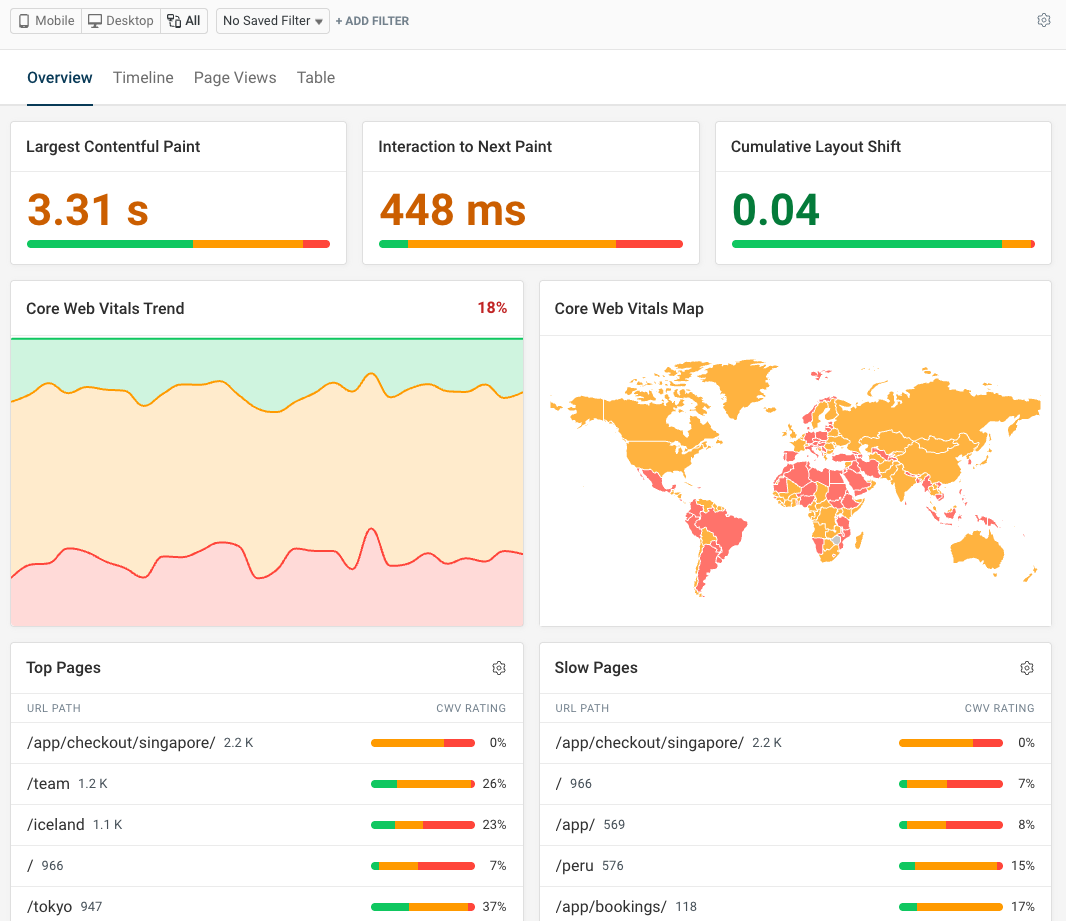
Google 的 Web Vitals 是行业通用语言,记三个核心指标就够了:LCP(最大内容绘制,首屏主要内容出现的时间,目标 < 2.5 秒)、INP(下一次绘制的交互延迟,替代了旧的 FID,目标 < 200 毫秒)、CLS(累积布局偏移,页面跳动的程度,目标 < 0.1)。LCP 管「打开快不快」,INP 管「点起来跟不跟手」,CLS 管「页面会不会乱跳」。
测量工具按场景选。Lighthouse 是起点:Chrome DevTools 里自带,跑一次给你四个维度的分数和具体优化建议,本地调试用它。注意它的分数是实验室数据——配置、网络都理想化,别把它当成线上真相。PageSpeed Insights 是同一个引擎的线上版,输入 URL 就能测,还能看到真实用户的 CrUX 数据(如果你的网站流量够大),上线前后对比用它。Vercel Speed Insights 则是持续监控:部署到 Vercel 的项目一键开启,之后每次访问的真实用户数据都会被记录,性能退化第一时间能发现。
实操建议:现在就去跑一次 Lighthouse,把 LCP、INP、CLS、首屏 JS 体积四个数字记下来,截图存档。这是你的基线。优化完再跑一次对比——没有对比数据的优化报告都是玄学。另外提醒一句:Lighthouse 跑三次取中位数,单次结果波动很大,别被某一次的异常值带偏。
第一大坑:图片,90% vibe 站点的性能杀手
经验之谈:如果你的 vibe 站点打开慢,先查图片,八成问题在这里。一张未经处理的照片,体积经常是优化后的 20 到 50 倍,而这是修复成本最低的一项。
Next.js 项目直接用 next/image,别用原生 <img>。它自动做三件事:按设备尺寸生成多套响应式图片、转成 WebP/AVIF 等现代格式、默认懒加载(首屏外的图片滑到了才加载)。用法上记住三条:永远写 width/height 或用 fill 配合父容器(防止 CLS 布局跳动),首屏大图加 priority(告诉浏览器优先加载),配一张 blur 占位图(placeholder="blur",加载前先显示模糊色块,体感好很多)。
不是 Next.js 也别慌,原理是通用的:构建时用 sharp(Node)或 squoosh 把图片批量转成 AVIF/WebP 并压缩到合理尺寸;页面上用原生懒加载 loading="lazy";给 <img> 写死宽高比。Vite 项目可以用 vite-imagetools 在构建期自动生成多尺寸版本。
三条铁律,贴在显示器上:一,永远别用 4K 原图当 hero 图——hero 图宽度超过 1920px 就是浪费,压到 1600px 宽、AVIF 格式,通常能从 8MB 干到 150KB 以内,肉眼几乎看不出区别。二,所有图片走 CDN——Cloudflare、Vercel、七牛、阿里云 OSS 都行,CDN 的边缘缓存和自动格式协商(给支持 AVIF 的浏览器发 AVIF)是白捡的性能。三,装饰性小图能用 SVG/CSS 就别用位图——图标、渐变、简单插画走 SVG,一张 PNG 省下来就是几十 KB。
别这么干:看到 Agent 生成的 <img src="/uploads/photo.jpg"> 就直接上线。先问一句:这张图多大?什么格式?首屏吗?三个问题答不上来,就先别发布。
前端 bundle 瘦身:给你的 JS 减减肥
图片修完,第二个检查的就是 JS 体积。首屏加载的 JS 越大,解析执行时间越长,手机端尤其明显——中端安卓机解析 1MB JS 要 2 到 3 秒,这段时间页面是死的。
第一步永远是先看清体积构成,而不是凭感觉删代码。Next.js 项目跑 npx next-bundle-analyzer(需先装 @next/bundle-analyzer),Vite 项目用 rollup-plugin-visualizer,构建后会生成一张可视化矩形图,哪个包最大一目了然。vibe 项目的常见大户:整包引入的组件库(只用了 Button 却打包了全套)、moment/dayjs 这类日期库(dayjs 比 moment 小一个数量级)、图表库 echarts 全量引入(按需引入能砍掉一半以上)。
找到大户之后,按这个优先级动手:一,动态 import() 拆包。首屏用不到的组件——弹窗、富文本编辑器、图表、管理后台——全部改成 const Editor = dynamic(() => import('./Editor'))(Next.js)或 defineAsyncComponent(Vue)/ React.lazy,让它们只在需要时才加载。这是见效最快的一招,经常一次砍掉 30%~50% 的首屏体积。二,检查 tree-shaking 是否生效。确认你用的是 ESM 引入(import { Button } from 'antd' 而不是整包),生产构建确认开了 minify;有些库的 CommonJS 版本会让 tree-shaking 完全失效,换 ESM 入口就能解决。三,能 CDN 引的别打包。react、vue 这种基础库,如果用了多个页面,打进每个 chunk 不如走 CDN 外链加缓存——不过这条要算账:HTTP/2 下多一个请求成本不高,但 CDN 挂了你的站也挂了,取舍自己定。
还有一个 Agent 特别爱犯的错:字体。Google Fonts 整包引入四五个字重,每个字重几百 KB。解法是字体子集化:Next.js 的 next/font 会自动做子集化和本地托管;手动方案就用 fonttools 只保留用到的字符。对中文站更狠——中文字体动辄几 MB,中文站要么用系统字体栈,要么只对标题用 webfont 且做子集化,正文用系统字体用户根本看不出区别。
量化目标:首屏 JS(gzip 后)压到 200KB 以内,200~350KB 是及格线,超过 500KB 必须动手。这是 Lighthouse 性能分上 90 的硬门槛之一。
数据层:N+1 查询长什么样,怎么修
前端瘦完身,如果接口还是慢,问题多半在数据层。先学会认出 AI 生成代码里最经典的慢查询长什么样:
坏代码(Agent 高频输出):const posts = await db.post.findMany({ take: 50 }) 然后 for (const p of posts) { p.author = await db.user.findUnique({ where: { id: p.authorId } }) }——1 次列表查询 + 50 次逐条查询,数据库被打了 51 次。这就是 N+1:1 次主查询带出 N 次附属查询。
修法按 ORM 给:Prisma 用 include: { author: true } 一次 join 查出来;Drizzle 用 relational query builder;Django 用 select_related / prefetch_related;SQLAlchemy 用 joinedload;手写 SQL 就写 JOIN。修完之后开 ORM 的查询日志看一眼,确认列表页只有 1~2 条 SQL——数 SQL 条数是验证修法的唯一标准,别信「感觉快了」。
修完 N+1 还有三板斧。第一,索引。凡是出现在 where、orderBy、join 条件里的字段,都应该有索引。Agent 建表时经常只给主键加索引,外键和查询字段全裸奔。进数据库跑 EXPLAIN 看一眼执行计划,出现全表扫描(Seq Scan / ALL)就是缺索引的信号。但也别走向另一个极端:索引会拖慢写入,读多写少的表才值得加得多。第二,分页。列表接口永远分页,默认 20 条一页,禁止 findMany() 无条件全量返回。Agent 写的后台管理页最爱一次返回全表,数据上万条直接把内存和带宽一起打爆。第三,缓存。按场景选:内容不常变用 ISR(Next.js 的增量静态再生,设置 revalidate: 60 让页面 60 秒最多重新生成一次);高频读低频写的数据加 Redis 缓存,key 设计带版本号方便失效;纯静态内容直接 CDN 缓存。记住缓存的黄金法则:先保证缓存失效策略正确,再谈缓存——缓存的是旧数据的 bug,比慢更致命。
别这么干:看到接口慢就加机器、升级数据库配置。90% 的慢接口是查询写法问题,升配只是让烂查询跑得贵一点。先 EXPLAIN,再谈钱。
AI 时代的体感优化:流式输出与 perceived performance
vibe 项目有个传统网站没有的性能场景:调 LLM 的接口。用户点一下按钮,Agent 生成的后端代码傻傻地等大模型把 2000 字全吐完,再一次性返回。用户对着转圈等 30 秒,体感比 3 秒白屏难受十倍——因为白屏至少知道「在加载」,转圈 30 秒让人怀疑「是不是卡死了」。
解法是流式输出(streaming):用 SSE(Server-Sent Events)或 fetch 的 ReadableStream,让大模型的 token 一个一个推送到前端,前端逐字渲染。OpenAI、Anthropic 的 SDK 都原生支持 stream: true;Next.js 的 AI SDK(ai 包)把这套封装成了 streamText() + useChat(),几行代码就能接上。这是 AI 应用的标配,不是加分项——2026 年的 AI 应用如果还在等完整返回才渲染,属于基础体验缺失。
流式解决了「等」的问题,还要解决「等的体感」。两招:骨架屏(skeleton)先占位——页面结构先出来,灰色块闪烁表示「内容在路上」,比白屏+转圈的 perceived performance 好得多;先给结构再填内容——比如 AI 生成报告的场景,先返回标题和章节框架流式展开,再逐段填充正文,用户在第 2 秒就能开始阅读,而不是第 30 秒才看到全文。
这套思路可以推广到所有慢操作:任何超过 1 秒的操作都要有渐进式反馈。文件上传显示进度条(别只转圈),批量处理显示「已完成 12/50」,长表单提交后按钮变 disabled 加文案。perceived performance 的本质是:用户不怕等,怕的是不知道在等什么、还要等多久。
别这么干:给 LLM 接口加个 loading 转圈就交差。转圈是 2015 年的方案,流式+骨架屏才是 AI 应用的及格线。让 Agent 重写那段「等全量返回」的代码,成本通常不超过半小时。
上线验收清单:让性能成为 feature,而不是救火
优化做完,进上线前最后一关。下面这张清单,逐项打勾再发布,建议直接贴进你的 README 或 Notion:
□ LCP < 2.5 秒、INP < 200ms、CLS < 0.1(PageSpeed Insights 移动端实测,不是 Lighthouse 实验室分数)
□ 所有图片走 CDN,且为 AVIF/WebP 格式;hero 图宽度 ≤1920px、单张 ≤200KB
□ 首屏 JS gzip 后 < 200KB(next-bundle-analyzer 或 Lighthouse 的「避免巨型网络负载」确认)
□ 列表接口全部走分页 + 关联查询一次取出(开 ORM 日志数 SQL 条数)
□ 高频读接口有缓存策略(ISR / Redis / CDN 三选一,且写清了失效规则)
□ 所有 LLM 调用走流式输出,慢操作(>1 秒)有渐进式反馈
□ 第三方脚本(统计、客服、广告)全部 async/defer 或 Partytown 丢到 web worker,禁止阻塞首屏
□ 字体只加载用到的字重,中文正文优先系统字体栈
最后一条是给工作流的建议:把性能做进 CI,而不是靠上线前突击。Lighthouse CI 跑在每次 PR 上,LCP 退化超过 0.5 秒就标红;Vercel Speed Insights 开着持续监控,线上真实用户数据一掉就告警。Agent 下次给你加功能时,顺手让它跑一遍清单——「新功能不能让 LCP 涨超过 200ms」,把这句话写进你的 AGENTS.md 或项目规范,Agent 会比你记得牢。
说到底,性能优化不是什么高深学问,它就是把「能跑」的代码里那些「反正能跑」的部分,一个一个改成「跑得讲究」。vibe coder 的优势是迭代快:测一次基线,改一处,验证一次,一下午就能让一个慢站脱胎换骨。慢不是 vibe 项目的原罪,知道慢却不去测,才是。
相关文章

公网上的每个接口都会在某个深夜被超预期调用。这篇实战为一人团队搭建限流体系:算法选型(滑动窗口 vs 令牌桶)、四层防御、AI 接口烧钱专项防护、配额设计、429 响应规范、误伤排查,最后附上线检查清单。

每个 vibe 项目都会经历同一个黑色幽默时刻:网站白屏了,朋友比你的监控先告诉你。这篇实战为一人团队搭建完整错误监控体系:5 分钟 Sentry 最小闭环、错误边界、上报上下文设计、后端结构化日志、AI 调用专项防护、告警分级降噪,最后附上线检查清单。
每个 vibe 项目迟早会遇到同一个时刻:列表页一打开就要查十几次库,并发稍高数据库就被打满。这篇实战从缓存的三问心智模型讲起,逐层拆解 HTTP 缓存头、Next.js 数据缓存、Redis 应用缓存与 AI 结果缓存(语义缓存/prompt 缓存),给出缓存键设计、穿透击穿雪崩的三件套解法和失效策略,最后附一份上线检查清单。