别让你的 AI 一本正经地编答案:vibe 项目的 RAG 问答实战
RAG 的质量 80% 决定在检索之前。本指南给一人团队一套精简过的 RAG 实战漏斗:四象限先判断你是否真需要 RAG(不够两个“是”就别用),300–512 token 递归切分打好检索地基,pgvector 默认起步,BM25+向量混合检索配 RRF(k=60)融合,拿不准才触发重排,RAGAS 四指标加 30 条黄金问答做上线门禁,生成侧靠引用标注与拒答话术防幻觉。
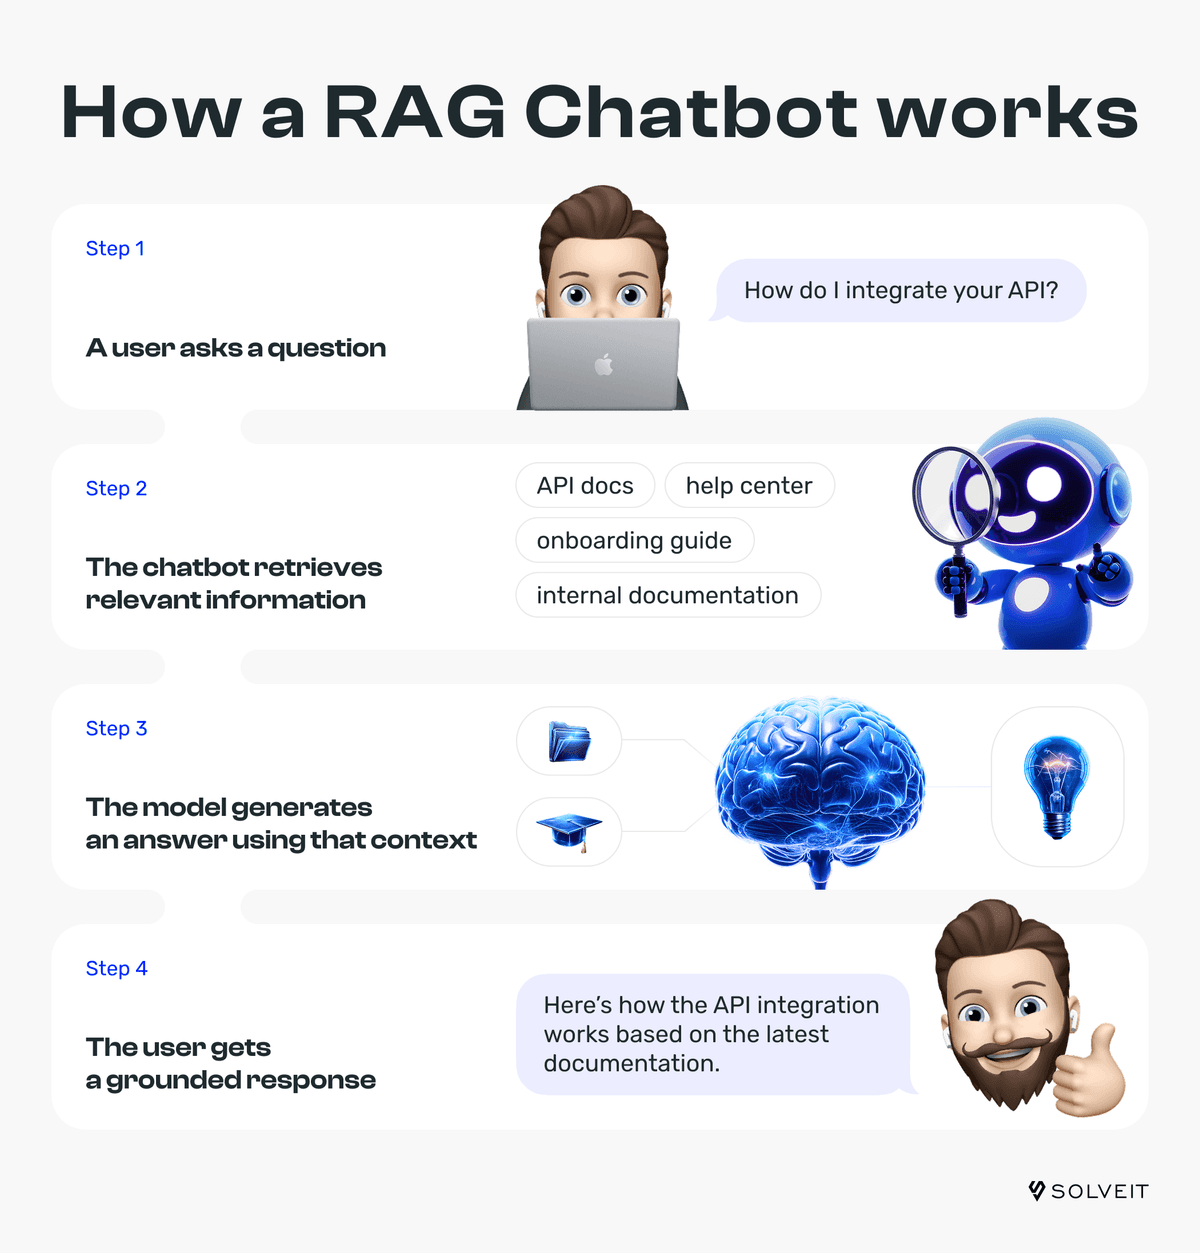
先别写代码:四象限判断你到底需不需要 RAG
做 RAG 问答之前,先回答一个扎心的问题:你真的需要 RAG 吗?到了 2026 年,RAG 已经成了"默认答案",但默认答案不等于正确答案。vibe 项目资源有限,把两周时间花在一个本可以用 50 行代码搞定的功能上,是最贵的一种浪费。
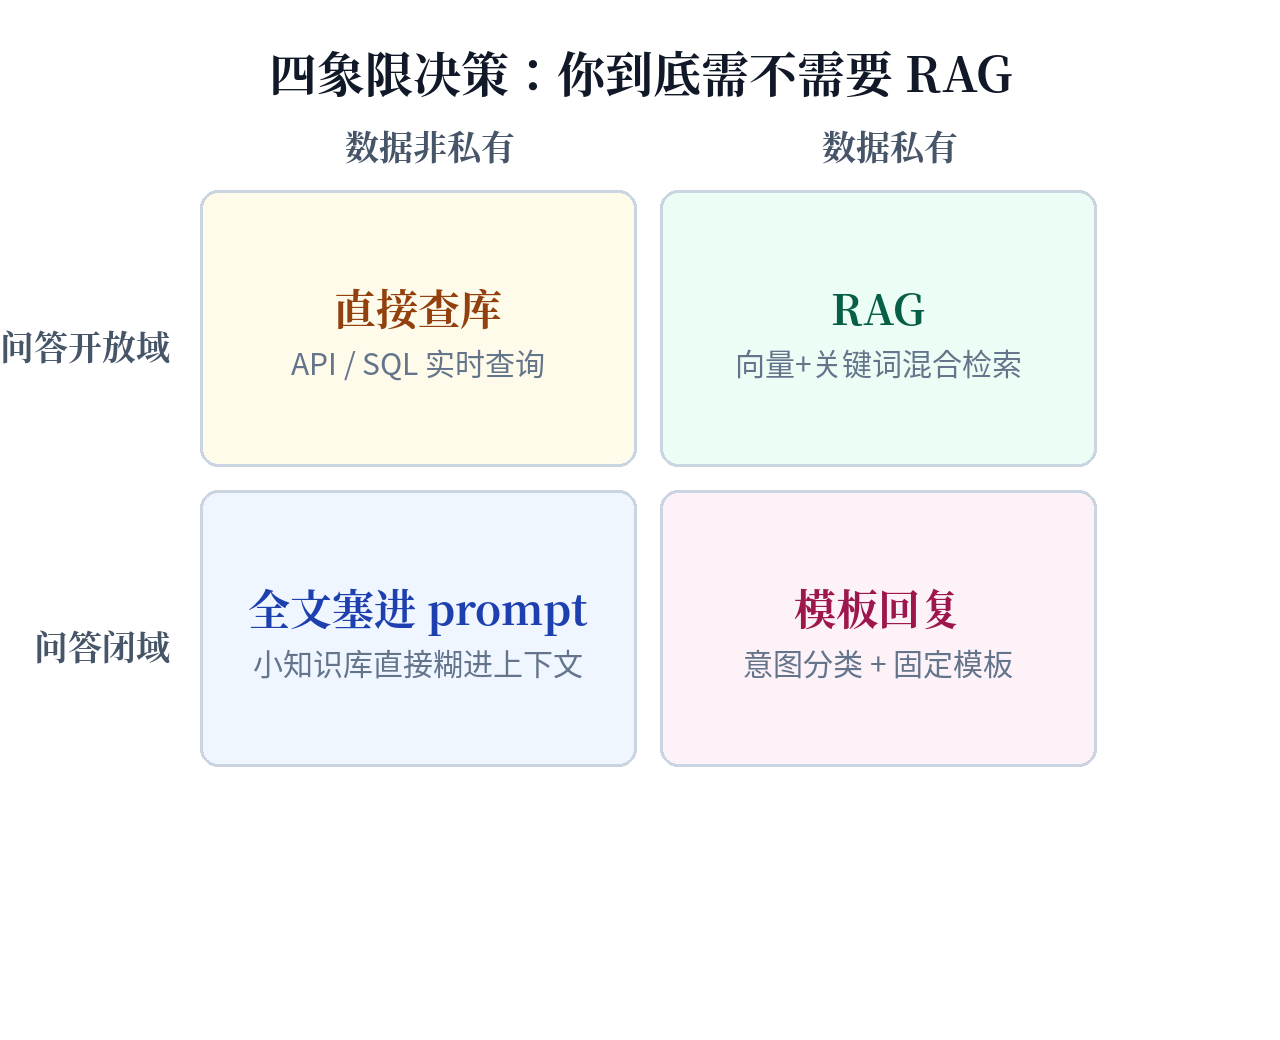
用四个问题做判断——"是"越多,越值得上 RAG:
| 问题 | 答"是"意味着什么 |
|---|---|
| 数据是私有的吗? | 模型训练时没见过,prompt 里糊不进去,只能检索 |
| 数据会高频变化吗? | 改文档比微调模型便宜得多,RAG 天生适合 |
| 答案要求可溯源吗? | 用户要看到"这句话出自哪份文档",RAG 自带引用链 |
| 问答是开放域的吗? | 用户会问你想不到的问题,FAQ 模板覆盖不了 |
四个里有三个"是",RAG 就是你的菜;有两个"是",可以上,但先看完下面的劝退清单;零到一个"是",直接关掉这篇文章——你不需要 RAG。
三种情况,我劝你别用 RAG
第一,知识库很小。几十页文档、几万字以内,直接把全文塞进 prompt 更便宜、更准、更少故障点。2026 年主流模型的上下文窗口动辄 128K 起步,你的"知识库"可能还没人家一个 system prompt 长。为了 RAG 而 RAG,是在给自己造运维负担。
第二,数据变化快到分钟级,而且用户要的是"当前值"。比如实时库存、实时价格、工单状态——这类问答的本质是"查数据库",不是"读文档"。RAG 的增量更新(切分→向量化→入库→索引刷新)天然有延迟,用它做实时查询等于拿螺丝刀钉钉子。正确做法是给模型调 API / 查 SQL,把 RAG 留给静态知识。
第三,问答是闭域的。只有二三十个固定问题(价格、退款政策、联系方式),意图分类 + 模板回复的准度和成本能把 RAG 按在地上打。别觉得"模板"low——用户要的是对的答案,不是酷的技术。
另外提一句:如果你做的是站内搜索(用户输入关键词、你返回文档列表),那不是 RAG 问答,别硬套这套漏斗。什么时候用搜索、什么时候用问答,站内这篇 vibe-project-search-guide 讲得很清楚,先分清再动手。
切分是第一生产力:检索质量 80% 死在这里
先说结论,也是全文最重要的判断:RAG 的质量 80% 决定在检索之前,而检索质量的一大半决定在切分(chunking)。向量库选型、重排模型这些"高级货",救不回一个切得稀烂的知识库。chunk 切大了,检索回来的全是噪音;切小了,答案被拦腰截断,模型只能靠编来补全——"一本正经地编答案",病根多半在这里。
起步配置:300–512 token 递归切分 + 20% 重叠
别一上来就玩语义切分(semantic chunking)。那东西成本高、效果不稳定,一人团队先不用。2026 年业内最稳妥的起步配置是:
- 块大小 300–512 token(约 2000–3500 个汉字):太小则上下文不足,太大则噪音淹没信号;这个区间是多数问答场景的甜点区。
- 递归切分:按段落 → 句子 → 词的层级往下切,优先在自然边界处断开,而不是数到 512 就一刀切。
- 20% 重叠(overlap):相邻 chunk 重叠约 20%,防止关键信息正好落在切分边界上。0% 会丢边界信息,50% 则浪费向量库容量还稀释检索精度,20% 是经验上的平衡点。
import re

def recursive_split(text, chunk_size=450, overlap=90):
"""递归切分:段落 -> 句子 -> 词,块大小约 450 token"""
paras = [p.strip() for p in text.split("\n\n") if p.strip()]
chunks, buf, buf_len = [], [], 0
for p in paras:
# 段落内再按句子切,避免超长段落撑爆 chunk
sentences = re.split(r"(?<=[。!?.!?])", p)
for s in sentences:
s_len = len(s) # 中文场景用字符数近似 token
if buf_len + s_len > chunk_size * 4 and buf:
chunks.append("".join(buf))
# 保留最后 20% 做 overlap
keep = "".join(buf)[-overlap * 4:]
buf, buf_len = [keep], len(keep)
buf.append(s)
buf_len += s_len
if buf:
chunks.append("".join(buf))
return chunks
三类内容的特殊处理:标题、表格、代码
通用切分器对付正文够用,但下面三类内容必须特殊处理,否则就是稳定的幻觉来源:
- 标题:当"前缀锚点"拼进每个 chunk。切分时把所属的一级/二级标题拼到 chunk 开头,比如
+ 正文。否则检索回来的 chunk 是一段没头没尾的文字,模型根本不知道它在回答哪个主题。 - 表格:整表一块,绝不拦腰切。表格转成 Markdown 文本块整体入库,行数太多就按"表头 + 若干行"分组,但每组都带上表头。被切断的表格是幻觉重灾区——模型会一本正经地把上下两半拼成错误结论。
- 代码:按函数/类切,别切断函数体。代码文档的切分单位应该是函数签名到函数结束,配上文件路径和函数名做前缀。把一个 for 循环切成两半喂给模型,它编出来的"用法示例"能把你气笑。
记住顺序:先把切分做对,再谈向量库。切分没做对,后面每一步都是在给垃圾做精装修。一个实用的验收办法:随机抽 20 个 chunk 人肉读一遍,如果超过 3 个让你觉得"这段话没头没尾",切分策略就得返工——机器指标再好看,也不如人眼扫一遍来得实在。
向量库选型:一人团队只有三档
向量库选型是 RAG 里最容易"过度设计"的一环。我的判断很直接:一人团队不需要第四种选择,下面三档按顺序看,命中哪档用哪档:
| pgvector | Qdrant 自托管 | Pinecone 托管 | |
|---|---|---|---|
| 适合谁 | 已经有 Postgres 的项目(Supabase 用户直接命中) | 数据量大、要自己掌控、愿意运维 | 不想碰运维、愿意为省心付费 |
| 成本 | 约等于 0(复用现有数据库) | 一台 VPS 即可起步 | 按用量计费,小规模有免费额度 |
| 混合检索 | 原生支持(tsvector 全文 + 向量同库) | 支持(稀疏+稠密向量) | 支持(2026 年已补齐稀疏向量) |
| 运维负担 | 无新增 | 要自己管备份、升级、监控 | 零 |
| 一句话建议 | 默认选它,别为选型而选型 | 百万级向量或要玩高级过滤时再搬 | 团队零运维人力且预算充足时考虑 |
划重点:如果你已经在用 Postgres(Supabase、Neon、RDS 都算),直接加 pgvector 扩展,别再引入新组件。混合检索要的 BM25 全文索引,Postgres 的 tsvector 本来就有,向量和全文在同一库里做 RRF 融合,一条 SQL 搞定(下一节给现成 SQL)。多一个组件就多一个故障点、多一份备份策略,一人团队耗不起。
索引参数别纠结:HNSW 索引用默认参数(m=16, ef_construction=64)起步,数据量没到百万级之前,调参的收益还不如多写 10 条测试问答。embedding 模型选型则建议看这篇 edge-local-inference-guide,里面有 2026 年本地 embedding 模型的实测对照——一句话结论:中文问答优先选对中文优化过的模型,别无脑用英文榜单第一名。
-- pgvector 建表示例:文档 chunk 一张表搞定
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE doc_chunks (
  id          uuid PRIMARY KEY DEFAULT gen_random_uuid(),
  doc_id      text NOT NULL,          -- 来源文档 id
  title_path  text NOT NULL,          -- 标题锚点,如"退款政策 > 未发货订单"
  content     text NOT NULL,          -- chunk 正文(含标题前缀)
  embedding   vector(1024),           -- 按你选的模型维度填
  meta        jsonb DEFAULT '{}'      -- 页码、URL、更新时间等
);
CREATE INDEX ON doc_chunks USING hnsw (embedding vector_cosine_ops);
-- 全文索引:混合检索的另一半
ALTER TABLE doc_chunks ADD COLUMN tsv tsvector
  GENERATED ALWAYS AS (to_tsvector('english', title_path || ' ' || content)) STORED;
CREATE INDEX ON doc_chunks USING gin (tsv);
混合检索:别让报错码从你指缝里溜走
纯向量检索有一个隐蔽的短板:embedding 对精确 token 不敏感。用户问"报错码 E_4031 怎么解决"、"v3.2.1 版本的 breaking change",向量检索可能给你返回一堆"语义相关但牛头不对马嘴"的文档——因为它理解的是语义相似度,而不是"这个字符串必须一字不差地出现"。产品名、报错码、版本号、人名,这类精确词恰恰是问答场景里最要命的。
2026 年生产环境的默认配置已经是混合检索:BM25(关键词精确匹配)+ 向量(语义匹配)并行召回,再用 RRF(倒数排名融合)合并结果。两路各取 top 50,RRF 按排名加权融合,k=60 是业内常用的经验值。原理不复杂:BM25 抓住精确词,向量抓住语义,RRF 让两路的结果互相纠偏。
-- Postgres 一条 SQL 做混合检索 + RRF 融合
WITH bm25 AS (
  SELECT id, ROW_NUMBER() OVER (
    ORDER BY ts_rank(tsv, plainto_tsquery('english', :query)) DESC
  ) AS rank
  FROM doc_chunks
  ORDER BY ts_rank(tsv, plainto_tsquery('english', :query)) DESC
  LIMIT 50
),
vec AS (
  SELECT id, ROW_NUMBER() OVER (
    ORDER BY embedding <=> :query_vec
  ) AS rank
  FROM doc_chunks
  ORDER BY embedding <=> :query_vec
  LIMIT 50
)
SELECT c.id, c.title_path, c.content,
       SUM(1.0 / (60 + COALESCE(b.rank, 999) )) +
       SUM(1.0 / (60 + COALESCE(v.rank, 999))) AS rrf_score
FROM doc_chunks c
LEFT JOIN bm25 b ON b.id = c.id
LEFT JOIN vec  v ON v.id = c.id
WHERE b.id IS NOT NULL OR v.id IS NOT NULL
GROUP BY c.id, c.title_path, c.content
ORDER BY rrf_score DESC
LIMIT 10;调参顺序记住一句话:先调召回,再管排序。两路各取 50–100 个候选,保证"正确答案在候选集里",这是地基;排序(重排)只是在候选集里挑顺序,是装修。地基没打好,装修得再漂亮也没用——很多"RAG 答非所问"的故障,根因都是 top-k 设得太小,正确答案根本没进候选集。
重排:只在不确定时花钱
cross-encoder 重排模型确实能提升排序精度,但它贵:每问多 100ms+ 的延迟、多一次模型调用。对一人团队,我的建议是条件重排——不是每问都重排,只在"系统拿不准"的时候触发:
- top1 分数过低:混合检索第一名的 RRF 分数低于阈值,说明候选集整体质量可疑,上重排救一把。
- top1 和 top2 差距过小:前两名分数接近,说明排序在"掷硬币",让 cross-encoder 来断案。
- 查询含精确词但 BM25 路没命中:比如用户问了报错码,但 BM25 前 50 里一个都没出现——这时候语义路的结果很可能全是噪音,重排也救不了,直接走拒答(下一节)。
def maybe_rerank(query, candidates, threshold=0.35, margin=0.08):
    """条件重排:拿不准才花钱"""
    if not candidates:
        return []
    top1, top2 = candidates[0], candidates[1] if len(candidates) > 1 else (None, 0)
    top1_score = top1["rrf_score"]
    gap = top1_score - (top2["rrf_score"] if top2 else 0)
    # 够确定:直接返回,省下 100ms+
    if top1_score >= threshold and gap >= margin:
        return candidates[:5]
    # 拿不准:上 cross-encoder 重排
    pairs = [(query, c["content"]) for c in candidates[:20]]
    scores = cross_encoder.predict(pairs)  # 精确但贵,只在此时调用
    ranked = sorted(zip(candidates[:20], scores),
                    key=lambda x: x[1], reverse=True)
    return [c for c, _ in ranked[:5]]
阈值别抄我的数字——threshold 和 margin 必须用你自己的 30 条黄金问答(第七节)调出来。每个知识库的分数分布都不一样,抄别人的阈值等于穿别人的鞋跑步。另外,如果你的库很小(几百个 chunk)且召回已经很准,干脆别上重排:复杂度是成本,省下的 100ms 和一份依赖,换来的是更少的半夜告警。
生成侧防幻觉:引用标注 + 敢拒答
检索做得再好,生成侧不设防,模型照样一本正经地编。防幻觉不靠"求模型老实",靠两套机制:引用标注(让每一句事实都有出处)和拒答(不知道就说不知道)。
引用标注:每句事实带编号
system prompt 里写死规则:模型输出的每个事实性陈述必须带引用编号 [1] [2],编号对应检索到的 chunk;没有检索支撑的句子不许写。数据结构长这样:
// 检索结果喂给模型时的标准格式
{
  "query": "未发货订单如何退款?",
  "chunks": [
    {
      "ref": 1,
      "title_path": "退款政策 > 未发货订单",
      "content": "未发货订单可在支付后 24 小时内申请全额退款…",
      "source_url": "https://docs.example.com/refund#unshipped",
      "updated_at": "2026-09-20"
    },
    {
      "ref": 2,
      "title_path": "退款政策 > 已发货订单",
      "content": "已发货订单需在签收后 7 天内申请…",
      "source_url": "https://docs.example.com/refund#shipped",
      "updated_at": "2026-09-20"
    }
  ]
}

// system prompt 关键片段(直接抄)
"你是一个客服问答助手。规则:
1. 每个事实性陈述必须标注引用编号,如 [1]、[2],编号来自上文检索结果;
2. 只能使用检索结果中的信息回答,禁止用训练知识补全;
3. 如果检索结果无法回答问题,直接说不知道,不要编造;
4. 引用编号必须真实存在,禁止虚构编号。"
引用标注还有个附带好处:用户点引用能跳到原文,信任感直接拉满。做帮助中心类产品的话,这套机制和 vibe-project-help-center-knowledge-base-guide 里讲的知识库建设是同一套东西的两面——那边讲"库怎么建",这里讲"问答怎么做"。
拒答:把"不知道"写成话术模板
很多 vibe 项目不敢做拒答,怕显得产品"笨"。恰恰相反:编一个错答案的代价,是一百次拒答都换不回来的信任。低置信度时(检索分数整体偏低、重排后 top1 仍低于阈值),直接拒答,话术模板如下:
中文模板:
"这个问题我目前的知识库里没有覆盖到,我不想编一个答案糊弄你。
你可以:1)换个问法试试;2)直接联系人工客服(附链接)。
我已经把这个问题记下来了,会尽快补充相关文档。"

英文模板:
"I don't have this covered in my knowledge base yet, and I'd rather
not guess. You can: 1) try rephrasing; 2) reach out to human support
(link). I've logged your question so we can add the docs."
拒答日志是最好的需求来源:每周看一次"用户问了但答不上来的 top 10",补文档的优先级就有了。这比任何用户调研都真实。关于"模型编答案"时的用户体验细节(loading 状态、免责声明放哪、什么时候转人工),站内那篇幻觉 UX 指南有完整讨论,这里不重复。
上线前用 RAGAS 跑一遍:四指标最小评测集
RAG 不做评测就上线,等于闭眼开车。好消息是:一人团队不需要搭学术级评测体系,RAGAS 的四个核心指标 + 30 条黄金问答,半天就能跑起来。评测方法论的通用部分(黄金数据集怎么建、回归流水线怎么做)和站内这篇 vibe-project-ai-evals-guide 是通的,那篇讲的是 AI 功能评测的通用框架,这里只讲 RAG 特有的部分。
四个指标,每个管一件事
| 指标 | 它在问什么 | 低分说明什么 |
|---|---|---|
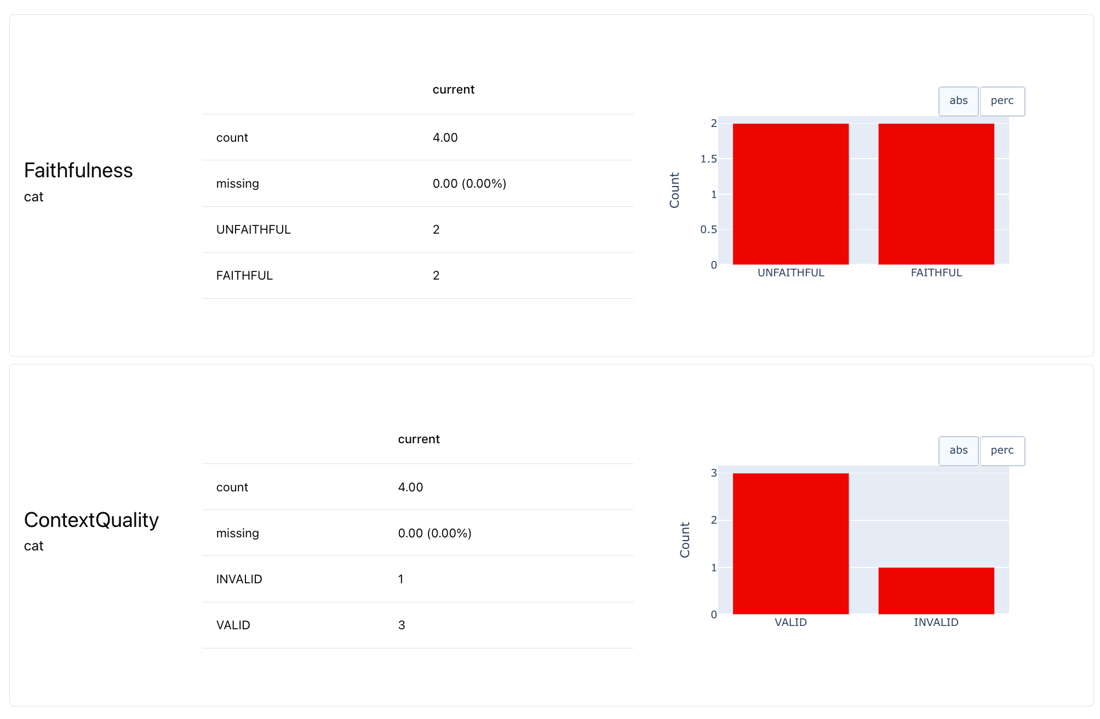
| faithfulness(忠实度) | 答案里的每句话,检索到的文档都能支撑吗? | 模型在编答案——回头查切分和引用标注 |
| context precision(上下文精度) | 检索回来的 chunk 里,有用 vs 噪音的比例? | 检索不准——调混合检索权重和 top-k |
| context recall(上下文召回) | 回答这个问题需要的文档,都被检索到了吗? | 有漏网之鱼——检查切分边界和 overlap |
| answer relevancy(答案相关性) | 答案真的在回答用户的问题吗? | 答非所问——查 query 改写和 prompt |
四个指标正好对应四阶漏斗的四个环节:哪个指标低,就去修哪个环节。这就是"漏斗"的意义——评测不是打分,是定位故障在哪一层。
30 条黄金问答:三类问题都要有
黄金问答集不用大,30 条够用,但三类问题必须覆盖:
- 可答题(15 条):知识库里明确有答案,覆盖标题/表格/代码三类内容,每条标注标准答案和出处 chunk。
- 拒答题(10 条):知识库里没有答案,期望行为是触发拒答话术而不是编答案。这是防幻觉的底线测试。
- 边界题(5 条):答案在文档里但表述刁钻(比如问的是表格里第三行的数据、问的是"除了 A 之外还有什么"),测检索和生成的鲁棒性。
# 黄金问答条目模板(golden_qa.jsonl,一行一条)
{
  "id": "qa-001",
  "type": "answerable",          // answerable | refusal | edge
  "question": "未发货订单如何申请退款?",
  "expected_answer": "支付后 24 小时内可申请全额退款…",
  "expected_refs": ["chunk-uuid-1"],
  "notes": "答案在'退款政策 > 未发货订单'chunk"
}

# RAGAS 评测最小集(伪代码,按官方文档装 ragas 即用)
from ragas import evaluate
from ragas.metrics import faithfulness, context_precision, context_recall, answer_relevancy

results = evaluate(
    dataset=your_golden_dataset,  # 30 条黄金问答跑出的 question/contexts/answer
    metrics=[faithfulness, context_precision, context_recall, answer_relevancy],
)
print(results) # 哪个指标低,就去修漏斗的哪一层上线门禁就一条:faithfulness 低于你自己的基线,不许上线。注意是"你自己的基线"——第一次跑出来的分数就是基线,以后每次改切分、换模型、调 prompt 都重跑,分数掉了就回滚。别去抄网上"faithfulness 要到 0.9"的说法,不同知识库、不同问题分布下分数不可比,抄别人的阈值没有意义。
收敛:四阶漏斗 checklist
最后把全文收敛成一张上线前 checklist,贴在你的项目文档里:
- 切分:300–512 token 递归切分、20% overlap;标题做前缀锚点、表格整表入库、代码按函数切。
- 混合检索:BM25 + 向量并行召回各 50–100,RRF(k=60)融合;先保证召回,再谈排序。
- 重排:条件触发,不每问都跑;阈值用自己的黄金问答调出来,别抄。
- 评测:RAGAS 四指标 + 30 条黄金问答(三类覆盖);faithfulness 低于基线不许上线。
- 生成侧:引用标注写进 system prompt;低置信度走拒答话术;拒答日志每周复盘一次。
以及全文最重要的两句判断,再重复一遍:RAG 的质量 80% 决定在检索之前;四个象限里"是否"不够两个,别用 RAG。技术选型上最大的成本不是选错,而是为不需要的东西付出运维代价。
相关阅读:Agent 的记忆系统和文档 RAG 经常被混为一谈,但它们的检索对象、更新频率、一致性要求完全不同,边界划分看 agent-memory-system-design;想进一步争论"记忆到底是不是 RAG",可以看看 Kevin Liao 那篇引发讨论的观点 agent-memory-debate-kevin-liao-hn-october-2026,正反方对照着读会有启发。
评论 (0)
相关文章
只要 vibe 项目有用户能写字的地方,你就得做审核——但审核不是删帖,是分级处置。本指南先画三类风险地图(传统 UGC、用户可发布内容、AI 生成输出),再搭三层漏斗:机器做 90%(关键词+AI 审核 API),用户举报当传感器(30 秒表单+分级 SLA),你每周只花 30 分钟处理 1% 的难案。附一页纸社区准则模板、防 prompt 注入三道防线、灾难熔断三档开关,一人团队直接照抄。
AI coding 时代,密钥泄露不再靠人手滑——AI 会主动把 key 写进代码、注释、commit 里并 push。本指南给 vibe coder 一套凭据五态管理框架(生成→存储→使用→轮换→泄露应急),全部可直接抄走:.env 分层与预提交钩子、生产密钥托管选型、AGENTS.md 三条红线、第三方 key 最小权限、30 分钟泄露止血 SOP,以及每月 5 分钟巡检清单。
10 月 Copilot 两天退役 10 个模型、GPT-5.5 从 Codex 退役、OpenAI API 关停 17 个模型标识——换模型已从技术升级变成运营常态。这篇实战指南给出完整换芯 SOP:三层抽象设计、30 分钟最小 eval 基线、影子到全量的灰度四步、每周 10 分钟公告监控、换芯真实成本公式、三种翻车模式,以及一页纸可复制 checklist。